


軽量プロキシを試してみて、透明な価格設定、マルチプロバイダーの回復力、そして運用負担の軽減が必要になった場合、あなたはおそらく探しているでしょう LiteLLMの代替案. 。このガイドでは、チームが実際に評価するツールを比較します—シェアAI (はい、#1の選択です)、 エデンAI, ポートキー, コングAIゲートウェイ, ORQ AI, 統一, 、そして オープンルーター—そして、それぞれがどのような場合に適しているかを説明します。評価基準、価格/TCO、LiteLLMからShareAIへの移行計画をコピー&ペースト可能なAPI例とともにカバーします。
9. 成功を定義し、小さな評価セットを構築し、実際のトラフィックでA/Bテストを行い、機能ごとに決定します。ShareAIを使用して候補をルーティングし、 選択する シェアAI 多くのプロバイダーにわたる1つのAPI、透明なマーケットプレイス(価格、レイテンシー、稼働時間、可用性、プロバイダータイプ)、そして即時フェイルオーバーを望む場合—支出の70%がモデルをオンラインに保つ人々に向かいます。それはPeople-Powered AI APIです。
関連性のために更新 — 2026年9月
代替案の状況は急速に変化します。このページは意思決定者がノイズを切り抜けるのを助けます:アグリゲーターがゲートウェイと何をするのかを理解し、現実世界のトレードオフを比較し、数分でテストを開始します。
文脈でのLiteLLM:アグリゲーター、ゲートウェイ、またはオーケストレーション?
LiteLLM 多くのプロバイダーにわたるOpenAI互換のインターフェースを提供し、小規模なプロキシ/ゲートウェイとして動作することができます。迅速な実験や、自分たちでシムを管理することを好むチームに最適です。ワークロードが増加するにつれて、チームは通常、より多くを求めます:マーケットプレイスの透明性(価格/レイテンシー/稼働時間 前に ルーティング)、より多くのインフラをオンラインに保つことなく回復力、そしてプロジェクト全体のガバナンス。
アグリゲーター: ルーティング/フェイルオーバーと価格/レイテンシーの可視性を備えた多くのモデル/プロバイダーにわたる1つのAPI。
ゲートウェイ: セキュリティとガバナンスのためのエッジでのポリシー/分析(BYOプロバイダー)。
オーケストレーション: チーム間で実験から本番環境への移行を可能にするワークフロービルダー。
LiteLLMの代替案を評価した方法
- モデルの幅広さと中立性 — 書き換えなしのオープン+ベンダーモデル。
- レイテンシーとレジリエンス — ルーティングポリシー、タイムアウト/リトライ、即時フェイルオーバー。
- ガバナンスとセキュリティ — キー管理、アクセス境界、プライバシー姿勢。
- 可観測性 — ログ、トレース、コスト/レイテンシーダッシュボード。
- 価格の透明性とTCO — トラフィックを送信する前に価格/レイテンシー/稼働時間/可用性を確認。
- 開発者体験 — ドキュメント、クイックスタート、SDK、プレイグラウンド;最初のトークンまでの時間。
- ネットワーク経済 — あなたの支出は供給を増やすべきです;ShareAIは70%をプロバイダーにルーティングします。
#1 — ShareAI(人々が支えるAI API)
シェアAI は、人々が支えるマルチプロバイダーAI APIです。1つのRESTエンドポイントで、複数のプロバイダーにわたる150以上のモデルを実行し、比較できます。 価格、可用性、レイテンシー、稼働時間、プロバイダータイプ, 、パフォーマンスまたはコストに基づいてルーティングし、プロバイダーが劣化した場合は即座にフェイルオーバーします。それはベンダーに依存せず、トークンごとの支払い方式です—1ドルのうち70% モデルをオンラインに保つコミュニティ/会社のGPUに戻ります。
- モデルを閲覧: モデルマーケットプレイス
- プレイグラウンドを開く: プレイグラウンドで試す
- APIキーを作成: 資格情報を生成
- APIリファレンス (クイックスタート): APIを使い始める
LiteLLMのようなDIYプロキシよりもShareAIを選ぶ理由
- 透明なマーケットプレイス: 価格/遅延/可用性/稼働時間を確認し、呼び出しごとに最適なルートを選択。
- 追加の運用なしの回復力: 即時フェイルオーバーとポリシーベースのルーティング—プロキシフリートの維持不要。
- 人々による経済: あなたの支出は必要な場所で容量を増やし、70%がプロバイダーに渡ります。
- 書き換えなし: 150以上のモデルに対する1つの統合; プロバイダーを自由に切り替え可能。
クイックスタート(コピー&ペースト)
# Bash / cURL — Chat Completions
# Prerequisite:
#   export SHAREAI_API_KEY="YOUR_KEY"

curl -X POST "https://api.shareai.now/v1/chat/completions" \
  -H "Authorization: Bearer $SHAREAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-70b",
    "messages": [
      { "role": "user", "content": "Explain how ShareAI routing improves reliability in production." }
    ],
    "temperature": 0.3,
    "max_tokens": 128
  }'
// JavaScript (Node 18+ / Edge) — Chat Completions
const API_KEY = process.env.SHAREAI_API_KEY;
const URL = "https://api.shareai.now/v1/chat/completions";

const payload = {
  model: "llama-3.1-70b",
  messages: [
    { role: "user", content: "Explain how ShareAI routing improves reliability in production." }
  ],
  temperature: 0.3,
  max_tokens: 128
};

const res = await fetch(URL, {
  method: "POST",
  headers: {
    "Authorization": `Bearer ${API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify(payload)
});

const data = await res.json();
console.log(JSON.stringify(data, null, 2));
# Python (requests) — Chat Completions
# pip install requests
import os
import json
import requests

API_KEY = os.getenv("SHAREAI_API_KEY")
URL = "https://api.shareai.now/v1/chat/completions"

payload = {
  "model": "llama-3.1-70b",
  "messages": [
    { "role": "user", "content": "Explain how ShareAI routing improves reliability in production." }
  ],
  "temperature": 0.3,
  "max_tokens": 128
}

headers = {
  "Authorization": f"Bearer {API_KEY}",
  "Content-Type": "application/json"
}

resp = requests.post(URL, headers=headers, json=payload, timeout=30)
print(resp.status_code)
print(json.dumps(resp.json(), indent=2))
// JavaScript (Node 18+ / Edge) — チャット補完
# Python (requests) — チャット補完 # pip install requests プロバイダー向け: モデルをオンラインで維持することで誰でも収益を得ることができます.
ShareAIはオープンサプライです:
誰でもプロバイダーになることができます.
エデンAI
それが何か: (コミュニティまたは企業)。Windows、Ubuntu、macOS、Docker向けのオンボーディングアプリが存在します。アイドルタイムのバーストを提供するか、常時稼働を選択できます。インセンティブには報酬(収益を得る)、交換(推論に使用するトークンを獲得する)、ミッション(NGOに%を寄付する)が含まれます。スケールアップするにつれて、独自の推論価格を設定し、優先的な露出を得ることができます。
適している用途: LiteLLMの最良の代替案(完全なリスト).
トレードオフ: 以下は、チームがLiteLLMと併せて、または代わりに評価することが多いプラットフォームです。詳細については、Eden AIのLiteLLM代替案の概要をご覧ください。
ポートキー
それが何か: LLMだけでなく、その他のサービス(画像生成、翻訳、TTSなど)をカバーするAIアグリゲーター。キャッシング、フォールバックプロバイダー、スループット向けのバッチ処理オプションを提供します。
適している用途: テキストLLMを超えたマルチモーダルAIにアクセスするための単一の場所。
トレードオフ: 主にコントロールプレーン—プロバイダーは引き続き自分で用意します。透明なプロバイダー選択と運用負荷のない回復力が最優先の場合、ShareAIはよりシンプルです。
コングAIゲートウェイ
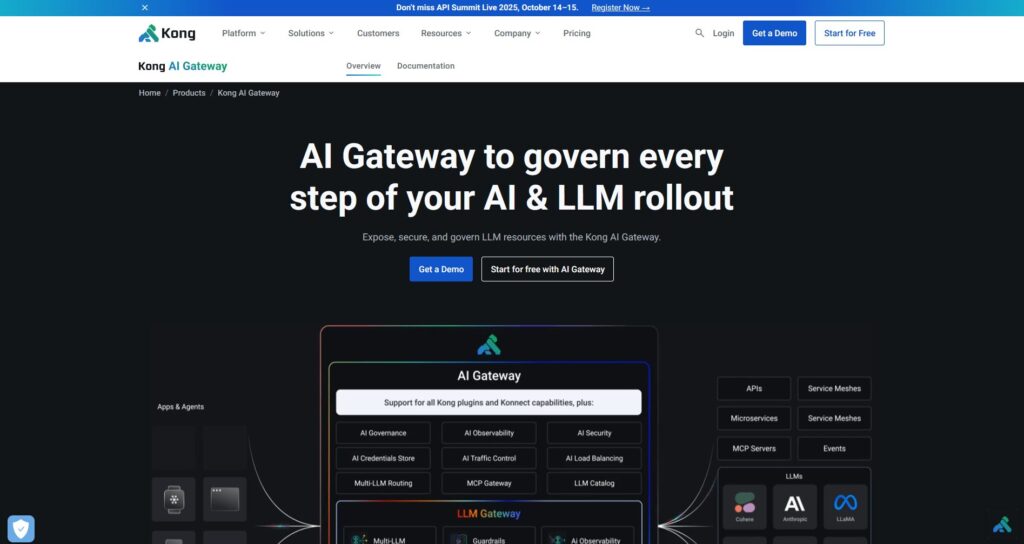
それが何か: KongのAI/LLMゲートウェイはエッジでのガバナンス(ポリシー、プラグイン、分析)に焦点を当てており、既存のKongデプロイメントと併用されることがよくあります。
適している用途: 特にKongに既に投資している場合、AIトラフィック全体のコントロールを標準化する企業。
トレードオフ: マーケットプレイスではありません。プロバイダーはBYO(Bring Your Own)。明示的なプロバイダー選択とマルチプロバイダーの回復力が依然として必要です。
ORQ AI
それが何か: 実験から本番環境への移行を低コードフローで実現するためのオーケストレーションとコラボレーションツール。
適している用途: ワークフローのオーケストレーションと共同作業の構築環境を必要とするスタートアップ/中小企業。
トレードオフ: マーケットプレイスの透明性やプロバイダーレベルの経済性は軽め—ルーティング層ではShareAIと相性が良いです。
統一
それが何か: プロンプトごとにより強力なモデルを選択するためのパフォーマンス指向のルーティングと評価ツール。
適している用途: モデル間でのプロンプトの品質重視のルーティングと定期的な評価を重視するチーム。
トレードオフ: 評価に関してより意見が明確で、プロバイダー経済性を事前に公開するマーケットプレイスが主目的ではありません。
オープンルーター
それが何か: 多くのモデルをカバーする単一のAPIで、リクエスト/レスポンスパターンが馴染み深く、迅速な実験に人気です。
適している用途: 1つのキーで迅速なマルチモデル試行。
トレードオフ: エンタープライズガバナンスや価格/遅延/稼働時間を呼び出し前に表示するマーケットプレイスの仕組みにはあまり重点を置いていません。
LiteLLM vs ShareAI vs その他 — 簡易比較
| プラットフォーム | 対象者 | モデルの幅広さ | ガバナンス | 可観測性 | ルーティング / フェイルオーバー | マーケットプレイスの透明性 | プロバイダープログラム |
|---|---|---|---|---|---|---|---|
| シェアAI | 1つのAPI + 公正な経済性を求めるプロダクト/プラットフォームチーム | 150以上のモデル プロバイダー間 | APIキー & ルートごとのコントロール | コンソール使用 + マーケットプレイス統計 | スマートルーティング + 即時フェイルオーバー | はい (価格、遅延、稼働時間、可用性、タイプ) | はい — オープンサプライ; 70% プロバイダーへ |
| LiteLLM | 自己ホスト型プロキシを好むチーム | 多くはOpenAI形式を通じて | 設定/制限 | DIY | 再試行/フォールバック | 該当なし | 該当なし |
| エデンAI | LLM + 他のAIサービスを必要とするチーム | 幅広いマルチサービス | 標準API | 変動する | フォールバック/キャッシング | 部分的 | 該当なし |
| ポートキー | 規制/エンタープライズ | 幅広い(BYO) | 強力な ガードレール | 深いトレース | 条件付きルーティング | 該当なし | 該当なし |
| コングAIゲートウェイ | Kongを使用する企業 | BYOプロバイダー | 強力な エッジポリシー | 分析 | プロキシ/プラグイン | いいえ | 該当なし |
| ORQ | オーケストレーションを必要とするチーム | 幅広いサポート | プラットフォーム制御 | プラットフォーム分析 | ワークフロー・レベル | 該当なし | 該当なし |
| 統一 | 品質重視のルーティング | マルチモデル | 標準 | プラットフォーム分析 | 最適モデル選択 | 該当なし | 該当なし |
| オープンルーター | 1つのキーを求める開発者 | 幅広いカタログ | 基本的なコントロール | アプリ側 | フォールバック/ルーティング | 部分的 | 該当なし |
テーブルを読む: 「マーケットプレイスの透明性」が尋ねる、 トラフィックを送信する前に価格/遅延/稼働時間/可用性を確認し、ルートを選択できますか? ShareAIはデフォルトで「はい」と答えるように設計されています。
価格とTCO: $/1Kトークンを超えて考える
単価は重要ですが、実際のコストにはリトライ/フォールバック、遅延によるUX効果(トークン使用量の変化)、地域/インフラによるプロバイダーの差異、観測可能性ストレージ、評価実行が含まれます。マーケットプレイスはこれらのトレードオフを明確にバランスさせるのに役立ちます。
TCO ≈ Σ (Base_tokens × Unit_price × (1 + Retry_rate)) + Observability_storage + Evaluation_tokens + Egress プロトタイプ (10kトークン/日): 最初のトークンまでの時間を優先 (Playground + Quickstart)、その後ポリシーを強化。
中規模製品 (2Mトークン/日、3モデルにわたる): マーケットプレイスガイドのルーティングは支出を削減しUXを改善できます; 低遅延プロバイダーへのルート切り替えは会話ターンとトークン使用量を減少させる可能性があります。
スパイク型ワークロード: フェイルオーバー中のリトライによる若干高い実効トークンコストを予期; 予算を計画—スマートルーティングはダウンタイムコストを削減します。
ShareAIが役立つ場所: 明確な価格と遅延の可視性、即時フェイルオーバー、人力供給 (70%からプロバイダーへ) は信頼性と長期的な効率性を向上させます。
移行: LiteLLM → ShareAI (シャドウ → カナリア → カットオーバー)
- 在庫とモデルのマッピング: プロキシを呼び出すルートをリスト化し、モデル名をShareAIのカタログにマッピングし、地域/遅延の好みを決定します。
- プロンプトの整合性とガードレール: 代表的なプロンプトセットを再生し、最大トークン数と価格上限を強制します。
- シャドウ、次にカナリア: シャドウトラフィックから開始し、応答が良好であれば、10% → 25% → 50% → 100%でカナリアを実行します。
- 必要に応じてハイブリッド: 開発にはLiteLLMを使用しながら、ShareAIを使用して本番ルーティング/マーケットプレイスの透明性を確保します。または、組織全体のポリシーにお気に入りのゲートウェイを組み合わせ、ShareAIをプロバイダー選択とフェイルオーバーに使用します。
- 検証とクリーンアップ: SLAを最終確定し、ランブックを更新し、不要なプロキシノードを廃止します。
セキュリティ、プライバシー、コンプライアンスチェックリスト
- キーの取り扱い: ローテーションの頻度;スコープされたトークン;環境ごとの分離。
- データ保持: プロンプト/応答がどこに保存されるか;保存期間;編集コントロール。
- PIIおよび機密コンテンツ: マスキング戦略;アクセスコントロール;データの地域性を考慮したルーティング。
- 可観測性: 記録する内容を必要に応じてフィルタリングまたは仮名化します。
- インシデント対応: SLA、エスカレーションパス、監査証跡。
開発者体験を提供する
- 最初のトークンまでの時間: ライブリクエストを実行する プレイグラウンド, 、次に以下を介して統合する APIリファレンス—数時間ではなく数分で。
- マーケットプレイスの発見: 価格、遅延、可用性、稼働時間を比較する モデルページ.
- アカウントと認証: サインインまたはサインアップ キー、使用状況、請求を管理するために。
FAQ:
LiteLLMはアグリゲーターですか、それともゲートウェイですか?
それは、プロバイダー間でOpenAI互換のリクエストを処理するSDK + プロキシ/ゲートウェイとして説明するのが最適です—ルーティング前にプロバイダーのトレードオフを選択できるマーケットプレイスとは異なります。
エンタープライズガバナンスに最適なLiteLLMの代替案は何ですか?
ゲートウェイスタイルのコントロール(Kong AI Gateway、Portkey)は、ポリシーとテレメトリーに優れています。透明なプロバイダー選択と即時フェイルオーバーも望む場合は、ガバナンスをShareAIのマーケットプレイスルーティングと組み合わせてください。
マルチプロバイダーのルーティングにおけるLiteLLMとShareAIの比較は?
ShareAI、プロキシを実行せずにルーティングとフェイルオーバーを行いたい場合、さらにマーケットプレイスの透明性と支出の70%がプロバイダーに流れるモデルを提供します。
誰でもShareAIプロバイダーになることができますか?
はい—コミュニティまたは企業のプロバイダーは、デスクトップアプリやDockerを介してオンボードし、アイドルタイムまたは常時稼働の容量を提供し、リワード/エクスチェンジ/ミッションを選択し、スケールに応じて価格を設定できます。
次に進む場所
プレイグラウンドを試してみてください
数分で任意のモデルにライブリクエストを実行.
1つのAPI。150以上のAIモデル。スマートルーティングと即時フェイルオーバー。70%からGPUへ。