


更新日 2026年9月
開発者が選ぶ ルートLLM プロンプトをより安価なモデルにルーティングしながら、GPT-4に近い品質を目指します—特に、学習されたルーターが自信を持ってダウングレードできるベンチマークのようなタスクにおいて。 しかし、もしあなたがより重要視するのが 各ルート前のマーケットプレイスの透明性 (ライブ価格、レイテンシー、稼働時間、可用性)であれば、 複数のプロバイダー間での即時フェイルオーバー, エッジポリシーと監査, 、または 自己ホスト型プロキシ/ゲートウェイ, 、これらのうちの一つ RouteLLMの代替案 があなたのスタックにより適しているかもしれません。
この購入者ガイドは、ビルダーの視点で書かれています:具体的なトレードオフ、迅速な選択、詳細な分析、並列比較、そして今日出荷できるようにするためのコピーペースト可能なShareAIクイックスタート。
RouteLLMの理解(および適さない場合)
RouteLLMとは何か。 RouteLLMは、LLMルーターを提供および評価するためのオープンソースフレームワークです。OpenAI互換のクライアント/サーバーをそのまま利用でき、より単純なクエリをより安価なモデルにルーティングできるトレーニング済みのルーティングモデルを提供します—一般的なベンチマーク(例:MT-Bench)でGPT-4の性能の約95%を維持しながら、最大85%のコスト削減が報告されています。
チームがそれを選ぶ理由。
- コストを考慮したルーティング 研究に基づいたポリシーを使用。
- オープンソース そしてPythonで拡張可能。
- OpenAI互換 重いSDKの書き換えなしで試験的なルーティングを行うための道筋。
RouteLLMが適さない場合。
- あなたが望むのは ライブマーケットプレイスの透明性 各ルートの前に(価格、遅延、稼働時間、可用性)— 単なる学習ポリシーではなく。
- あなたが必要なのは マルチプロバイダーフェイルオーバー
- あなたのロードマップは広がります マルチモーダルAPI OCR、音声、翻訳、ドキュメント解析を一つのプラットフォームで。
RouteLLMの代替を選ぶ方法
- 総所有コスト(TCO)。 $/1Kトークンで止まらないでください。キャッシュヒット率、リトライ/フォールバック、キューイング、評価コスト、ログ/アラートの運用負担を数えましょう。セマンティックキャッシュを備えたキャッシュ対応ルーターとゲートウェイは、「より高価なリスト価格」を実際には安くすることができます。
- レイテンシーと信頼性。 リージョン対応のルーティング、キャッシュが温かいときのプロバイダーの粘着性、正確なフォールバック(429のリトライ、タイムアウト時のエスカレーション)を優先してください。ホスト型ルーターは、ウォームコンテキストで同じプロバイダーを維持し、プロバイダーが一時的に停止した場合にフォールバックする傾向があります。
- 可観測性とガバナンス。 ガードレール、編集、監査ログ、エッジでのポリシーが重要であれば、AIゲートウェイ(PortkeyまたはKong AI Gateway)は純粋なルーター単体よりも通常強力です。多くのチームはルーターとゲートウェイを組み合わせています。
- 自己ホスト vs. マネージド。 Docker/K8s/HelmとOpenAI互換プロキシを好みますか?LiteLLMを試してください。ホスト型のスピードとマーケットプレイスの可視性が必要ですか?ShareAIまたはOpenRouterを検討してください。
- チャットを超えた広がり。 LLMチャットと一緒にOCR、音声、翻訳、またはドキュメント解析が必要な場合は、Eden AIのようなマルチモーダルオーケストレーターが役立ちます。
- データ駆動型ルーティング。 地域やワークロードによるコスト/速度/品質を調整するためにライブベンチマークを好む場合は、Unifyを評価してください。
ベストなRouteLLMの代替案(クイックピック)
ShareAI (市場の透明性 + ビルダー経済学における私たちの選択)
大規模なモデル/プロバイダーのカタログを横断する1つのAPI、即時フェイルオーバーと市場の可視化を備えています。 価格、遅延、稼働時間、可用性 ルーティングする前に。迅速に開始する プレイグラウンド, 、キーを取得して コンソール, 、閲覧する ドキュメント, 、そして比較する モデル.
Eden AI (マルチモーダルオーケストレーター)
LLM間の統一API に加えて 画像、OCR/文書解析、音声、翻訳—モデル比較、監視、キャッシュ、バッチ処理と併せて。
OpenRouter (キャッシュ対応ルーティング)
多くのLLMを横断するホスト型ルーターで、プロンプトキャッシュとプロバイダーの粘着性によりウォームコンテキストを再利用します。プロバイダーが利用できない場合はフォールバックします。
Portkey (ゲートウェイでのポリシー & SRE運用)
プログラム可能なフォールバック、レート制限プレイブック、セマンティックキャッシュを備えたAIゲートウェイ—さらに、詳細なトレース/メトリクスで本番制御を提供します。
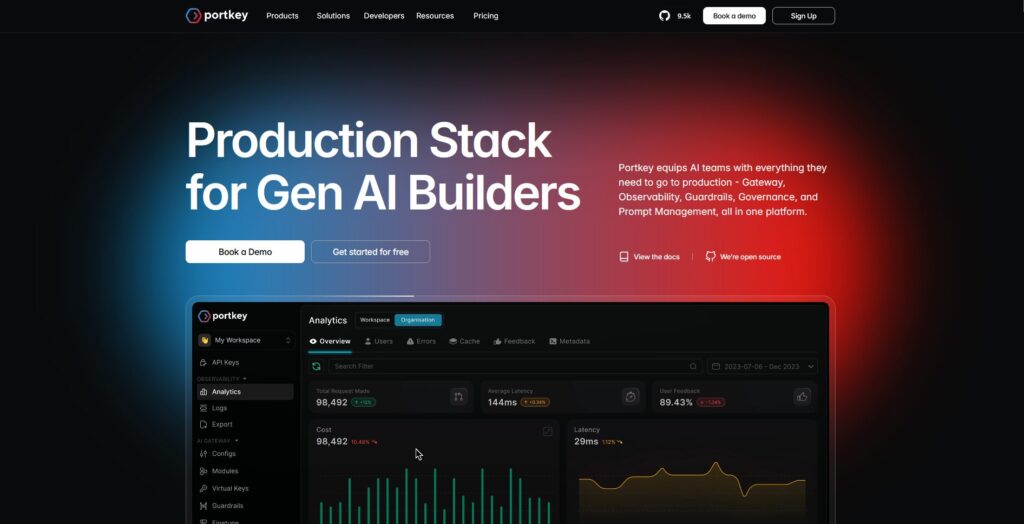
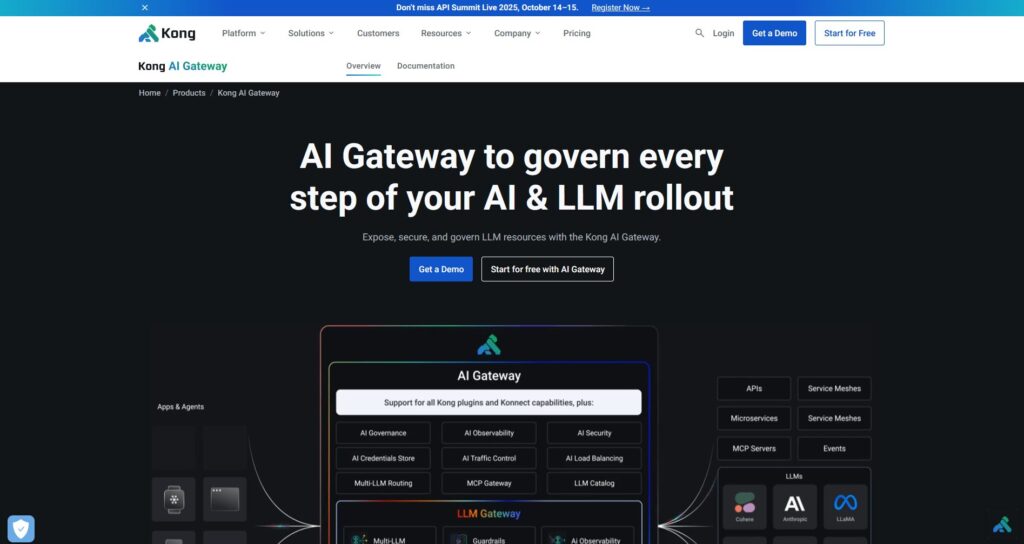
Kong AI Gateway (エッジガバナンス & 監査)
KongエコシステムにAIプラグイン、ポリシー、分析を導入します。チーム間で集中管理されたエッジコントロールが必要な場合に最適です。
Unify(データ駆動型ルーター)
地域とワークロードによるコスト/速度/品質を最適化するためのライブベンチマークを備えたユニバーサルAPI。
Orq.ai(実験&LLMOps)
実験、評価(RAGメトリクスを含む)、デプロイメント、RBAC/VPC—評価とガバナンスを統合する必要がある場合に最適です。
LiteLLM(セルフホスト型プロキシ/ゲートウェイ)
予算/制限、ログ/メトリクス、管理UIを備えたオープンソース、OpenAI互換プロキシ。Docker/K8s/Helmでデプロイ可能。運用はあなたが管理します。
詳細分析: RouteLLMの主要な代替案
ShareAI(人々が支えるAI API)
それが何であるか。 プロバイダー優先のAIネットワークと統一API。多数のモデル/プロバイダーのカタログを閲覧し、即時フェイルオーバーでルート設定。マーケットプレイスでは価格、レイテンシー、稼働時間、利用可能性を一括表示し、各ルート前に最適なプロバイダーを選択できます。開始は プレイグラウンド, で始め、 コンソール, 、そしてAPIクイックスタートに従ってください ドキュメント. 。以下を閲覧してください モデルマーケットプレイス.
- マーケットプレイスの透明性 —価格/レイテンシー/稼働時間/利用可能性を事前に確認できます。
- デフォルトでのレジリエンス —プロバイダーが一時停止した際に次の最適なプロバイダーへ迅速にフェイルオーバーします。
- ビルダーに合わせた経済性 — 支出の大部分がモデルをオンラインに保つGPUプロバイダーに流れる。
- 摩擦のないスタート —Playgroundでテストし、その後出荷します。
プロバイダーファクト(モデルをオンラインに保つことで収益を得る)。 誰でもプロバイダーになることができます(コミュニティまたは企業)。Windows/Ubuntu/macOSまたはDockerを介してオンボード可能。アイドルタイムのバーストを提供するか、常時稼働を選択できます。インセンティブを選択: 報酬(お金)、交換(トークン/AIプロシューマー)、またはミッション(NGOに%を寄付)。以下を参照してください プロバイダーガイド または開いてください 10. プロバイダーダッシュボードを通じて.
理想的な用途:. ベンダーロックインなしで、マーケットプレイスの透明性、回復力、プロバイダーモードへの成長の余地を求めるプロダクトチーム。
エデンAI
それが何であるか。 複数のベンダーSDKを統合する必要がないように、LLM + 画像生成 + OCR/ドキュメント解析 + 音声 + 翻訳を網羅する統一API。また、モデル比較、モニタリング、バッチ処理を重視しています。
適している場合。 あなたのロードマップはマルチモーダルであり、LLMチャットと並行してOCR/音声/翻訳をオーケストレーションしたいと考えています。
注意点。 必要な場合は リクエストごとのマーケットプレイスビュー (価格/レイテンシ/稼働時間/可用性)またはプロバイダーレベルの経済性において、ShareAIのようなマーケットプレイスルーターを組み合わせます。
オープンルーター
それが何であるか。 プロバイダー/モデルルーティングを備えた統一LLMルーター。 プロンプトキャッシング. キャッシュが有効になっている場合、OpenRouterは同じプロバイダーを使用してウォームコンテキストを再利用する傾向があります。そのプロバイダーが利用できない場合はフォールバックします。また、戦略ヒント(例:価格重視)もサポートしています。
適している場合。 ホストされたスピードとキャッシュ対応ルーティングを活用してコストを削減しスループットを向上させたい—特に高QPSチャットワークロードで繰り返しプロンプトがある場合に。
注意点。 深いエンタープライズガバナンス(SIEMエクスポート、組織全体のポリシー)のために、多くのチームがOpenRouterをPortkeyやKong AI Gatewayと組み合わせています。
ポートキー
それが何であるか。 プログラム可能なフォールバック、レート制限プレイブック、シンプル/セマンティックキャッシュ、さらにSREスタイルの制御のためのトレース/メトリクスを備えたAIゲートウェイ。セマンティックキャッシュは、類似性の閾値が適切に調整されている場合、短いプロンプト/メッセージに特に役立ちます。
適している場合。 一流の可観測性を備えたポリシー駆動型ルーティングが必要で、1つ以上のルーター/マーケットプレイスの前にゲートウェイレイヤーを運用することに慣れている場合。
コングAIゲートウェイ
それが何であるか。 AIプラグイン、ポリシー、分析をKongエコシステム(Konnectまたはセルフマネージド経由)に統合するエッジゲートウェイ。APIプラットフォームがすでにKongを中心に構築されており、中央ポリシー/監査が必要な場合、これは強力な選択肢です。
適している場合。 エッジガバナンス、監査可能性、データ居住性、中央制御は、あなたの環境で妥協できない要件です。
統一
それが何であるか。 ライブベンチマークを使用してコスト/スピード/品質を最適化し、地域やワークロードに応じて調整するデータ駆動型ルーター。
適している場合。 実世界のパフォーマンスに継続的に適応するベンチマークガイド付き選択を求めています。
オルク.ai
それが何であるか。 生成AIコラボレーション + LLMOpsプラットフォーム:実験、評価ツール(RAGメトリクスを含む)、デプロイメント、RBAC/VPC。評価とガバナンスを統合する必要がある場合に最適です。
適している場合。 実験と評価を一箇所で行い、そのまま同じ画面からデプロイする必要があります。
LiteLLM
それが何であるか。 OpenAI互換のエンドポイント、予算とレート制限、ログ/メトリクス、管理UIを備えたオープンソースのプロキシ/ゲートウェイ。Docker/K8s/Helmでデプロイし、トラフィックを自分のネットワーク内に保持します。
適している場合。 自己ホスティングと完全なインフラ制御を求めており、人気のあるOpenAIスタイルのSDKとの簡単な互換性を希望します。
注意点。 他のOSSゲートウェイと同様に、運用とアップグレードは自分で管理します。
クイックスタート:数分でモデルを呼び出す(ShareAI)
まずは開始して プレイグラウンド, その後、APIキーを取得して出荷します。参考: APIクイックスタート • ドキュメントホーム • リリース.
#!/usr/bin/env bash
# ShareAI — Chat Completions (cURL)
# Usage:
#   export SHAREAI_API_KEY="YOUR_KEY"
#   ./chat.sh

set -euo pipefail
: "${SHAREAI_API_KEY:?Missing SHAREAI_API_KEY in environment}"

curl --fail --show-error --silent \
  -X POST "https://api.shareai.now/v1/chat/completions" \
  -H "Authorization: Bearer $SHAREAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-70b",
    "messages": [
      { "role": "user", "content": "Summarize RouteLLM alternatives in one sentence." }
    ],
    "temperature": 0.3,
    "max_tokens": 120
  }'
// ShareAI — Chat Completions (JavaScript, Node 18+)
// Usage:
//   SHAREAI_API_KEY="YOUR_KEY" node chat.js

const API_URL = "https://api.shareai.now/v1/chat/completions";
const API_KEY = process.env.SHAREAI_API_KEY;

async function main() {
  if (!API_KEY) {
    throw new Error("Missing SHAREAI_API_KEY in environment");
  }

  const res = await fetch(API_URL, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Summarize RouteLLM alternatives in one sentence." }
      ],
      temperature: 0.3,
      max_tokens: 120
    })
  });

  if (!res.ok) {
    const text = await res.text();
    throw new Error(`HTTP ${res.status}: ${text}`);
  }

  const data = await res.json();
  console.log(data.choices?.[0]?.message ?? data);
}

main().catch(err => {
  console.error("Request failed:", err);
  process.exit(1);
});
移行のヒント。 現在のRouteLLMで選択されたモデルをShareAIの同等品にマッピングし、リクエスト/レスポンスの形状をミラーリングして、機能フラグの背後で開始します。最初にトラフィックの5–10%を送信し、レイテンシ/コスト/品質を比較してから増加させます。また、ゲートウェイ(Portkey/Kong)を運用している場合は、キャッシュ/フォールバックが層間で二重トリガーされないようにしてください。
一目で比較
| プラットフォーム | ホスト型 / セルフホスト | ルーティング & フォールバック | 可観測性 | 幅広さ (LLM + それ以上) | ガバナンス / ポリシー | メモ |
|---|---|---|---|---|---|---|
| ルートLLM | OSS | 学習型ルーター; OpenAI互換のクライアント/サーバー | CLI/ログ; 研究に重点を置く | LLM中心 | インフラを通じたポリシー | 研究グレードのコスト削減に最適; 独自のエッジコントロールを持ち込む. |
| シェアAI | body: JSON.stringify({ | 即時フェイルオーバー; マーケットプレイスによる選択ガイド | 使用ログ; マーケットプレイス統計 | 幅広いモデルカタログ | プロバイダーレベルのコントロール | 人々が力を合わせるマーケットプレイス;始めるには プレイグラウンド と モデル. |
| エデンAI | ホスト型 | プロバイダーの切り替え; バッチ; キャッシング | コスト & API モニタリング | LLM + 画像 + OCR + 音声 + 翻訳 | 中央請求/キー管理 | マルチモーダルオーケストレーター。 |
| オープンルーター | ホスト型 | プロバイダー/モデルルーティング;プロンプトキャッシング;プロバイダースティッキネス | リクエストレベルの情報 | LLM中心 | プロバイダーポリシー | キャッシュ再利用;利用不可時のフォールバック。 |
| ポートキー | ホスト型ゲートウェイ | ポリシーフォールバック;レート制限プレイブック;セマンティックキャッシュ | トレース/メトリクス | LLM優先 | ゲートウェイ設定 | SREスタイルのガードレール。 |
| コングAIゲートウェイ | セルフホスト/エンタープライズ | AIプラグインを介したアップストリームルーティング | Kongを介したメトリクス/監査 | LLM優先 | 強力なエッジガバナンス | インフラコンポーネント;ルーター/マーケットプレイスとペアリング。 |
| 統一 | ホスト型 | コスト/速度/品質によるデータ駆動型ルーティング | ベンチマークエクスプローラー | LLM中心 | ルーターポリシー | ベンチマークに基づく選択。 |
| オルク.ai | ホスト型 | オーケストレーションでのリトライ/フォールバック | プラットフォーム分析; RAG評価者 | LLM + RAG + 評価 | RBAC/VPCオプション | コラボレーションと実験への注力。 |
| LiteLLM | セルフホスト/OSS | リトライ/フォールバック; 予算/制限 | ロギング/メトリクス; 管理UI | LLM中心 | 完全なインフラ制御 | OpenAI互換; Docker/K8s/Helmデプロイ。 |
FAQs: RouteLLMとその他の違い
RouteLLMとShareAI — どちらが優れている?
選択する シェアAI 透明なマーケットプレイスを求めるなら 価格/遅延/稼働時間/可用性 各ルートの前に、プラス 即時フェイルオーバー そしてビルダーに合わせた経済性。選択 ルートLLM 研究主導の学習済みルーターを好み、それに関連するインフラ(ゲートウェイ、ログ、監査)を操作することに慣れている場合は、以下から始めてください プレイグラウンド と モデルマーケットプレイス.
RouteLLM vs Eden AI — 違いは何ですか?
エデンAI LLMをまたぐ と マルチモーダル(ビジョン/OCR、音声、翻訳)を比較とモニタリングで対応。 ルートLLM LLMの学習済みルーティングに焦点を当てています。ロードマップにOCR/音声/翻訳を1つのAPIで統合する必要がある場合、Eden AIは配信を簡素化します。ルーティング研究が優先事項であれば、RouteLLMが適しています。リクエストごとのマーケットプレイスの透明性が必要な場合は、ShareAIと組み合わせてください。
RouteLLM vs OpenRouter — それぞれを選ぶタイミングは?
選択する オープンルーター いつ プロンプトキャッシング 暖かいキャッシュの再利用が重要です(同じプロバイダーを維持し、障害時にはフォールバックします)。選択 ルートLLM 自分で運用する学習済みポリシーのために。多くのスタックはOpenRouterをゲートウェイと組み合わせてポリシー/観測性を実現し、ルートごとのマーケットプレイスの透明性が必要な場合はShareAIを使用します。
RouteLLM vs Portkey — ルーターかゲートウェイか?
ルートLLM ルーターです。 ポートキー は ゲートウェイ: ポリシー/ガードレール(フォールバックプレイブック、セマンティックキャッシュ)と詳細なトレース/メトリクスに優れています。多くのチームは両方を使用します:組織全体のポリシーのためのゲートウェイ + モデル選択とコスト管理のためのルーター/マーケットプレイス。ルート前のマーケットプレイスの可視性が必要な場合、ShareAIはここでうまく機能します。
RouteLLM vs Kong AI Gateway — どちらが必要ですか?
選択する コングAIゲートウェイ いつ エッジガバナンス (集中管理されたポリシー/監査、データの居住性)は譲れません。維持してください ルートLLM 価格/性能のために学習済みルーティングをまだ望む場合は、使用してください シェアAI プロバイダーを選びたいときに一緒に使用します。 価格/遅延/稼働時間/可用性 各ルートの前に。
RouteLLM vs Unify — Unifyのユニークな点は何ですか?
統一 ライブベンチマークと動的ポリシーを使用して最適化します。 コスト/速度/品質のために. 地域やワークロードによって進化するデータ駆動型の選択を求める場合、Unifyは魅力的です。; ルートLLM ホストする学習ルーティングモデルに焦点を当てています。使用します。 シェアAI マーケットプレイスビューと即時フェイルオーバーでプロバイダーを選びたい場合に。
RouteLLM vs Orq.ai — 評価とRAGにはどちらが適している?
オルク.ai 実験/評価の場(RAG評価ツールを含む)を提供し、さらにデプロイメントやRBAC/VPCも提供します。LLMOps + 評価ツールが必要な場合、Orq.aiは初期段階で純粋なルーターを補完または置き換える可能性があります。持ち込みます。 シェアAI マーケットプレイスの透明性と本番環境での回復力を備えたプロバイダー選択を求める場合に。
RouteLLM vs LiteLLM — ホスト型 vs 自己ホスト型?
ルートLLM OSSルーティングロジックです。; LiteLLM 予算、レート制限、管理UIを備えたOpenAI互換のプロキシ/ゲートウェイです。トラフィックをVPC内に保持し、コントロールプレーンを所有したい場合に最適です。チームはしばしば自己ホスティングのためにLiteLLMを組み合わせます。 シェアAI プロバイダー間のマーケットプレイスの可視性と即時フェイルオーバーのために。
私のワークロードに最も安いのはどれですか:RouteLLM、ShareAI、OpenRouter、LiteLLM?
それはモデルの選択、地域、キャッシュ可能性、トラフィックパターンに依存します。ルーターのように シェアAI/OpenRouter ルーティングとキャッシュ対応のスティッキネスを通じてコストを削減できます。ゲートウェイのように ポートキー セマンティックキャッシングを追加します; LiteLLM を使用すると、運用に慣れている場合、プラットフォームのオーバーヘッドを削減できます。ベンチマークを あなたの プロンプトとトラック 結果ごとの実効コストを—リスト価格だけではありません。
RouteLLMとは何ですか?
LLMルーターを提供および評価するためのオープンソースフレームワークです。トレーニング済みのルーターとOpenAI互換のパスを提供します。MT-BenchのようなタスクでGPT-4に近い品質を維持しながら、コストを大幅に削減するとよく言われます。
ShareAIを完全に統合せずに試す最速の方法は何ですか?
開く プレイグラウンド, モデル/プロバイダーを選択し、ブラウザでプロンプトを実行します。準備ができたら、 キーを作成します そして、上記のcURL/JSスニペットをアプリに挿入します。
ShareAIプロバイダーになって収益を得ることはできますか?
はい。誰でも コミュニティ または 企業 Windows/Ubuntu/macOSまたはDockerを使用するプロバイダー。貢献する アイドルタイム バーストまたは実行 常時オン. 。インセンティブを選択: 報酬 (お金)、 交換 (トークン/AIプロシューマー)、または ミッション (NGOに%を寄付)。以下を参照してください プロバイダーガイド または開いてください 10. プロバイダーダッシュボードを通じて.
結論
一方で ルートLLM 強力なOSSルーターであり、最適な選択肢は優先事項によります:
- マーケットプレイスの透明性+回復力: シェアAI
- 1つのAPIでのマルチモーダル対応: エデンAI
- ホスト形式でのキャッシュ対応ルーティング: オープンルーター
- エッジでのポリシー/ガードレール: PortkeyまたはKong AI Gateway
- データ駆動型ルーティング: 統一
- LLMOps+評価者: オルク.ai
- セルフホスト型コントロールプレーン: LiteLLM
もし 価格/遅延/稼働時間/可用性 各ルートの前に、 即時フェイルオーバー, 、そして ビルダーに合わせた経済性 チェックリストにある場合、開く プレイグラウンド, APIキーを作成する, 、そして閲覧する モデルマーケットプレイス 次のリクエストをスマートにルートする方法。