Alternativas ao Apache APISIX 2026: Top 10 Alternativas ao APISIX
Atualizado Setembro 2026
Se você está pesquisando Alternativas ao Apache APISIX, este guia apresenta o panorama como um construtor faria. Definimos onde os gateways de API se destacam, onde o roteamento de IA multi-fornecedor agrega valor e como combinar “governança de gateway” com ShareAI 3. para uma API entre muitos provedores, dados transparentes de mercado (preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor), e failover instantâneo.
• Portais (APISIX, Kong, Tyk, NGINX, etc.) focam em governança de saída: credenciais centralizadas, políticas, limites de taxa, plugins, observabilidade. • Roteamento de IA multi-fornecedor (ShareAI) foca em transparência pré-rota (preço, latência, tempo de atividade, disponibilidade) e roteamento resiliente em muitos fornecedores—complementar a um gateway. • Muitas equipes combinam um gateway + ShareAI: gateway para política organizacional; ShareAI para roteamento guiado pelo mercado e failover.
O que o Apache APISIX é (e o que não é)
Apache APISIX é um gateway de API de código aberto, orientado por plugins, usado para gerenciar e proteger o tráfego de API. Ele é ótimo em política de borda (chaves, limitação de taxa, autenticação, transformações), controle de tráfego, e observabilidade padrões típicos de gateways. Ele é não um mercado de IA multi-fornecedor transparente, e não tem como objetivo mostrar a você estatísticas ao vivo de fornecedores (preço, latência, tempo de atividade, disponibilidade) antes de você rotear chamadas LLM. É aí que uma API estilo mercado como ShareAI complementa um gateway.
Como avaliamos as melhores alternativas ao Apache APISIX
Amplitude e neutralidade do modelo — proprietário + aberto; troca fácil; evitar reescritas.
Latência e resiliência — políticas de roteamento, timeouts, tentativas, failover instantâneo.
2. Governança e segurança — gerenciamento de chaves, escopos, roteamento regional.
Observabilidade — logs/rastros + dashboards de custo/latência.
5. Transparência de preços e TCO — comparar real 7. antes de rotear. antes roteamento.
Experiência do desenvolvedor — documentação, SDKs, inícios rápidos; tempo até o primeiro token.
11. — se seus gastos — se seus gastos aumentam a oferta (incentivos para provedores).
Top 10 alternativas ao Apache APISIX
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. Uma API multi-provedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos/provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é movida por pessoas: provedores (comunidade ou empresa) mantêm modelos online e ganham.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é o ajuste mais direto—e ele combina perfeitamente com seu gateway existente: mantenha o APISIX (ou outro gateway) para políticas em toda a organização; adicione o ShareAI para roteamento guiado por marketplace.
Uma API → muitos provedores; alterne sem reescritas.
Transparência do marketplace: preço, latência, tempo de atividade, disponibilidade, tipo de provedor—visível antes do roteamento.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: oferta movida por pessoas; provedores ganham por manter modelos online.
Governança: mantenha seu gateway; aplique políticas; roteie via ShareAI por modelo.
#2 — Kong Gateway / Kong AI Gateway
Gateway de nível empresarial focado em políticas/plugins, controle de tráfego e análises em tempo de execução. Combina bem com o ShareAI para roteamento multi-provedor.
#3 — Tyk
Gateway amigável para desenvolvedores com controle granular e recursos de políticas robustas. Combine com ShareAI para escolher provedores por tempo real preço/latência/disponibilidade.
#4 — NGINX
Proxy/gateway de alto desempenho; excelente para roteamento personalizado e aplicação. Adicione ShareAI para marketplace de modelos + failover sem precisar criar lógica multi-provedor.
#5 — Apigee
Gestão ampla de APIs e monetização. Mantenha a governança do Apigee; roteie chamadas de IA via ShareAI quando quiser acesso agnóstico de provedores transparente custos.
transparentes.
#6 — Gravitee pré-rota Gateway de código aberto com pacotes de políticas e portal. Adicione ShareAI para incluir.
#7 — Traefik
Gateway moderno com uma camada fina de IA disponível em seu ecossistema. Combine com ShareAI para roteamento orientado pelo mercado + failover com reconhecimento de saúde.
#8 — KrakenD
Camada de agregação de gateway de API sem estado; ótimo para modelar respostas. Adicione ShareAI para o mercado de IA e resiliência entre provedores.
#9 — WSO2 API Manager
Plataforma rica em recursos (políticas, análises). Use ShareAI para IA multi-provedor e experimentação rápida entre modelos.
#10 — Amazon API Gateway (ou MuleSoft)
Planos de controle gerenciados para empresas. Mantenha a governança; roteie IA através muitos provedores do ShareAI para flexibilidade e compensações de custo/latência.
Relacionado: Alternativas de agregação/orquestração de IA que os usuários do APISIX perguntam
OpenRouter — API unificada sobre muitos modelos; rápido para experimentação.
Portkey — Gateway de IA enfatizando observabilidade, limites, governança.
Eden IA — Agregador multi-serviço (LLM, visão, TTS, tradução).
LiteLLM — SDK leve e proxy auto-hospedado falando interfaces compatíveis com OpenAI.
Unificar — roteamento/avaliação orientados pela qualidade para selecionar melhores modelos por prompt.
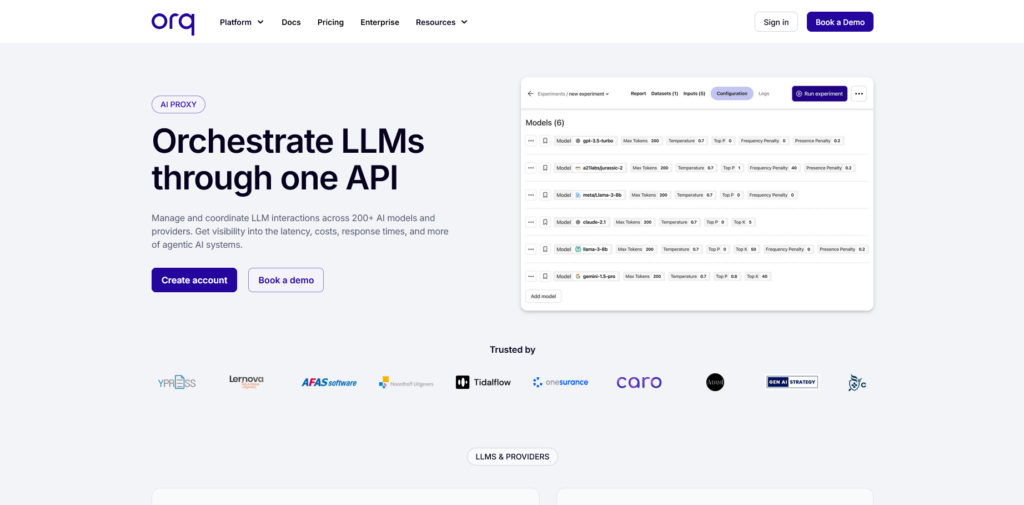
Orq — orquestração e fluxos de colaboração para mover experimentos para produção.
Se o seu objetivo é transparência pré-rota com failover instantâneo and acesso acesso, o ShareAI centraliza esses recursos em uma API; você ainda pode manter o APISIX para política de borda.
Comparação rápida (gateway vs marketplace)
Plataforma
Quem atende
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Preços e TCO: compare custos reais (não apenas preços unitários)
Bruto $/1K tokens esconde a realidade. Seu eficaz custo muda com novas tentativas/alternativas, latência (afeta o comportamento do usuário), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. Um mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): otimize para o tempo-para-primeiro-token (use o Playground e os quickstarts).
Escala média (~2M tokens/dia): o roteamento/failover guiado pelo mercado pode reduzir 10–20% enquanto melhora a UX (escolha provedores por tempo real preço/latência/disponibilidade).
Cargas de trabalho irregulares: espere custos efetivos de tokens mais altos devido a novas tentativas durante o failover; planeje o orçamento para isso.
Como experimentar a rota ShareAI (copiar-colar quickstarts)
Esses exemplos usam uma interface compatível com OpenAI. Substitua YOUR_KEY pela sua chave ShareAI — crie uma em Criar Chave de API. Veja o Referência da API.
Padrões de migração: movendo-se para (ou emparelhando com) ShareAI
Do APISIX (mantenha seu gateway)
Mantenha o APISIX para política da organização (autenticação, cotas, limites de taxa).
Direcione chamadas de IA via ShareAI por modelo.
Comece com 10% tráfego sombra, valide latência/orçamentos de erro, depois aumente para 25% → 50% → 100%.
Use estatísticas do marketplace para trocar provedores sem reescritas.
Chaves e escopos permanecem centralizados em seu gateway; gire e monitore no Console (Guia do Usuário).
Do OpenRouter
Mapeie nomes de modelos, verifique paridade de prompts, tráfego sombra, depois aumente conforme acima.
Do LiteLLM
Mantenha o proxy auto-hospedado onde você se sentir confortável operando; mova rotas de produção para o ShareAI para gerenciado roteamento + failover.
De Unify / Portkey / Orq / Kong
Defina expectativas de paridade de recursos (análises, limites, orquestração). Muitas equipes executam um híbrido: mantenha recursos especializados onde são mais fortes; use o ShareAI para escolha transparente de provedores and resiliência.
Segurança, privacidade e conformidade: uma lista de verificação neutra em relação ao fornecedor
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde os prompts/respostas são armazenados e por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompts/respostas; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento de forma consistente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
Para provedores: ganhe mantendo modelos online
Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS, ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens / AI Prosumer), ou Missão (doar % para ONGs). À medida que você escala, você pode definir seus próprios preços de inferência e ganhar exposição preferencial.
Apache APISIX vs ShareAI — qual para roteamento de IA multi-fornecedor?
ShareAI. Ele é construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover através de muitos fornecedores. APISIX é um gateway (política/observabilidade centralizada). Muitas equipes usam ambos.
Apache APISIX vs Kong — gateway vs gateway?
Ambos são gateways com forte política/observabilidade. Se você também quiser transparência do provedor antes da rota and failover instantâneo, adicione a camada ShareAI no gateway que você padronizar.
Apache APISIX vs Tyk — ergonomia para desenvolvedores ou transparência de marketplace?
Tyk oferece controle de políticas amigável para desenvolvedores. ShareAI adiciona tempo real estatísticas de provedores e roteamento resiliente entre provedores — complementar a qualquer gateway.
Apache APISIX vs NGINX — controle DIY ou roteamento turnkey de marketplace?
NGINX é excelente para modelagem de tráfego personalizada. ShareAI te poupa de fazer DIY roteamento multi-provedor, failover e comparações de preço/latência.
Apache APISIX vs Apigee — gerenciamento de API vs IA agnóstica de provedores?
Apigee é um amplo gerenciamento de API. ShareAI oferece uma API sobre muitos provedores e um mercado transparente controle de custo efetivo e UX.
Apache APISIX vs Gravitee — política de código aberto vs dados ao vivo de marketplace?
Gravitee cobre governança de gateway; ShareAI cobre transparência de preço/latência/disponibilidade e failover instantâneo entre provedores.
Apache APISIX vs KrakenD — agregação vs agregação+marketplace?
KrakenD agrega upstreams na camada de gateway; ShareAI adiciona visibilidade em nível de marketplace e resiliência entre provedores de IA.
Apache APISIX vs WSO2 — profundidade de plataforma vs agilidade multi-provedor?
WSO2 é rico em recursos; ShareAI otimiza para troca rápida de modelo/provedor sem reescritas.
Apache APISIX vs Amazon API Gateway — controle gerenciado vs escolha de provedor?
Amazon API Gateway é governança gerenciada. ShareAI fornece 14. transparência pré-rota com dados de custo/latência pré-rota.
Apache APISIX vs MuleSoft — integrações empresariais vs roteamento de marketplace?
MuleSoft é integração empresarial + gerenciamento de API. ShareAI complementa com roteamento de IA entre provedores. and preços transparentes.
Apache APISIX vs OpenResty — poder do Lua vs marketplace sem código?
OpenResty é poderoso para Lua personalizado; ShareAI evita código sob medida para seleção de provedor and failover.
Apache APISIX vs Portkey — quem é mais forte em guardrails?
Portkey enfatiza governança/observabilidade. Se sua principal necessidade é escolha transparente de provedores and failover instantâneo, escolha ShareAI (e mantenha seu gateway para política). Esta comparação também ajuda equipes que procuram alternativas ao Portkey descobrir a abordagem de marketplace.
Apache APISIX vs OpenRouter — acesso rápido a múltiplos modelos ou roteamento resiliente com estatísticas ao vivo?
OpenRouter oferece acesso rápido a muitos modelos. ShareAI adiciona preço/latência/tempo de atividade/disponibilidade ao vivo and roteamento baseado em políticas entre provedores.
Apache APISIX vs Eden AI — muitos serviços de IA ou transparência de marketplace?
Eden AI agrega vários serviços de IA; ShareAI foca em roteamento transparente multi-provedor and failover instantâneo.
Apache APISIX vs LiteLLM — proxy auto-hospedado ou marketplace gerenciado?
LiteLLM é faça você mesmo; ShareAI é gerenciado roteamento + 7. . Se você já usa APISIX/APIs, reconhecerá a abordagem de plano de controle/plano de dados e o modelo de plugins.. Muitas equipes mantêm o LiteLLM para desenvolvimento e usam o ShareAI para produção.
Apache APISIX vs Unify — seleção do melhor modelo vs aplicação de políticas?
Unify otimiza para seleção orientada por avaliação; ShareAI otimiza para visibilidade do marketplace + resiliência. Mantenha seu gateway para aplicação.
Apache APISIX vs Orq — orquestração vs saída?
Orq foca em fluxos de orquestração; ShareAI foca em roteamento agnóstico de provedores e estatísticas de mercado ao vivo; APISIX cobre política de saída.
Se você está avaliando Alternativas ao Higress, este guia organiza as opções como um construtor faria. Primeiro, esclarecemos o que Higress é—um gateway de API nativo de IA e nativo da nuvem, construído sobre Istio e Envoy com suporte a plugins Wasm e um console de interface gráfica—depois comparamos as 10 melhores alternativas. Colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores, um mercado transparente (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) antes do roteamento, failover instantâneo, e economia impulsionada por pessoas (70% de gastos fluem para provedores).
O que Higress é (e o que não é)
Higress e se posiciona como um “Gateway de IA | Gateway de API Nativo de IA.” É baseado em Istio and Envoy, fundindo camadas de tráfego, microsserviços e gateway de segurança em um único plano de controle e suportando plugins Wasm (Go/Rust/JS). Também oferece um console e implantação via Docker/Helm. Em resumo: um gateway com foco em governança para saída de IA e microsserviços, não um mercado transparente de modelos.
Contexto útil: Higress enfatiza uma “integração tripla de gateway” (tráfego + microsserviços + segurança) para reduzir custos operacionais. É open source e apoiado pela comunidade.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores de LLM: uma API entre muitos modelos/provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover.
Gateways de IA: política/governança na borda (chaves, limites de taxa, trilhos de proteção) + observabilidade; você traz os provedores. Higress senta aqui.
Plataformas de agente/chatbot: UX empacotado (sessões/memória/ferramentas/canais), voltado para assistentes de envio em vez de agregação independente de provedores.
Como avaliamos as melhores alternativas ao Higress
Amplitude e neutralidade do modelo: proprietário + aberto; troca fácil; sem reescritas.
Latência e resiliência: políticas de roteamento, timeouts, tentativas, failover instantâneo.
2. Governança e segurança: manipulação de chaves, escopos, roteamento regional.
Observabilidade: logs/traces e dashboards de custo/latência.
5. Transparência de preços e TCO: compare custos reais antes de você rotear.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
Top 10 alternativas ao Higress
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um marketplace e roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de provedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm os modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é a opção mais direta. Mantenha um gateway se precisar de políticas para toda a organização; adicione ShareAI para roteamento guiado pelo marketplace.
Uma API → mais de 150 modelos entre muitos provedores; sem reescritas, sem dependência.
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: 70% dos gastos vão para provedores (comunidade ou empresa).
Para provedores: ganhe mantendo os modelos online. Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre-se via Windows, Ubuntu, macOS ou Docker. Contribua com rajadas de tempo ocioso ou opere sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doe % para ONGs). Conforme você escala, pode definir preços de inferência e ganhar exposição preferencial. Guia do Provedor
#2 — Kong AI Gateway
O que é. Gateway de IA/LLM empresarial—governança, políticas/plugins, análises, observabilidade para tráfego de IA na borda. É um plano de controle, não um marketplace.
#3 — Portkey
O que é. Gateway de IA enfatizando observabilidade, limites e governança—popular entre equipes regulamentadas.
#4 — OpenRouter
O que é. API unificada sobre muitos modelos; ótimo para experimentação rápida em um amplo catálogo.
#5 — Eden AI
O que é. Agrega LLMs + IA mais ampla (imagem, tradução, TTS), com fallback/cache e agrupamento.
#6 — LiteLLM
O que é. SDK Python leve + proxy auto-hospedável que utiliza uma interface compatível com OpenAI para muitos provedores.
#7 — Unify
O que é.Roteamento orientado à qualidade e avaliação para escolher melhores modelos por prompt.
#8 — Orq AI
O que é. Plataforma de orquestração/colaboração que ajuda equipes a passar de experimentos para produção com fluxos de baixo código.
#9 — Apigee (com LLMs por trás)
O que é. Gerenciamento/gateway de API maduro que você pode colocar na frente de provedores de LLM para aplicar políticas, chaves, cotas.
#10 — NGINX
O que é. Use NGINX ou APISIX para construir roteamento personalizado, aplicação de tokens e cache para backends LLM, se preferir Controle DIY.
Higress vs ShareAI (qual escolher?)
Se você precisar uma API sobre muitos provedores com transparente preços/latência/disponibilidade/tempo de atividade and failover instantâneo, escolha ShareAI. Se o seu principal requisito for governança de saída—credenciais/políticas centralizadas/aplicação e observabilidade—Higress se encaixa nesse cenário (base Istio/Envoy, extensibilidade Wasm). Muitas equipes combinam eles: gateway para política organizacional + ShareAI para roteamento de marketplace.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Higress
Equipes que desejam governança de saída
Provedores próprios
Credenciais/políticas centralizadas; plugins Wasm
Métricas compatíveis com Istio/Envoy
Roteamento condicional via filtros/plugins
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
OpenRouter
Desenvolvedores que desejam uma única chave
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Equipes com foco em orquestração
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Apigee / NGINX / APISIX
Empresas / DIY
BYO
Políticas
Complementos / personalizados
Personalizado
n/d
n/d
Preços e TCO: compare custos reais (não apenas preços unitários)
Bruto $/1K tokens oculta a imagem real. Mudanças no TCO com tentativas/recuos, latência (que afeta o uso), variação do provedor, armazenamento de observabilidade e execuções de avaliação. Um mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimize para o tempo até o primeiro token (Playground, inícios rápidos).
Escala média (~2M tokens/dia): O roteamento/failover guiado pelo marketplace pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Espere custos efetivos mais altos de tokens devido a tentativas durante o failover; planeje o orçamento para isso.
Guia de migração: movendo para ShareAI
Do Higress
Mantenha políticas no nível do gateway onde elas brilham, adicione ShareAI para roteamento de marketplace + failover instantâneo. Padrão: autenticação/política do gateway → ShareAI rota por modelo → medir estatísticas do marketplace → apertar políticas.
Do OpenRouter
Mapeie nomes de modelos, verifique a paridade de prompts, depois sombreie 10% do tráfego e aumente 25% → 50% → 100% conforme os orçamentos de latência/erro forem mantidos. Os dados do marketplace tornam as trocas de provedores diretas.
Do LiteLLM
Substituir o proxy auto-hospedado em rotas de produção que você não deseja operar; mantenha LiteLLM para desenvolvimento, se desejado. Compare a sobrecarga de operações com os benefícios do roteamento gerenciado.
De Unify / Portkey / Orq / Kong
Defina paridade de recursos expectativas (análises, limites, orquestração, plugins). Muitas equipes operam de forma híbrida: mantenha recursos especializados onde são mais fortes; use ShareAI para escolha transparente de provedores and failover.
Início rápido para desenvolvedores (copiar-colar)
Use um superfície compatível com OpenAI. Substituir YOUR_KEY com sua chave ShareAI — obtenha uma em Criar Chave de API. Veja o Referência da API para detalhes. Em seguida, experimente o Playground.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"
async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });
  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }
  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}
main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados, por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompt/resposta; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento de forma consistente (OTel).
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
# Pré-requisitos:
# export SHAREAI_API_KEY="SUA_CHAVE"
CompartilharAI. É construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor) e roteamento inteligente/failover entre muitos provedores. Higress é um governança de saída curl -X POST "https://api.shareai.now/v1/chat/completions" \.
-H "Authorization: Bearer $SHAREAI_API_KEY" \
-H "Content-Type: application/json" \; Higress -d '{ ShareAI para roteamento transparente de múltiplos provedores.
"model": "llama-3.1-70b",
"messages": [; Higress { "role": "user", "content": "Me dê um haiku curto sobre roteamento confiável." } uma API sobre muitos provedores ], ShareAI.
"temperature": 0.4,
Higress "max_tokens": 128; APISIX }' visibilidade do marketplace e failover entre muitos provedores de modelo, use ShareAI junto.
Higress vs NGINX — gateway de IA DIY vs turnkey
NGINX oferece controle DIY poderoso; Higress empacota um gateway moderno e compatível com Istio. Adicione ShareAI quando você precisar de roteamento agnóstico de provedor e preços/latência ao vivo antes de escolher.
Higress vs Apigee — egress de IA vs gerenciamento de API
Apigee é um gerenciamento amplo de API; Higress é um gateway nativo de IA. ShareAI complementa qualquer um com multi-provedor acesso e transparência de marketplace.
Higress vs Portkey — quem é mais forte em guardrails?
Ambos enfatizam governança/observabilidade; profundidade e ergonomia diferem. Se sua principal necessidade for escolha transparente de provedores and failover instantâneo, adicione ShareAI.
Higress vs OpenRouter — acesso rápido multi-modelo ou controles de gateway?
OpenRouter torna o acesso multi-modelo rápido; Higress centraliza a política do gateway. Se você também quiser transparência pré-rota, ShareAI combina acesso multi-provedor com uma visão de marketplace e roteamento resiliente.
Higress vs LiteLLM — proxy auto-hospedado ou gateway gerenciado?
LiteLLM é um proxy DIY; Higress é um gateway gerenciado/operado. Prefira ShareAI se você não quiser operar infraestrutura e precisar roteamento orientado por marketplace.
Higress vs Unify — seleção do melhor modelo vs aplicação de políticas?
Unify foca em seleção de modelo orientada por avaliação; Higress em política/observabilidade. Para uma API sobre muitos provedores com estatísticas de marketplace ao vivo, use ShareAI.
Higress vs Orq — orquestração vs saída?
Orq ajuda a orquestrar fluxos de trabalho; Higress governa o tráfego de saída. ShareAI complementa qualquer um com escolha transparente de provedores.
Higress vs Eden AI — muitos serviços de IA ou controle de saída?
Eden AI agrega vários serviços de IA (LLM, imagem, TTS). Higress centraliza políticas/credenciais. Para preços/latência transparentes entre muitos provedores and failover instantâneo, escolha ShareAI.
OpenRouter vs Apache APISIX — agregador vs gateway NGINX/Lua
OpenRouter: API unificada sobre muitos modelos. APISIX: gateway NGINX/Lua que você opera. Se você precisar transparência pré-rota and failover entre provedores, ShareAI é construído para um propósito específico.
Kong vs Traefik — plugins empresariais vs camada fina de IA
Ambos são gateways; a profundidade difere. As equipes frequentemente mantêm um gateway e adicione ShareAI 3. para roteamento guiado por marketplace.
Portkey vs Kong — trilhos de segurança/observabilidade vs ecossistema de plugins
Diferentes pontos fortes; ShareAI introduz roteamento agnóstico de provedores mais métricas de marketplace.
LiteLLM vs OpenRouter — proxy auto-hospedado vs agregador
LiteLLM: você hospeda; OpenRouter: agregador gerenciado. ShareAI adiciona transparência pré-rota + failover entre muitos provedores.
NGINX vs Apigee — gateway DIY vs gerenciamento de API
NGINX: políticas/caching personalizados; Apigee: gerenciamento completo de API. Se você também quiser roteamento LLM transparente e multi-fornecedor, adicione ShareAI.
Unify vs Portkey — avaliação vs governança
Unify foca na seleção de qualidade do modelo; Portkey na governança/observabilidade. ShareAI complementa com preço ao vivo/latência/tempo de atividade and failover instantâneo.
Orq vs Kong — orquestração vs política de borda
Orq orquestra fluxos; Kong aplica política de borda. ShareAI lida com roteamento entre provedores com visibilidade no marketplace.
Eden AI vs OpenRouter — multi-serviço vs centrado em LLM
Eden AI abrange múltiplas modalidades; OpenRouter foca em LLMs. ShareAI fornece dados transparentes pré-rota and failover entre provedores.
Experimente o ShareAI a seguir
Abrir Playground — execute uma solicitação ao vivo para qualquer modelo em minutos
Alternativas ao APIPark 2026: Top 10 Alternativas ao APIPark
Atualizado Setembro 2026
Se você está procurando alternativas ao APIPark, este guia detalha o cenário do ponto de vista de um construtor. Vamos esclarecer onde o APIPark (AI Gateway) se encaixa—uma camada de saída/governança para o tráfego de IA—e depois comparar o 10 melhores alternativas. Colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores, um mercado transparente (preço, latência, tempo de atividade, disponibilidade, tipo de provedor antes roteamento), failover instantâneo, e economia impulsionada por pessoas (70% dos gastos vão para provedores que mantêm os modelos online).
O que é. O APIPark se posiciona como um gateway/camada de controle de IA: um lugar para centralizar chaves, aplicar políticas/regras de proteção e observar o tráfego de IA como uma superfície de API. Ele atende equipes que desejam governar a saída de IA entre os provedores que já utilizam.
O que não é. O APIPark é não um marketplace de modelos transparente que mostra preço/latência/disponibilidade/tempo de atividade entre muitos provedores antes de você rotear. Se sua prioridade for 14. transparência pré-rota and roteamento resiliente de múltiplos provedores, você provavelmente combinará um gateway com uma API de marketplace—ou substituirá o gateway se as necessidades de governança forem mínimas.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores LLM (marketplaces): Uma API através de muitos modelos/provedores com transparência pré-rota and roteamento inteligente/failover. Exemplo: ShareAI (multi-provedor, visão de marketplace).
Gateways de IA: Política/governança na borda (chaves, limites de taxa, trilhos de segurança) com observabilidade. Você traz seus provedores. Exemplo: APIPark, Kong AI Gateway, Traefik, Apache APISIX (com backends de IA).
Plataformas de agentes/chatbots: UX empacotada, memória/ferramentas e canais—voltados para assistentes de usuários finais versus agregação independente de provedores. Exemplo: Orq (orquestração em primeiro lugar).
Como avaliamos as melhores alternativas ao APIPark
Amplitude e neutralidade do modelo: proprietário + aberto; troca fácil; sem reescritas.
Latência e resiliência: políticas de roteamento, tempos limite, novas tentativas, failover instantâneo.
Governança e segurança: manuseio de chaves, escopos, roteamento regional, trilhos de segurança.
Observabilidade: logs/rastreamentos + dashboards de custo/latência.
Transparência de preços & TCO: comparar real 7. antes de rotear. antes de você rotear.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
Comunidade & economia: se seus gastos aumentam a oferta (incentivos para proprietários/provedores de GPU).
Top 10 Alternativas ao APIPark
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é a opção mais direta. Mantenha um gateway se precisar de políticas para toda a organização; adicione ShareAI para roteamento guiado pelo marketplace.
Uma API → mais de 150 modelos entre muitos provedores; sem reescritas, sem dependência fixa.
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa:70% do gasto vai para provedores (comunidade ou empresa).
Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doar % para ONGs). À medida que você escala, você pode definir seus próprios preços de inferência e ganhar exposição preferencial.
O que é. API unificada sobre muitos modelos; ótimo para experimentação rápida em um amplo catálogo.
Onde se destaca: acesso rápido a múltiplos modelos para desenvolvedores; trocas fáceis.
Compromissos vs ShareAI: transparência do marketplace e profundidade de roteamento/failover variam; ShareAI adiciona preço/latência/disponibilidade pré-roteamento and failover instantâneo.
#3 — Gateway de IA Kong
O que é. Gateway de IA/LLM empresarial—governança, políticas/plugins, análises, observabilidade para tráfego de IA na borda.
Onde se destaca: organizações que precisam de controle forte no nível do gateway.
Compromissos vs ShareAI: Kong é um plano de controle; não é um marketplace.
#4 — Portkey
O que é. Gateway de IA enfatizando observabilidade, limites e governança—popular em indústrias regulamentadas.
Onde se destaca: conformidade/regras, rastreamentos profundos.
Compromissos vs ShareAI: governança-primeiro vs roteamento independente de provedor com transparência.
#5 — Eden AI
O que é. Agrega LLMs mais IA ampla (imagem, tradução, TTS) com alternativas, cache e agrupamento.
Onde se destaca: cargas de trabalho de múltiplas capacidades além de LLMs.
Compromissos vs ShareAI: catálogo amplo vs estatísticas do marketplace and failover profundidade.
#6 — LiteLLM
O que é. SDK Python leve + proxy auto-hospedável que utiliza uma interface compatível com OpenAI para muitos provedores.
Onde se destaca: controle DIY, auto-hospedagem.
Compromissos vs ShareAI: você opera/escala o proxy; ShareAI é gerenciado com failover instantâneo and transparência de marketplace.
#7 — Unify
O que é. Roteamento e avaliação orientados à qualidade para escolher melhores modelos por prompt.
Onde se destaca: seleção baseada em avaliação.
Compromissos vs ShareAI: foco em avaliação vs escolha de mercado + provedor e resiliência.
#8 — Orq AI
O que é. Plataforma de orquestração/colaboração para passar de experimentos à produção com fluxos de baixo código.
Onde se destaca: orquestração de fluxo de trabalho.
Compromissos vs ShareAI: orquestração vs roteamento de marketplace multi-fornecedor.
#9 — Apigee (com LLMs por trás)
O que é. Gerenciamento/API gateway maduro que você pode colocar na frente de provedores LLM para aplicar políticas, chaves, cotas.
Onde se destaca: amplitude de gerenciamento de API empresarial.
Compromissos vs ShareAI: amplitude de governança vs transparência de modelo/provedor.
#10 — Apache APISIX
O que é. Gateway de código aberto com plugins, limitação de taxa, roteamento e observabilidade que pode ser colocado na frente de backends de IA.
Onde se destaca: flexibilidade de código aberto e ecossistema de plugins.
Compromissos vs ShareAI: engenharia de gateway DIY vs marketplace turnkey + failover.
APIPark vs ShareAI: qual escolher?
Escolha ShareAI se você precisar uma API entre muitos provedores com preços/transparência/latência/disponibilidade and failover instantâneo.
Escolha APIPark se sua principal exigência for governança de saída—credenciais centralizadas, aplicação de políticas e observabilidade na borda.
Muitas equipes executam ambos: gateway para política da organização + ShareAI 3. para roteamento guiado por marketplace.
Comparação rápida (de relance)
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
150+ modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
APIPark
Equipes que desejam governança de saída
Provedores próprios
Credenciais/políticas centralizadas
Métricas/rastreamento
Roteamento condicional via políticas
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
OpenRouter
Desenvolvedores que desejam acesso multi-modelo
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Equipes com foco em orquestração
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Apigee
Empresas / gerenciamento de API
BYO
Políticas
Complementos
Personalizado
n/d
n/d
Apache APISIX
Código aberto/DIY
BYO
Políticas/plugins
Prometheus/Grafana
Personalizado
n/d
n/d
Dica: Se você mantiver um gateway para política da organização, ainda pode rotear por solicitação via ShareAI usando dados do marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) para escolher o melhor provedor e alvo de failover.
Preços e TCO: compare custos reais (não apenas preços unitários)
Bruto $/1K tokens esconde a verdadeira imagem. O TCO muda com novas tentativas/alternativas, latência (o que afeta o uso), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. A mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimizar o tempo para o primeiro token (Playground, inícios rápidos).
Escala média (~2M tokens/dia): O roteamento/failover guiado pelo Marketplace pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Espere custos efetivos mais altos de tokens devido a tentativas novamente durante o failover; planeje o orçamento para isso.
Guias de migração
De APIPark → ShareAI (complementar ou substituir)
Mantenha políticas no nível do gateway onde elas brilham; adicione ShareAI para roteamento de marketplace + failover instantâneo. Padrão comum: gateway auth/policy → rota ShareAI por modelo → medir estatísticas do marketplace → apertar políticas.
Do OpenRouter
Mapear nomes de modelos, verificar paridade de prompts, então sombrear 10% o tráfego e aumentar gradualmente 25% → 50% → 100% conforme os orçamentos de latência/erro se mantêm. Dados do marketplace tornam trocas de provedores diretas.
Do LiteLLM
Substituir o proxy auto-hospedado em rotas de produção que você não deseja operar; mantenha LiteLLM para desenvolvimento, se desejado. Compare sobrecarga de operações vs benefícios de roteamento gerenciado.
De Unify / Portkey / Orq / Kong / APISIX / Apigee
Defina expectativas de paridade de recursos (análises, guardrails, orquestração, plugins). Muitas equipes executam híbrido: mantenha recursos especializados onde são mais fortes; use ShareAI para escolha de provedor transparente e failover.
Início rápido para desenvolvedores (copiar-colar)
O seguinte usa uma Compatível com OpenAI superfície. Substituir YOUR_KEY pela sua chave ShareAI—obtenha uma em Criar Chave de API.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados e por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompt/resposta; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento consistentemente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — APIPark vs outros concorrentes (e onde ShareAI se encaixa)
APIPark vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. APIPark é sobre governança de saída (credenciais/política centralizadas; observabilidade). Muitas equipes usam ambos.
APIPark vs OpenRouter — acesso rápido multi-modelo ou governança?
OpenRouter torna o acesso multi-modelo rápido; APIPark centraliza política e observabilidade. Se você também quiser transparência pré-rota and failover instantâneo, ShareAI combina acesso multi-provedor com um visão de marketplace and roteamento resiliente.
APIPark vs Kong AI Gateway — gateway vs marketplace?
Tanto o APIPark quanto o Kong são gateways (políticas, plugins, análises), não marketplaces. Combine um gateway com ShareAI para transparência roteamento multi-provedor and failover.
APIPark vs Portkey — quem é mais forte em guardrails?
Ambos enfatizam governança/observabilidade; profundidade e ergonomia diferem. Se sua principal necessidade for escolha transparente de provedores and failover, adicione ShareAI junto com qualquer gateway.
APIPark vs Apache APISIX — código aberto DIY ou controles gerenciados?
O APISIX oferece controle de gateway rico em plugins e de código aberto; o APIPark fornece governança gerenciada. Para evitar a complexidade do DIY enquanto também obtém seleção de provedor transparente, camada em ShareAI.
APIPark vs Traefik — dois gateways, ecossistemas diferentes
Ambos governam o egress de IA com políticas e observabilidade. Se você quiser uma API sobre muitos provedores com ao vivo estatísticas do marketplace, ShareAI complementa qualquer um.
APIPark vs NGINX — filtros DIY vs camada de IA pronta para uso
O NGINX oferece filtros/políticas DIY; o APIPark oferece uma camada empacotada. Para pular scripts personalizados e ainda obter escolha transparente de provedores, use ShareAI.
APIPark vs Apigee — gestão ampla de APIs vs egress específico para IA
Apigee é uma gestão ampla de APIs; APIPark é uma governança de saída focada em IA. Para acesso independente de provedor com transparência de marketplace, escolha ShareAI.
APIPark vs LiteLLM — proxy auto-hospedado ou governança gerenciada?
LiteLLM é um proxy DIY que você opera; APIPark é governança/observabilidade gerenciada. Se você prefere não operar um proxy e quer roteamento orientado por marketplace, escolha ShareAI.
APIPark vs Unify — avaliação do melhor modelo vs aplicação de políticas?
Unify foca na seleção de modelos baseada em avaliação; APIPark em políticas/observabilidade. Para uma API sobre muitos provedores com estatísticas de marketplace ao vivo, use ShareAI.
APIPark vs Eden AI — muitos serviços de IA ou controle de saída?
Eden AI agrega vários serviços de IA (LLM, imagem, TTS). APIPark centraliza políticas/credenciais com middlewares especializados em IA. Para preços/latência transparentes entre provedores and failover instantâneo, escolha ShareAI.
OpenRouter vs Apache APISIX — agregador vs gateway de código aberto
OpenRouter simplifica o acesso a modelos; APISIX fornece controle de gateway. Adicione ShareAI se você quiser transparência pré-rota and failover entre provedores sem operar seu próprio gateway.
Experimente o ShareAI a seguir
Abrir Playground — execute uma solicitação ao vivo para qualquer modelo em minutos
Se você está avaliando Alternativas Tyk, este guia mapeia o cenário como um construtor faria. Vamos esclarecer o que é Tyk—um gateway de API e plano de gerenciamento focado em política, segurança e observabilidade—e então comparar o 10 melhores alternativas (mais um FAQ detalhado). Nós colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores de modelos de IA, sinais transparentes de mercado (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) antes roteamento, failover instantâneo, e economia impulsionada por pessoas (70% de gastos vão para os provedores).
Tyk é um gateway de API: ele centraliza autenticação/autorização, limites de taxa/cotas, transformações de requisição/resposta, políticas e análises—para que você possa governar and observar o tráfego de API na borda. Isso é valioso quando você precisa de controle centralizado de saída and observabilidade entre muitos serviços.
Tyk não é um mercado transparente de modelos. Se sua equipe precisar visibilidade pré-rota em provedores e modelos de IA (preço unitário, latência observada, tempo de atividade, disponibilidade, tipo de provedor) and a capacidade de alternar instantaneamente entre vários provedores — esses são agregador pontos fortes, não recursos tradicionais de gateway.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores de LLM (por exemplo, ShareAI, OpenRouter, Eden AI): uma API para muitos modelos e provedores, com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover.
gateways de API (por exemplo, Tyk, Kong, Apigee, NGINX, Traefik, Gravitee, APISIX, KrakenD, AWS API Gateway, Azure API Management): centralizado políticas, chaves, cotas, limites e observabilidade para o seu tráfego. Você traz seus provedores e modelos.
Plataformas de agente/chatbot (por exemplo, Unify, Orq): UX empacotado para assistentes, fluxos, ferramentas e avaliação — voltado para experiências do usuário final em vez de agregação independente de provedores.
Muitas equipes usam ambos: mantenha um gateway para política e auditoria em toda a organização; adicione ShareAI 3. para roteamento guiado por marketplace entre provedores com failover instantâneo.
Como avaliamos as melhores alternativas ao Tyk
Amplitude do modelo e neutralidade (para casos de uso de IA): proprietário + aberto; troca fácil; sem reescritas.
Latência e resiliência: políticas de roteamento, timeouts, tentativas, failover instantâneo.
2. Governança e segurança: manipulação de chaves, escopos, roteamento regional.
Observabilidade: logs/traces e dashboards de custo/latência.
5. Transparência de preços e TCO: comparar real custos antes de rotear.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
11. — se seus gastos: se seu gasto aumenta a oferta (incentivos para proprietários de GPU).
Top 10 alternativas ao Tyk
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para os fornecedores (comunidade ou empresa) que mantêm os modelos online.
Por que é #1 aqui. Se o seu objetivo é agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é a opção mais direta. Mantenha seu gateway se precisar de políticas em toda a organização; adicione ShareAI 3. para roteamento guiado por marketplace.
Uma API → 150+ modelos entre muitos provedores; sem reescritas, sem dependência.
Mercado transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: 70% do gasto vai para provedores (comunidade ou empresa).
Para provedores: ganhe mantendo os modelos online. Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS, ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha incentivos: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doar % para ONGs). À medida que você escala, você pode definir seus próprios preços de inferência e ganhar exposição preferencial. Guia do Provedor
#2 — Kong Gateway / Kong AI Gateway
O que é. Gateway de API de nível empresarial com forte políticas/plugins, 11. observabilidade compatível com OpenTelemetry, e análises, além de extensões focadas em IA para controle de tráfego LLM. É um plano de controle, não um marketplace.
#3 — Apigee (Google Cloud)
O que é. Gerenciamento amplo de API para empresas—projetar, publicar, proteger e monitorar APIs em escala. Combina governança com análises; você pode colocar provedores de LLM atrás do Apigee, mas não terá transparência de mercado.
#4 — NGINX
O que é. Um proxy reverso de alto desempenho que você pode compor em um gateway DIY (roteamento, aplicação de tokens, cache). Poderoso, mas você terá que montar políticas e análises por conta própria.
#5 — Traefik
O que é. Um roteador/gateway de borda amigável para desenvolvedores com middlewares valiosos; você pode adicionar uma camada fina de IA para governar o egress de LLM e integrar com OpenTelemetry.
transparentes.
O que é. Gerenciamento de API com foco em políticas segurança e portal do desenvolvedor experiências. Bom para governança; combine com um agregador de IA se precisar de transparência do provedor pré-rota.
#7 — Apache APISIX
O que é. Gateway de alto desempenho, nativo da nuvem, com um rico ecossistema de plugins. Ótimo para equipes Lua/DIY que desejam controle. Você adicionará sua própria telemetria e lógica de roteamento.
#8 — KrakenD
O que é. Alta taxa de transferência compositor de API/gateway que suporta transformações e agregação. Ideal para equipes construindo uma borda unificada sobre muitos serviços.
#9 — AWS API Gateway
O que é. Gateway gerenciado dentro da AWS: políticas, autenticação, cotas, e integração próxima com a pilha AWS. Sem transparência de marketplace; combine com ShareAI quando precisar de roteamento de IA multi-provedor.
#10 — Gerenciamento de API do Azure
O que é. Gateway de API gerenciado para cargas de trabalho Azure; portal de desenvolvedor forte e políticas. Como outros gateways, é orientado pela governança—não um marketplace de provedores.
Tyk vs ShareAI
Se você precisar uma API sobre muitos provedores de IA com preços/transparência/latência/disponibilidade and failover instantâneo, escolha ShareAI. Se o seu principal requisito for Governança de API—credenciais centralizadas, aplicação de políticas e observabilidade—Tyk se encaixa nesse perfil. Muitas equipes os combinam: gateway para política organizacional + ShareAI para roteamento de marketplace.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Tyk
Equipes que desejam políticas e governança no nível do gateway
Traga seus próprios provedores
Políticas fortes e gerenciamento de chaves
Análise e monitoramento
Roteamento condicional via políticas/middlewares
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong
Empresas que precisam de política de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Apigee
Empresas que precisam de gerenciamento de API
BYO
Políticas e cotas granulares
Análises detalhadas
Complementos/retries
Não (infra)
n/d
NGINX
Equipes faça-você-mesmo (DIY)
BYO
Filtros personalizados
Complementos/personalizados
Personalizado
Não (DIY)
n/d
Traefik
Operações amigáveis para desenvolvedores
BYO
Credenciais/política centralizadas
Compatível com OTel
Roteamento condicional
Não (infra)
n/d
Gravitee
Organizações focadas em segurança
BYO
Política em primeiro lugar
Portal + análises
Plugins/retries
Não
n/d
APISIX
Orientado para desempenho
BYO
Baseado em plugins
Ferramentas da comunidade
Lua/personalizado
Não
n/d
KrakenD
Fãs de composição de API
BYO
Baseado em configuração
Plugins
Cache/retries
Não
n/d
AWS / Azure
Organizações centradas na nuvem
BYO
Políticas gerenciadas
Monitores de nuvem
Repetições/alternativas
Não
n/d
TL;DR — Gateways governar; ShareAI roteia inteligentemente entre provedores com transparência pré-rota and failover instantâneo.
Preços e TCO: comparar real custos (não apenas preços unitários)
Bruto $/1K tokens oculta a imagem real. TCO mudanças com tentativas novamente/fallbacks, latência (que afeta o comportamento do usuário), variação do provedor, armazenamento de observabilidade, e avaliação executa. Um transparente 7. . Se você já usa APISIX/APIs, reconhecerá a abordagem de plano de controle/plano de dados e o modelo de plugins. ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimizar para 10. Comunidade e economia (Playground + introduções rápidas). Escala média (~2M tokens/dia): O roteamento/failover guiado pelo mercado pode reduzir 10–20% enquanto melhora o UX. Cargas de trabalho pontiagudas: Espere custos efetivos de tokens mais altos de novas tentativas durante o failover; planeje orçamento para isso.
Guia de migração: movendo-se para (ou emparelhando com) ShareAI
De Tyk
Mantenha políticas no nível do gateway onde elas brilham; adicione ShareAI 3. para roteamento de marketplace + failover instantâneo. Padrão: autenticação/política do gateway → rota ShareAI por modelo → medir estatísticas do mercado → apertar políticas.
De Kong / Apigee / NGINX / Traefik / Gravitee / APISIX / KrakenD / AWS / Azure
Defina expectativas de paridade de recursos (análises, guardrails, orquestração, plugins). Muitas equipes executam híbrido: mantenha recursos especializados onde eles são mais fortes; use ShareAI 3. para escolha de provedor transparente e failover.
De OpenRouter / Eden AI
Mapear nomes de modelos, verificar paridade de prompts, então sombrear 10% o tráfego e aumentar gradualmente 25% → 50% → 100% enquanto os orçamentos de latência/erro se mantêm. As estatísticas do Marketplace tornam as trocas de provedores diretas.
De LiteLLM
Substituir o proxy auto-hospedado nas rotas de produção que você não deseja operar; manter LiteLLM para desenvolvimento, se desejado. Comparar sobrecarga de operações vs. benefícios de roteamento gerenciado.
De Unify / Orq / Portkey
Esclarecer escopo: avaliação/orquestração/regras vs roteamento/marketplace. Você pode mantê-los junto ao ShareAI; roteie via ShareAI quando precisar diversidade de provedores and failover rápido.
Início rápido para desenvolvedores (copiar-colar)
Os exemplos a seguir usam um Compatível com OpenAI superfície. Substituir YOUR_KEY com sua chave ShareAI — obtenha uma em Criar Chave de API.
#!/usr/bin/env bash
# cURL — Chat Completions via ShareAI
# Prereqs:
#   export SHAREAI_API_KEY="YOUR_KEY"

curl -X POST "https://api.shareai.now/v1/chat/completions" \
  -H "Authorization: Bearer $SHAREAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-70b",
    "messages": [
      { "role": "user", "content": "Give me a short haiku about reliable routing." }
    ],
    "temperature": 0.4,
    "max_tokens": 128
  }'
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados, por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompts/respostas; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento consistentemente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — Tyk vs outros concorrentes
Tyk vs ShareAI — qual para roteamento de IA multi-provedor? CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. Tyk é um governança de saída ferramenta (credenciais/política centralizadas; análises). Muitas equipes usam ambos.
Tyk vs Kong — dois gateways Ambos são gateways (políticas, plugins, análises), não marketplaces. Se você também quiser roteamento transparente multi-provedor and failover instantâneo, adicione ShareAI junto ao seu gateway.
Tyk vs Apigee — gerenciamento de API vs roteamento específico de IA Apigee é gerenciamento amplo de API; Tyk é uma pilha de gateway mais enxuta. Para acesso independente de provedor com estatísticas de marketplace ao vivo, use ShareAI além disso.
Tyk vs NGINX — faça você mesmo vs solução pronta NGINX permite filtros/políticas DIY; Tyk oferece recursos de gateway empacotados. Para evitar Lua personalizada e ainda obter seleção de provedor transparente, camada em ShareAI.
Tyk vs Traefik — roteador de borda vs gateway Traefik é um roteador de borda amigável para desenvolvedores; Tyk é uma plataforma de gateway. Nenhum é um marketplace. Use ShareAI para uma API única, IA de múltiplos provedores com failover instantâneo.
Tyk vs Gravitee — política-primeiro vs política-primeiro Ambos enfatizam governança. Sua escolha pode depender de plugins, UI e portal. Para transparência do provedor antes da rota, adicione ShareAI.
Tyk vs Apache APISIX — orientado por plugins vs produtizado APISIX é de alto desempenho e centrado em plugins; Tyk é mais produtizado. Nenhum oferece um marketplace de provedores—combine qualquer um com ShareAI.
Tyk vs KrakenD — composição de API vs gerenciamento KrakenD é excelente em agregação e transformação; Tyk em políticas e análises. ShareAI complementa qualquer um com roteamento de marketplace.
Tyk vs AWS API Gateway — escolha nativa da nuvem Se você está totalmente integrado ao AWS, AWS API Gateway é conveniente. Para IA multi-provedor com custos/latência transparentes and failover, adicione ShareAI.
Tyk vs Azure API Management — escolha nativa do Azure APIM integra-se estreitamente com o Azure. Como acima, use ShareAI 3. para diversidade de modelos/provedores and failover rápido.
Tyk vs OpenRouter — acesso rápido multi-modelo ou controles de gateway? OpenRouter torna o acesso a múltiplos modelos rápido; Tyk centraliza políticas. Se você também deseja transparência pré-rota and failover instantâneo, ShareAI combina acesso multi-provedor com uma visão de marketplace and roteamento resiliente.
Tyk vs Eden AI — muitos serviços de IA ou controle de saída? Eden IA agrega vários serviços de IA (LLM, imagem, TTS). Tyk centraliza políticas/credenciais. Para preços/latência transparentes em muitos provedores além de failover instantâneo, escolha ShareAI.
Tyk vs Portkey — trilhos de segurança vs governança Ambos enfatizam governança and observabilidade; profundidade e ergonomia diferem. Se sua principal necessidade é escolha transparente de provedores and failover, adicione ShareAI.
Tyk vs LiteLLM — proxy auto-hospedado ou governança gerenciada? LiteLLM é um proxy DIY que você opera; Tyk é governança/observabilidade gerenciada para saída de API. Se você preferir não executar um proxy e quiser roteamento orientado por marketplace, escolha ShareAI.
Tyk vs Unify — seleção de melhor modelo vs aplicação de políticas? Unificar foca em seleção de modelo orientada por avaliação; Tyk em política/observabilidade. Para uma API sobre muitos provedores com estatísticas de marketplace ao vivo, use ShareAI.
Tyk vs Orq — orquestração vs saída Orq ajuda a orquestrar fluxos; Tyk governa o tráfego de saída. ShareAI complementa qualquer um com roteamento transparente multi-provedor.
Fatos do provedor (ShareAI)
Qualquer pessoa pode participar como Comunidade ou Empresa provedor.
Aplicativos de integração: Windows, Ubuntu, macOS, Docker.
Modos de contribuição: explosões de tempo ocioso ou sempre ativo.
Incentivos: Recompensas (ganhar dinheiro), Trocar (ganhe tokens para usar depois), Missão (doe % para ONGs).
Benefícios à medida que você cresce: definir seus próprios preços de inferência, exposição preferencial, e mais. Saiba mais
Se você está avaliando Alternativas ao Pomerium, este guia mapeia o cenário como um construtor faria. Primeiro, esclarecemos o que é o Agentic Access Gateway do Pomerium—uma camada de acesso orientada por identidade e políticas para tráfego de agentes/LLM—depois comparamos o 10 melhores alternativas ao Pomerium. Colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores, dados transparentes de mercado (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) antes do roteamento, failover instantâneo, e economia impulsionada por pessoas (70% dos gastos fluem para provedores que mantêm os modelos online).
O que é (e o que não é) o Agentic Access Gateway do Pomerium
Pomerium está no gateway/governança caminho. Ele centraliza credenciais e políticas, aplica decisões de acesso e expõe observabilidade para que cada endpoint de IA/agente possa ser gerenciado ao longo do ciclo de vida como uma API. Isso é uma combinação forte quando identidade, SSO e conformidade de políticas são suas primeiras prioridades.
Não é um 7. . Se você já usa APISIX/APIs, reconhecerá a abordagem de plano de controle/plano de dados e o modelo de plugins. que mostra preço/latência/tempo de atividade/disponibilidade/tipo de provedor antes de você rotear, nem fornece nativamente roteamento inteligente multi-provedor e failover instantâneo. Se você deseja essas capacidades, você combinará um gateway com um agregador como o ShareAI.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores de LLM: uma API em vários provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) mais roteamento inteligente/failover para equilibrar custo e UX.
Gateways de IA/Acesso: política e governança na borda (credenciais, SSO, limites de taxa, trilhos de proteção) com observabilidade; você traz os provedores. Pomerium está nesta categoria.
Plataformas de agente/chatbot: UX empacotado (memória/ferramentas/canais) para construir assistentes. Eles não são marketplaces e frequentemente assumem um único upstream.
Como avaliamos as melhores alternativas ao Pomerium
Amplitude e neutralidade do modelo: proprietário + aberto; troca fácil; sem reescritas.
Latência e resiliência: políticas de roteamento; timeouts/retries; failover instantâneo.
2. Governança e segurança: gerenciamento de chaves, SSO, escopos, roteamento regional.
Observabilidade: logs/traces; dashboards de custo e latência.
5. Transparência de preços e TCO: escolha rotas com olhos abertos.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
11. — se seus gastos: seus gastos aumenta o fornecimento (por exemplo, incentivos para proprietários de GPU)?
Top 10 alternativas ao Pomerium
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. Uma API multi-provedor com um mercado transparente and roteamento inteligente. Com uma integração, você pode navegar por um grande catálogo de modelos/provedores, comparar preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm os modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é o ajuste direto. Mantenha um gateway se precisar de políticas para toda a organização; adicione o ShareAI para roteamento guiado por marketplace.
Uma API → 150+ modelos entre muitos provedores; sem reescritas, sem dependência.
Mercado transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: 70% dos gastos vai para provedores (comunidade ou empresa).
Para provedores: ganhe mantendo os modelos online. Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre-se via Windows, Ubuntu, macOS ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doe % para ONGs). À medida que você escala, pode definir seus próprios preços de inferência e ganhar exposição preferencial. Painel do Provedor.
#2 — OpenRouter
O que é. Uma API unificada para muitos modelos—excelente para experimentos rápidos e acesso a um amplo catálogo.
Onde se encaixa. Use-o quando você quiser uma única chave e um amplo menu de modelos. Adicione o ShareAI quando precisar transparência pré-rota and failover instantâneo controlar o TCO e a UX.
#3 — Traefik AI Gateway
O que é. Governança de saída de IA no topo do Traefik Hub com middlewares especializados e observabilidade compatível com OTel.
Onde se encaixa. Ótimo quando você precisa de políticas centralizadas, credenciais e rastreamentos na borda. Combine com o ShareAI para obter roteamento de marketplace entre muitos provedores.
#4 — Kong AI Gateway
O que é. Gateway empresarial com plugins avançados, políticas e análises.
Onde se encaixa. Use para profundidade de políticas na borda; combine com o ShareAI para roteamento agnóstico de provedores e visibilidade no marketplace.
#5 — Chave de Portal
O que é. Gateway de IA enfatizando limites, governança e rastreamentos detalhados—popular em ambientes regulamentados.
Onde se encaixa. Adicione ShareAI para seleção de provedor transparente and failover se você quiser equilibrar segurança com custo/latência.
#6 — Eden IA
O que é. Agregador entre LLMs e IA mais ampla (visão/TTS/tradução).
Onde se encaixa. Útil para projetos de múltiplas capacidades. Se você precisar transparência pré-rota e resiliência em muitos provedores, ShareAI fornece essa visão e controle de roteamento.
#7 — LiteLLM
O que é. SDK leve + proxy auto-hospedável que utiliza uma interface compatível com OpenAI.
Onde se encaixa. Ótimo para fluxo de desenvolvimento DIY. Mantenha-o para desenvolvimento; use ShareAI para roteamento gerenciado e dados de marketplace em produção.
#8 — Unify
O que é. Roteamento e avaliação orientados à qualidade para escolher melhores modelos por prompt.
Onde se encaixa. Combine com ShareAI para uma cobertura mais ampla de provedores e estatísticas de marketplace ao vivo quando custo/latência/disponibilidade forem importantes.
#9 — Apache APISIX
O que é. Gateway de API de propósito geral e alto desempenho com plugins avançados.
Onde se encaixa. Ideal para controle de borda DIY; adicione ShareAI quando precisar de roteamento LLM multi-provedor transparente em vez de codificar manualmente um único upstream.
#10 — NGINX
O que é. Camada web testada em batalha que você pode estender para tráfego LLM (roteamento personalizado, aplicação de tokens, cache).
Onde se encaixa. Para menos cola personalizada e mais escolha transparente de provedores, emparelhe seu front NGINX com o ShareAI.
Pomerium vs ShareAI (resumo rápido)
Se você precisar uma API sobre muitos provedores com preços/latência/tempo de atividade transparentes and failover instantâneo, escolha o ShareAI. Se sua principal exigência for governança de saída—credenciais centralizadas, acesso consciente de identidade e observabilidade compatível com OTel—o Pomerium se encaixa nesse perfil. Muitas equipes combinam eles: gateway para política organizacional + ShareAI para roteamento de marketplace.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Pomerium
Equipes que desejam governança de saída consciente de identidade
Não (ferramenta de infraestrutura, não um marketplace)
n/d
OpenRouter
Desenvolvedores que desejam uma única chave
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Apache APISIX
Empresas / DIY
BYO
Políticas
Complementos
Personalizado
n/d
n/d
NGINX
Faça você mesmo
BYO
Personalizado
Complementos
Personalizado
n/d
n/d
Preços e TCO: comparar real custos (não apenas preços unitários)
Bruto $ / 1K tokens esconde o quadro real. O TCO efetivo muda com novas tentativas/alternativas, latência (o que afeta o uso e o abandono), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. A mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimize para o tempo-para-primeiro-token — comece no Playground e use os quickstarts.
Escala média (~2M tokens/dia): Orientado pelo marketplace roteamento/failover pode reduzir 10–20% enquanto melhora a UX.
Cargas de trabalho irregulares: Espere custos efetivos mais altos de tokens devido a tentativas durante o failover; planeje o orçamento para isso.
Guia de migração: movendo para ShareAI
Do Pomerium
Mantenha políticas no nível do gateway onde elas brilham; adicione ShareAI para roteamento de marketplace + failover instantâneo. Padrão: autenticação/política no gateway → rota ShareAI por modelo → medir estatísticas do marketplace → ajustar políticas conforme você aprende.
Do OpenRouter
Mapeie nomes de modelos, verifique a paridade de prompts, depois sombreie 10% do tráfego e aumente 25% → 50% → 100% conforme os orçamentos de latência/erro forem mantidos. Os dados do marketplace tornam as trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado em rotas de produção que você não deseja operar; mantenha o LiteLLM para desenvolvimento, se desejado. Compare a sobrecarga operacional com os benefícios do roteamento gerenciado.
De Unify / Portkey / Kong
Definir expectativas de paridade de recursos (análises, guardrails, orquestração, plugins). Muitas equipes operam de forma híbrida: mantenha recursos especializados onde são mais fortes; use ShareAI para escolha transparente de provedores and failover.
Início rápido para desenvolvedores (copiar-colar)
Esses exemplos usam uma interface compatível com OpenAI. Substitua YOUR_KEY com sua chave ShareAI — obtenha uma em Criar Chave de API. Veja o Referência da API para detalhes.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados e por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompts/respostas; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento de forma consistente (OTel).
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — Pomerium vs outros (e concorrente-vs-concorrente)
Pomerium vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. Pomerium é um governança de saída ferramenta (credenciais/política centralizadas; acesso consciente de identidade; observabilidade compatível com OTel). Muitas equipes usam ambos.
Pomerium vs OpenRouter — acesso multi-modelo rápido ou controles de gateway?
OpenRouter torna o acesso a múltiplos modelos rápido; Pomerium centraliza política/observabilidade. Se você também quiser transparência pré-rota e failover instantâneo, ShareAI combina acesso multi-provedor com uma visão de marketplace e roteamento resiliente.
Pomerium vs Traefik AI Gateway — dois gateways, controles específicos para IA
Ambos são gateways (políticas/guardrails/observabilidade). Se você também precisar de roteamento com transparência, combine o gateway com ShareAI.
Pomerium vs Kong AI Gateway — profundidade de política e plugins
Kong oferece plugins/políticas avançadas de borda; Pomerium foca em acesso consciente de identidade. Para escolha transparente de provedores and failover, adicione ShareAI.
Pomerium vs Portkey — quem é mais forte em guardrails?
Ambos enfatizam governança e rastreamento; profundidade/ergonomia diferem. Se sua principal necessidade for seleção de provedor transparente and failover instantâneo, use ShareAI ao lado de qualquer um.
Pomerium vs Eden AI — muitos serviços de IA ou controle de saída?
Eden IA agrega múltiplos serviços de IA; Pomerium governa a saída. Para transparência de preços/latência entre muitos provedores, escolha ShareAI.
Pomerium vs LiteLLM — proxy auto-hospedado ou governança gerenciada?
LiteLLM é um proxy DIY; Pomerium é governança/observabilidade gerenciada. Se você prefere não executar um proxy and deseja roteamento orientado por marketplace, escolha ShareAI.
Pomerium vs Unify — orientado por avaliação vs orientado por política
Unificar foca na seleção de modelos baseada em avaliação; Pomerium em política/observabilidade. Para uma API com estatísticas de mercado ao vivo, escolha ShareAI.
Pomerium vs Apache APISIX — gateway DIY vs acesso consciente de identidade
APISIX é um gateway geral de API; Pomerium centra-se no acesso consciente de identidade. Necessidade roteamento LLM multi-provedor transparente? Uso ShareAI.
Pomerium vs NGINX
NGINX é DIY (Lua personalizada, políticas, cache); Pomerium é uma camada de acesso empacotada. Para evitar cola personalizada e ainda obter seleção de provedor transparente, camada em ShareAI.
Se você está avaliando Alternativas ao GitLab AI Gateway, este guia mapeia o cenário como um construtor faria. Primeiro, esclarecemos qual é a linha do AI Gateway do GitLab—governança de saída (credenciais/políticas centralizadas), uma camada de controle consciente de LLM, e observabilidade—então comparamos o 10 melhores alternativas. Colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores, um mercado transparente com preço / latência / tempo de atividade / disponibilidadeantes roteamento, failover instantâneo, e economia impulsionada por pessoas (70% de cada dólar retorna para os provedores—comunidade ou empresa).
O que é (e o que não é) o GitLab AI Gateway
O que é. Uma camada focada em governança, direcionada ao roteamento de tráfego de IA com políticas, gerenciamento de chaves e observabilidade—para que as equipes de aplicação possam controlar o uso de LLM com a mesma disciplina que aplicam a qualquer API de produção.
O que não é. Um mercado neutro que ajuda você a escolha provedores/modelos com base em preço em tempo real, latência, tempo de atividade e disponibilidade ou falha automática através de vários provedores. Gateways padronizam o controle; agregadores otimizam escolha e resiliência.
Agregadores vs Gateways vs Plataformas de agentes (resumo rápido)
Agregadores LLM. Uma API através de muitos modelos/provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor), além de roteamento inteligente/failover.
Gateways de IA.Política/governança na borda (credenciais, limites de taxa, trilhos de segurança), além de observabilidade. Você traz seus provedores. O Gateway de IA do GitLab vive aqui.
Plataformas de agentes/chatbots. UX empacotado, memória/ferramentas, canais—ótimo para assistentes de usuários finais, não para roteamento agnóstico de provedores.
Como avaliamos as melhores alternativas ao Gateway de IA do GitLab
Amplitude do modelo e neutralidade. Proprietário + aberto; alterne provedores sem reescritas.
Latência e resiliência. Políticas de roteamento, timeouts, tentativas., failover instantâneo.
Governança e segurança. Manipulação de chaves, escopos, roteamento regional, trilhos de proteção.
Observabilidade. Logs/rastreamentos e painéis de custo/latência.
Transparência de preços e TCO. Comparar real custos antes de rotear.
Experiência do desenvolvedor. Documentação, SDKs, inícios rápidos; 10. Comunidade e economia.
Comunidade e economia. Se seus gastos aumentam a oferta (incentivos para proprietários de GPUs; divisão justa de receita).
Top 10 alternativas ao GitLab AI Gateway
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, o ShareAI é o ajuste mais direto. Mantenha um gateway se precisar de políticas para toda a organização; adicione o ShareAI para roteamento guiado por marketplace and “disponibilidade ”sempre ativa” entre provedores.
Uma API → 150+ modelos entre muitos provedores; sem reescritas, sem dependência.
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa:70% dos gastos vão para os provedores, retornando valor à comunidade.
Para provedores: ganhe mantendo modelos online Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS, ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens / AI Prosumer), ou Missão (doe 1% para ONGs). À medida que você escala, definir seus próprios preços de inferência e ganhar exposição preferencial. Guia do Provedor · Entrar / Registrar-se
#2 — Kong AI Gateway
Gateway de IA/LLM empresarial—políticas/plugins fortes, análises e observabilidade para tráfego de IA. É um plano de controle em vez de um marketplace.
#3 — Portkey
Gateway de IA enfatizando observabilidade, limites de segurança, e governança—popular onde a conformidade é rigorosa.
#4 — OpenRouter
API unificada sobre muitos modelos; excelente para experimentação rápida em um amplo catálogo.
#5 — Eden AI
Agrega LLMs além de IA mais ampla (visão, tradução, TTS), com fallback/cache e agrupamento.
#6 — LiteLLM
Leve SDK + proxy auto-hospedável expondo uma interface compatível com OpenAI para muitos provedores.
#7 — Unify
Roteamento e avaliação orientados à qualidade para escolher melhores modelos por prompt.
#8 — Orq AI
Plataforma de orquestração/colaboração para mover experimentos → produção com fluxos de baixo código.
#9 — Apigee (com LLMs por trás)
Gerenciamento/gateway de API maduro que você pode colocar na frente de provedores de LLM para aplicar políticas, chaves e cotas.
#10 — NGINX
Caminho DIY: construa roteamento personalizado, aplicação de tokens e cache para backends de LLM se preferir controle rigoroso.
GitLab AI Gateway vs ShareAI (resumo): Necessidade uma API sobre muitos provedores com transparência de marketplace e failover instantâneo? Escolha ShareAI. Necessidade governança de egressos—credenciais centralizadas, política, observabilidade—e você já escolheu seus provedores? Portal de IA do GitLab se encaixa nesse perfil. Muitas equipes os combinam: gateway para política organizacional + ShareAI para roteamento guiado pelo marketplace.
Comparação rápida (de relance)
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Portal de IA do GitLab
Equipes que desejam governança de saída
Provedores próprios
Credenciais/políticas centralizadas
Métricas/rastreamento
Roteamento condicional via políticas
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
OpenRouter
Desenvolvedores que desejam uma chave para muitos modelos
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Equipes com foco em orquestração
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Apigee / NGINX
Empresas / DIY
BYO
Políticas
Complementos / personalizados
Personalizado
n/d
n/d
Preços e TCO: comparar real custos (não apenas preços unitários)
Bruto $/1K tokens esconde a verdadeira imagem. O TCO muda com novas tentativas/alternativas, latência (o que afeta o uso), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. Um marketplace transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimizar para 10. Comunidade e economia (Playground, quickstarts).
Escala média (~2M tokens/dia): O roteamento/failover guiado pelo Marketplace pode reduzir 10–20% enquanto melhorando o UX.
Cargas de trabalho irregulares: Espere custos efetivos de tokens mais altos devido a novas tentativas durante o failover—planeje o orçamento para isso.
Playbooks de migração: mudando para ShareAI
Do GitLab AI Gateway
Mantenha políticas no nível do gateway onde elas se destacam. Adicione ShareAI para roteamento de marketplace + failover instantâneo. Padrão: gateway auth/policy → Rota ShareAI por modelo → medir estatísticas do marketplace → apertar políticas.
Do OpenRouter
Mapear nomes de modelos, verificar paridade de prompts, então sombrear 10% o tráfego e aumentar gradualmente 25% → 50% → 100% conforme os orçamentos de latência/erro se mantêm. Dados do marketplace tornam trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado em produção rotas que você não deseja operar; mantenha LiteLLM para dev se desejado. Compare sobrecarga de operações vs. benefícios de roteamento gerenciado.
De Unify / Portkey / Orq / Kong
Defina paridade de recursos expectativas (análises, limites, orquestração, plugins). Muitas equipes operam de forma híbrida: mantêm recursos especializados onde são mais fortes; usam ShareAI 3. para escolha transparente de provedores and failover.
Início rápido para desenvolvedores (copiar-colar)
O seguinte usa uma Compatível com OpenAI superfície. Substituir YOUR_KEY pela sua chave ShareAI—obtenha uma em Criar Chave de API.
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde os prompts/respostas são armazenados, por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompt/resposta; capacidade de filtrar/pseudonimizar; propagar IDs de rastreamento consistentemente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — GitLab AI Gateway vs outros concorrentes
GitLab AI Gateway vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. GitLab AI Gateway é governança de saída (credenciais centralizadas, política, observabilidade). Muitas equipes usam ambos.
GitLab AI Gateway vs OpenRouter — acesso rápido a múltiplos modelos ou controles de gateway?
OpenRouter torna o acesso a múltiplos modelos rápido; GitLab centraliza políticas e observabilidade. Se você também quiser transparência pré-rota and failover instantâneo, ShareAI combina acesso multi-provedor com uma visão de marketplace e roteamento resiliente.
GitLab AI Gateway vs Eden AI — muitos serviços de IA ou controle de saída?
Eden IA agrega vários serviços de IA (LLM, imagem, TTS). GitLab centraliza políticas/credenciais. Para preços/latência transparentes entre muitos provedores e failover instantâneo, escolha ShareAI.
GitLab AI Gateway vs LiteLLM — proxy auto-hospedado ou governança gerenciada?
LiteLLM é um proxy DIY que você opera; GitLab é governança/observabilidade gerenciada para saída de IA. Se você preferir não operar um proxy and quiser roteamento orientado por marketplace, escolha ShareAI.
GitLab AI Gateway vs Portkey — quem é mais forte em guardrails?
Ambos enfatizam governança/observabilidade; profundidade e ergonomia diferem. Se sua principal necessidade for escolha de provedor transparente + failover, adicione ShareAI.
GitLab AI Gateway vs Unify — melhor seleção de modelo vs aplicação de políticas?
Unificar foca na seleção de modelo baseada em avaliação; GitLab foca-se em política/observabilidade. Para uma API sobre muitos provedores com estatísticas de marketplace ao vivo, use ShareAI.
GitLab AI Gateway vs Orq — orquestração vs saída?
Orq ajuda a orquestrar fluxos de trabalho; GitLab governa o tráfego de saída. ShareAI complementa qualquer um com roteamento de marketplace.
GitLab AI Gateway vs Kong AI Gateway — dois gateways
Ambos são gateways (políticas, plugins, análises), não marketplaces. Muitas equipes combinam um gateway com ShareAI 3. para roteamento transparente multi-provedor and failover.
GitLab AI Gateway vs Traefik AI Gateway — middlewares especializados em IA ou plataforma mais ampla?
Traefik's camada fina de IA e middlewares especializados combinam bem com ShareAI’transparência do marketplace; GitLab fornece governança dentro do ecossistema GitLab.
GitLab AI Gateway vs Apigee — gerenciamento de API vs saída específica de IA
Apigee é gerenciamento amplo de API; GitLab é governança de saída focada em IA dentro do seu fluxo DevOps. Se você precisar acesso independente de provedor com transparência de marketplace, use ShareAI.
GitLab AI Gateway vs NGINX — faça você mesmo vs solução pronta
NGINX oferece filtros/políticas DIY; GitLab oferece uma camada empacotada. Para evitar scripts personalizados and obter seleção de provedor transparente, camada em ShareAI.
OpenRouter vs Apache APISIX — velocidade de marketplace ou política de borda?
OpenRouter acelera a experimentação de modelos; APISIX é um gateway programável. Se você também quiser transparência de preço/latência pré-rota com failover instantâneo, use ShareAI.
LiteLLM vs OpenRouter — proxy DIY ou agregador hospedado?
LiteLLM oferece um proxy auto-hospedado; OpenRouter hospeda agregação. ShareAI adiciona estatísticas de marketplace ao vivo + failover e retorna 70% da receita para os provedores—retribuir à comunidade.
Kong vs Apache APISIX — plugins empresariais ou edge de código aberto?
Ambos são gateways fortes. Se você quiser escolha transparente de provedores and resiliência multi-provedor, roteie através ShareAI e mantenha seu gateway para políticas.
Portkey vs Unify — trilhos de proteção vs seleção orientada pela qualidade?
Portkey inclina-se para trilhos de proteção/observabilidade; Unificar para seleção de qualidade do modelo. ShareAI traz transparência de mercado and roteamento resiliente para qualquer uma das pilhas.
NGINX vs Apache APISIX — dois caminhos DIY
Ambos exigem investimento em engenharia. Se você preferir delegar roteamento multi-provedor + failover e manter a política na borda, adicione ShareAI.
Se você está avaliando Alternativas ao WSO2, este guia mapeia o cenário da maneira que um construtor faria. Começamos esclarecendo onde um gateway como o WSO2 se encaixa—governança na borda, aplicação de políticas e observabilidade para tráfego de IA/LLM—e depois comparamos os 10 melhores Alternativas ao WSO2 AI Gateway. Colocamos ShareAI primeiro para equipes que desejam uma API única entre muitos provedores, um mercado transparente mostrando preço, latência, tempo de atividade e disponibilidade antes de roteamento, failover instantâneo e economia impulsionada por pessoas (70% de gastos vão para provedores).
A abordagem de AI/Gateway do WSO2 está enraizada na gestão clássica de APIs: credenciais centralizadas, controles de políticas e observabilidade para o tráfego que você envia aos modelos que escolhe. Esse é um plano de controle com foco em governança—você traz seus provedores e aplicação de regras na borda—em vez de um mercado de modelos transparente que ajuda você a comparar provedores e rotear inteligentemente entre muitos deles.
Se sua prioridade principal é governança em toda a organização, um gateway faz sentido. Se você deseja acesso independente de provedores com transparência pré-rota and failover automático, olhe para um agregador/marketplace como ShareAI—ou execute os dois lado a lado.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores / Marketplaces de LLM. Uma API sobre muitos modelos/provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover. Exemplo: ShareAI.
Gateways de IA.Governança na borda (chaves, limites de taxa, trilhos de segurança), além de observabilidade; você fornece os provedores. Exemplos: WSO2, Kong, Portkey.
Plataformas de Agente/Chatbot. UX empacotado (chat, ferramentas, memória, canais) voltado para assistentes de usuário final, não agregação agnóstica de provedores. Exemplo: Orq (primeiro na orquestração).
Como avaliamos as melhores alternativas ao WSO2
Amplitude do modelo e neutralidade. Modelos proprietários e abertos; troca fácil sem reescritas.
Latência e resiliência. Políticas de roteamento, timeouts, tentativas., failover instantâneo.
Governança e segurança. Manipulação de chaves, escopos, roteamento regional, limites de segurança.
Observabilidade. Logs/rastros e dashboards de custo/latência.
Transparência de preços e TCO. Comparar real 7. antes de rotear. antes de você rotear.
Experiência do desenvolvedor. Documentação clara, SDKs, inícios rápidos; 10. Comunidade e economia.
Comunidade e economia. Seu gasto aumenta o fornecimento (incentivos para proprietários/provedores de GPU)?
Top 10 Alternativas ao WSO2
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade e tipo de provedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência por padrão, ShareAI é o ajuste mais direto. Mantenha qualquer gateway que você já usa para políticas organizacionais; adicione ShareAI para roteamento guiado pelo marketplace.
Uma API → 150+ modelos entre muitos provedores; sem reescritas, sem dependência. → Navegar Modelos
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa:70% do gasto vai para provedores (comunidade ou empresa).
Para provedores: ganhe mantendo modelos online Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa—e integração via Windows, Ubuntu, macOS ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens / AI Prosumer), ou Missão (doar % para ONGs). À medida que você escala, você pode definir seus próprios preços de inferência e ganhar exposição preferencial. → Guia do Provedor
#2 — Kong AI Gateway
O que é. Gateway de IA/LLM empresarial—governança, políticas/plugins, análises e observabilidade na borda. Um plano de controle em vez de um marketplace.
#3 — Portkey
O que é. Gateway de IA enfatizando limites de segurança and observabilidade profunda, comum em indústrias regulamentadas.
#4 — OpenRouter
O que é. API unificada sobre muitos modelos; ótimo para experimentação rápida em um amplo catálogo.
#5 — Eden AI
O que é. Agrega LLMs e IA mais ampla (visão, tradução, TTS); oferece alternativas/cache e agrupamento.
#6 — LiteLLM
O que é. Um leve SDK Python + proxy auto-hospedável que utiliza uma interface compatível com OpenAI para muitos provedores.
#7 — Unify
O que é.Roteamento orientado à qualidade e avaliação para escolher melhores modelos por prompt.
#8 — Orq AI
O que é.Orquestração/colaboração plataforma para passar de experimentos para produção com fluxos de baixo código.
#9 — Apigee (com LLMs por trás)
O que é. Gerenciamento/gateway de API maduro que você pode colocar na frente de provedores de LLM para aplicar políticas, chaves e cotas.
#10 — NGINX
O que é.Controle DIY: construa roteamento personalizado, aplicação de tokens e cache para backends de LLM se preferir políticas feitas à mão.
WSO2 vs ShareAI (em resumo)
Se você precisar uma API entre muitos provedores com preços/latência/tempo de atividade transparentes and failover instantâneo, escolha ShareAI.
Se sua principal exigência for governança de saída—credenciais centralizadas, aplicação de políticas e observabilidade—WSO2 se encaixa nesse caminho.
Muitas equipes combinam eles: gateway para política organizacional + ShareAI para roteamento de marketplace.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
150+ modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
WSO2
Equipes que desejam governança de saída
Provedores próprios
Credenciais/políticas centralizadas
Métricas/rastreamento (gateway-primeiro)
Roteamento condicional via políticas
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
OpenRouter
Desenvolvedores que desejam uma chave para muitos modelos
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Equipes com foco em orquestração
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Apigee / NGINX
Empresas / DIY
BYO
Políticas
Complementos/personalizados
Personalizado
n/d
n/d
Preços e TCO: compare custos reais (não apenas preços unitários)
Bruto $/1K tokens pode esconder a imagem real. Seu TCO mudanças com novas tentativas/alternativas, latência (o que afeta o uso), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. A mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimizar para 10. Comunidade e economia. Use o Abrir Playground e os quickstarts.
Escala média (~2M tokens/dia): Orientado pelo marketplace roteamento/failover pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Espere custos efetivos de token mais altos de novas tentativas durante o failover; planeje o orçamento para isso.
Guia de migração: movendo para ShareAI
De WSO2
Mantenha políticas no nível do gateway onde elas brilham; adicione ShareAI para roteamento de marketplace + failover instantâneo. Padrão: autenticação/política do gateway → Rota ShareAI por modelo → medir estatísticas do marketplace → apertar políticas.
Do OpenRouter
Mapeie nomes de modelos, verifique a paridade de prompts, depois sombreie 10% do tráfego e aumente 25% → 50% → 100% conforme os orçamentos de latência/erro se mantêm. Dados do marketplace tornam trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado nas rotas de produção que você não deseja operar; mantenha LiteLLM para desenvolvimento, se desejado. Compare sobrecarga de operações vs roteamento gerenciado benefícios.
De Unify / Portkey / Orq / Kong
Defina paridade de recursos expectativas (análises, guardrails, orquestração, plugins). Muitas equipes executam híbrido: mantenha recursos especializados onde eles são mais fortes; use ShareAI 3. para escolha transparente de provedores and failover.
Início rápido para desenvolvedores (copiar-colar)
Use uma superfície compatível com OpenAI. Substitua YOUR_KEY pela sua chave ShareAI—obtenha uma em Criar Chave de API. Veja o Referência da API para detalhes.
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados; duração; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompt/resposta; capacidade de filtrar/pseudonimizar; propagar IDs de rastreamento consistentemente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — alternativas ao WSO2 e comparações
WSO2 vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. É construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor) e roteamento inteligente/failover entre muitos provedores. WSO2 é uma ferramenta de governança (credenciais/política centralizada; observabilidade orientada ao gateway). Muitas equipes usam ambos.
WSO2 vs Kong AI Gateway — quem é mais forte em políticas de borda?
Ambos são gateways; Kong é conhecido por um ecossistema profundo de plugins e políticas de borda, enquanto WSO2 alinha-se de perto com fluxos de trabalho de gerenciamento de API. Se você também quiser transparência pré-rota and failover instantâneo, camada em ShareAI.
WSO2 vs Portkey — governança e guardrails?
Portkey enfatiza guardrails e profundidade de rastreamento; WSO2 oferece governança orientada por políticas. Para 14. transparência pré-rota com estatísticas de marketplace e failover automático, adicione ShareAI.
WSO2 vs OpenRouter — amplitude do marketplace ou controle do gateway?
OpenRouter oferece um catálogo amplo de modelos; WSO2 centraliza políticas. Se você quiser amplitude + resiliência com métricas ao vivo do marketplace, ShareAI combina roteamento multi-provedor com dados transparentes pré-rota.
WSO2 vs Orq — orquestração vs saída?
Orq ajuda a orquestrar fluxos de trabalho; WSO2 governa a saída. Mantenha sua orquestração onde ela brilha e use ShareAI 3. para roteamento agnóstico de provedores com um visão de mercado.
Se você está pesquisando alternativas ao Orq AI Proxy, este guia mapeia o cenário da maneira que um construtor faria. Vamos rapidamente definir onde o Orq se encaixa (um proxy com foco em orquestração que ajuda equipes a passar de experimentos para produção com fluxos colaborativos), e então comparar o 10 melhores alternativas entre agregação, gateways e orquestração. Colocamos ShareAI em primeiro lugar para equipes que desejam uma API entre muitos provedores, sinais transparentes de mercado (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) antes do roteamento, failover instantâneo, e economia impulsionada por pessoas (provedores—comunidade ou empresa—ganham a maior parte dos gastos quando mantêm modelos online).
Proxy Orq AI está em uma plataforma com foco em orquestração. Ele enfatiza colaboração, fluxos e levar protótipos para produção. Você encontrará ferramentas para coordenar tarefas de múltiplas etapas, análises sobre execuções e um proxy que simplifica como as equipes entregam. Isso é diferente de um mercado de modelos transparente: visibilidade pré-roteamento em preço/latência/disponibilidade/tempo de atividade através muitos provedores—além disso roteamento inteligente e failover instantâneo—é onde uma API multi-provedor como ShareAI brilha.
Em resumo:
Orquestração-primeiro (Orq): envie fluxos de trabalho, gerencie execuções, colabore—útil se sua necessidade principal for ferramentas de fluxo.
Marketplace-primeiro (ShareAI): escolher melhor provedor/modelo adequado com sinais ao vivo and resiliência automática—útil se sua necessidade principal for roteamento entre provedores sem bloqueio.
Agregadores vs. Gateways vs. Plataformas de Orquestração
Agregadores de LLM (por exemplo, ShareAI, OpenRouter, Eden AI): Uma API para vários provedores/modelos. Com o ShareAI você pode comparar preço, latência, tempo de atividade, disponibilidade, tipo de provedor antes de encaminhar, então alternar instantaneamente se um provedor degradar.
Gateways de IA (por exemplo, Kong, Portkey, Traefik, Apigee, NGINX): Política/governança na borda (credenciais centralizadas, WAF/limites de taxa/barreiras), além de observabilidade. Você normalmente traz seus próprios provedores.
Plataformas de Orquestração (por exemplo, Orq, Unify; LiteLLM se proxy auto-hospedado): Foco em fluxos, ferramentas, e às vezes seleção de qualidade—ajudando equipes a estruturar prompts, ferramentas e avaliações.
Use-os juntos quando ajudar: muitas equipes mantenha um gateway para a política organizacional enquanto roteando via ShareAI para transparência e resiliência do marketplace.
Como avaliamos as melhores alternativas ao Orq AI Proxy
Amplitude e neutralidade do modelo: proprietário + aberto; fácil de alternar; reescritas mínimas.
Latência e resiliência: políticas de roteamento, timeouts/retries, failover instantâneo.
Governança e segurança: gerenciamento de chaves, escopos, roteamento regional.
Observabilidade: logs/traces e dashboards de custo/latência.
Transparência de preços & TCO: veja custos reais/compromissos de UX 8. — docs, SDKs, inícios rápidos;.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
Comunidade & economia: seu gasto aumenta a oferta (incentivos para proprietários/provedores de GPU)?
Top 10 alternativas ao Orq AI Proxy
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: provedores (comunidade ou empresa) ganham a maior parte do gasto quando mantêm os modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, ShareAI é o ajuste mais direto. Mantenha um gateway se precisar de políticas para toda a organização; adicione ShareAI para roteamento guiado por marketplace e melhor tempo de atividade/latência.
Uma API → 150+ modelos em vários provedores; sem reescritas, sem dependência.
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: impulsionado por pessoas—os provedores ganham quando mantêm os modelos disponíveis.
Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doe 1% para ONGs). À medida que você escala, definir seus próprios preços de inferência e ganhar exposição preferencial.
O que é. A API unificada sobre muitos modelos; ótimo para experimentação rápida em um amplo catálogo.
Quando escolher. Se você deseja acesso rápido a modelos diversos com configuração mínima.
Compare com ShareAI. ShareAI adiciona transparência do mercado antes do roteamento and failover instantâneo entre muitos provedores.
#3 — Portkey
O que é. Uma portal de IA enfatizando observabilidade, limites e governança.
Quando escolher. Ambientes regulados que exigem controles profundos de políticas/limites.
Compare com ShareAI. ShareAI foca em roteamento multi-provedor + transparência de mercado; combine com um gateway se precisar de políticas para toda a organização.
#4 — Kong AI Gateway
O que é. Uma gateway empresarial: políticas/plugins, análises e governança de borda para tráfego de IA.
Quando escolher. Se sua organização já utiliza Kong ou precisa de uma governança rica de API.
Compare com ShareAI. Adicione ShareAI para escolha transparente de provedores and failover; mantenha Kong para o plano de controle.
#5 — Eden AI
O que é. Uma agregador para LLMs e serviços de IA mais amplos (visão, TTS, tradução).
Quando escolher. Se você precisar de muitas modalidades de IA atrás de uma única chave.
Compare com ShareAI. ShareAI é especializado em transparência de marketplace 3. para roteamento de modelo entre provedores.
#6 — LiteLLM
O que é. A SDK leve + proxy auto-hospedável que utiliza uma interface compatível com OpenAI para muitos provedores.
Quando escolher. equipes DIY que desejam um proxy local que operem por conta própria.
Compare com ShareAI. ShareAI é gerenciado com dados de marketplace and failover; mantenha LiteLLM para desenvolvimento, se desejado.
#7 — Unify
O que é.Seleção orientada para qualidade e avaliação para escolher melhores modelos para cada prompt.
Quando escolher. Se você quiser roteamento orientado por avaliação.
Compare com ShareAI. ShareAI adiciona sinais de mercado ao vivo and failover instantâneo entre muitos provedores.
#8 — Orq (plataforma)
O que é.Orquestração/colaboração plataforma que ajuda equipes a passar de experimentos para produção com fluxos de baixo código.
Quando escolher. Se sua principal necessidade é orquestração de fluxo de trabalho e colaboração em equipe.
Compare com ShareAI. ShareAI é roteamento agnóstico de provedores com transparência pré-rota and failover; muitas equipes combinam Orq com ShareAI.
#9 — Apigee (com backends LLM)
O que é. A gerenciamento de API maduro plataforma que você pode colocar na frente de provedores LLM para aplicar políticas, chaves, cotas.
Quando escolher. Organizações empresariais padronizando o uso do Apigee para controle de API.
Compare com ShareAI. Adicione ShareAI para ganhar escolha transparente de provedores and failover instantâneo.
#10 — NGINX (DIY)
O que é. A borda faça-você-mesmo: publicar rotas, aplicação de token, cache com lógica personalizada.
Quando escolher. Se você preferir faça-você-mesmo completo e tiver largura de banda de operações.
Compare com ShareAI. Emparelhar com ShareAI evita lógica personalizada para seleção de provedor and failover.
Orq AI Proxy vs ShareAI (visão rápida)
Se você precisar uma API sobre muitos provedores com preço/transparência/latência/tempo de atividade/disponibilidade and failover instantâneo, escolha ShareAI. Se o seu principal requisito for orquestração e colaboração—fluxos, tarefas de múltiplas etapas e produção centrada na equipe—Orq se encaixa nesse caminho. Muitas equipes combinam eles: orquestração dentro do Orq + roteamento guiado por marketplace no ShareAI.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Preço, latência, tempo de atividade, disponibilidade, tipo de provedor
Sim—oferta aberta; provedores ganham
Orq (Proxy)
Equipes com foco em orquestração
Suporte amplo via fluxos
Controles da plataforma
Executar análises
Centrado em orquestração
Não é um marketplace
n/d
OpenRouter
Desenvolvedores que desejam uma única chave
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
Kong IA Gateway
Empresas que precisam de política de gateway
BYO
Políticas/plugins fortes na borda
Análises
Proxy/plugins, tentativas
Não (ferramenta de infraestrutura)
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Apigee / NGINX
Empresas / DIY
BYO
Políticas
Complementos / personalizados
Personalizado
n/d
n/d
Preços e TCO: compare custos reais (não apenas preços unitários)
Bruto $/1K tokens oculta a imagem real. TCO mudanças com novas tentativas/alternativas, latência (o que afeta o uso pelo usuário final), variação do provedor, armazenamento de observabilidade, e execuções de avaliação. A mercado transparente ajuda você a escolher rotas que equilibram custo and UX.
Protótipo (~10k tokens/dia): Otimizar para 10. Comunidade e economia (Playground, quickstarts).
Escala média (~2M tokens/dia):Roteamento guiado pelo marketplace + failover pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Espere maior eficaz custos de token de novas tentativas durante o failover; orçamento para isso.
Guia de migração: movendo para ShareAI
De Orq
Mantenha a orquestração do Orq onde ela brilha; adicione ShareAI 3. para roteamento agnóstico de provedores and seleção transparente. Padrão: orquestração → rota ShareAI por modelo → observar estatísticas do marketplace → apertar políticas.
Do OpenRouter
Mapear nomes de modelos, verificar paridade de prompts, então sombrear 10% o tráfego e aumentar gradualmente 25% → 50% → 100% conforme os orçamentos de latência/erro se mantêm. Dados do marketplace tornam trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado nas rotas de produção que você não deseja operar; mantenha LiteLLM para desenvolvimento, se desejado. Compare sobrecarga de operações vs. benefícios de roteamento gerenciado.
De Unify / Portkey / Kong / Traefik / Apigee / NGINX
Defina expectativas de paridade de recursos (análises, guardrails, orquestração, plugins). Muitas equipes operam de forma híbrida: mantenha recursos especializados onde são mais fortes; use ShareAI 3. para escolha de provedor transparente + failover.
Início rápido para desenvolvedores (copiar-colar)
O seguinte usa uma superfície compatível com OpenAI. Substituir YOUR_KEY pela sua chave ShareAI—obtenha uma em Criar Chave de API.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
// process.env.SHAREAI_API_KEY = "YOUR_KEY"
async function main() {
const res = await fetch("https://api.shareai.now/v1/chat/completions", {
method: "POST",
headers: {
"Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
"Content-Type": "application/json"
},
body: JSON.stringify({
model: "llama-3.1-70b",
messages: [
{ role: "user", content: "Give me a short haiku about reliable routing." }
],
temperature: 0.4,
max_tokens: 128
})
});
if (!res.ok) {
console.error("Request failed:", res.status, await res.text());
return;
}
const data = await res.json();
console.log(JSON.stringify(data, null, 2));
}
main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados, e por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompts/respostas; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento de forma consistente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — Orq AI Proxy vs outros concorrentes
Orq AI Proxy vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. Orq foca em orquestração e colaboração. Muitas equipes executam Orq + ShareAI juntos.
Orq AI Proxy vs OpenRouter — acesso rápido a múltiplos modelos ou transparência de marketplace?
OpenRouter torna o acesso multi-modelo rápido; ShareAI camadas em transparência pré-rota and failover instantâneo entre provedores.
Orq AI Proxy vs Portkey — guardrails/governança ou roteamento de marketplace?
Portkey enfatiza governança e observabilidade. Se você precisar escolha transparente de provedores and failover com uma API, escolha ShareAI (e você ainda pode manter um gateway).
Orq AI Proxy vs Kong AI Gateway — controles de gateway ou visibilidade de marketplace?
Kong centraliza políticas/plugins; ShareAI fornece roteamento agnóstico de provedores com estatísticas de marketplace ao vivo—frequentemente emparelhados juntos.
Orq AI Proxy vs Traefik AI Gateway — camada fina de IA ou roteamento de marketplace?
A camada de IA do Traefik adiciona middlewares específicos de IA and Observabilidade compatível com OTel. Para seleção de provedor transparente and failover instantâneo, use ShareAI.
Orq AI Proxy vs Eden AI — muitos serviços de IA ou neutralidade de provedores?
Eden agrega múltiplos serviços de IA. ShareAI foca em roteamento de modelo neutro com transparência pré-rota.
Orq AI Proxy vs LiteLLM — proxy auto-hospedado ou marketplace gerenciado?
LiteLLM é Faça você mesmo; ShareAI é gerenciado com dados de marketplace and failover. Mantenha o LiteLLM para desenvolvimento, se preferir.
Orq AI Proxy vs Unify — seleção de modelos baseada em avaliação ou roteamento de marketplace?
Unify aposta em avaliação de qualidade; ShareAI adiciona sinais ao vivo de preço/latência/disponibilidade and failover instantâneo entre provedores.
Orq AI Proxy vs Apigee — gerenciamento de API ou roteamento agnóstico de provedores?
Apigee é gerenciamento amplo de API. ShareAI oferece roteamento transparente e multi-fornecedor você pode colocar atrás do seu gateway.
Orq AI Proxy vs NGINX — edge DIY ou roteamento gerenciado?
NGINX oferece filtros/políticas DIY. ShareAI evita lógica personalizada para seleção de provedor and failover.
Orq AI Proxy vs Apache APISIX — ecossistema de plugins ou transparência de marketplace?
APISIX traz um gateway rico em plugins. ShareAI traz visibilidade de fornecedor/modelo pré-rota and roteamento resiliente. Use ambos se você quiser política na borda and acesso transparente multi-fornecedor.
Se você está avaliando Alternativas ao Arch Gateway, este guia mapeia o cenário como um construtor faria. Primeiro, esclarecemos o que é o Arch Gateway—um gateway consciente de prompts para tráfego de LLM e aplicativos agentivos—e depois comparamos o 10 melhores alternativas. Colocamos ShareAI primeiro para equipes que desejam uma API única entre muitos provedores, transparência pré-rota (preço, latência, tempo de atividade, disponibilidade) antes de rotear, failover instantâneo, e economia impulsionada por pessoas (70% dos gastos vai para os provedores).
O que é. Arch Gateway (frequentemente abreviado para “Arch” / archgw) é um gateway consciente de IA para aplicativos agentivos. Ele fica na borda da sua pilha para aplicar limites, normalizar/esclarecer entradas, direcionar prompts para a ferramenta ou modelo certo e unificar o acesso aos LLMs—para que seu aplicativo possa focar na lógica de negócios em vez de na infraestrutura.
O que não é. Arch é uma camada de governança e roteamento para prompts e agentes; é não um transparente marketplace de modelo transparente que mostra o provedor preço, latência, tempo de atividade, disponibilidade antes de você rotear. É aí que o ShareAI se destaca.
Agregadores vs Gateways vs Plataformas de Agentes
Agregadores de LLM — Uma API entre muitos modelos/provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover. Exemplo: ShareAI.
Gateways de IA — Governança de borda para tráfego de LLM (chaves, políticas, limites de taxa, limites) além de observabilidade. Você traz seus provedores. Exemplos: Arch Gateway, Kong AI Gateway, Portkey.
Plataformas de agente/chatbot — UX empacotado (memória/ferramentas/canais) para assistentes; mais próximo do produto do que da infraestrutura. Exemplo: Orq.
Como avaliamos as melhores alternativas ao Arch Gateway
Amplitude e neutralidade do modelo — proprietário + aberto; troca fácil; sem reescritas.
Latência e resiliência — políticas de roteamento, tempos limite/retries, failover instantâneo.
2. Governança e segurança 3. — manipulação de chaves, escopos, roteamento regional, trilhos de proteção.
Observabilidade 4. — logs/rastros e painéis de custo/latência.
5. Transparência de preços e TCO — comparar real custos antes de rotear.
Experiência do desenvolvedor — documentação, SDKs, inícios rápidos; tempo até o primeiro token.
11. — se seus gastos — se seus gastos aumentam a oferta (incentivos para proprietários de GPU).
Top 10 alternativas ao Arch Gateway
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo.
Por que é #1 aqui. Se você deseja agregação independente de provedores com transparência pré-roteamento e resiliência, ShareAI é a opção mais direta. Mantenha um gateway se precisar de políticas organizacionais; adicione ShareAI para roteamento guiado por marketplace.
Uma API → 150+ modelos entre muitos provedores; sem reescritas, sem dependência.
Marketplace transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa:70% do gasto vai para provedores (comunidade ou empresa).
O que é. Gateway empresarial de IA/LLM—governança, políticas/plugins, análises e observabilidade para tráfego de IA na borda. É um plano de controle em vez de um marketplace.
#3 — Portkey
O que é. Gateway de IA enfatizando limites e observabilidade—popular em ambientes regulados.
#4 — OpenRouter
O que é. API unificada sobre muitos modelos; ótimo para experimentação rápida em um amplo catálogo.
#5 — Eden AI
O que é. Agrega LLMs além de capacidades mais amplas de IA (visão, tradução, TTS), com fallback/cache e agrupamento.
#6 — LiteLLM
O que é. Um SDK Python leve + proxy auto-hospedável que utiliza uma interface compatível com OpenAI para muitos provedores.
#7 — Unify
O que é. Roteamento e avaliação orientados à qualidade para escolher melhores modelos por prompt.
#8 — Orq AI
O que é. Plataforma de orquestração/colaboração que ajuda equipes a passar de experimentos para produção com fluxos de baixo código.
#9 — Apigee (com LLMs por trás)
O que é. Um gateway/gerenciamento de API maduro que você pode colocar na frente de provedores de LLM para aplicar políticas, chaves e cotas.
#10 — NGINX
O que é. Use o NGINX para construir roteamento personalizado, aplicação de tokens e caching para backends de LLM se preferir controle DIY.
Arch Gateway vs ShareAI
Se você precisar uma API sobre muitos provedores com transparente preços/latência/disponibilidade/tempo de atividade and failover instantâneo, escolha ShareAI. Se o seu principal requisito for governança de saída— credenciais centralizadas, aplicação de políticas e roteamento consciente de prompts—Arch Gateway se encaixa nesse perfil. Muitas equipes os combinam: gateway para política organizacional + ShareAI para roteamento de marketplace.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto/plataforma que precisam de uma API + economia justa
mais de 150 modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Portal Arch
Equipes construindo aplicativos agentes que precisam de borda consciente de prompts
Provedores próprios
Trilhos de proteção, chaves, políticas
Rastreamento/observabilidade para prompts
Roteamento condicional para agentes/ferramentas
Não (ferramenta de infraestrutura, não um marketplace)
n/d
Kong IA Gateway
Empresas que precisam de políticas em nível de gateway
BYO
Políticas/plugins fortes na borda
Análises
Repetições via plugins
Não
n/d
Portkey
Equipes regulamentadas/empresariais
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Roteamento condicional
Parcial
n/d
OpenRouter
Desenvolvedores que desejam uma única chave
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
Equipes que precisam de LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão de API
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Equipes com foco em orquestração
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Apigee / NGINX
Empresas / DIY
BYO
Políticas
Complementos / personalizados
Personalizado
n/d
n/d
Preços e TCO: compare custos reais (não apenas preços unitários)
Tokens brutos $/1K escondem a verdadeira imagem. TCO mudanças com repetições/fallbacks, latência (afeta o uso), variação do provedor, armazenamento de observabilidade e execuções de avaliação. mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimize para o tempo até o primeiro token (Playground, inícios rápidos).
Escala média (~2M tokens/dia): O roteamento/failover guiado pelo Marketplace pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Espere custos efetivos mais altos de tokens devido a tentativas durante o failover; planeje o orçamento para isso.
Guia de migração: movendo para ShareAI
Do Portal Arch
Mantenha políticas no nível do gateway onde elas brilham, adicione ShareAI 3. para roteamento de marketplace + failover instantâneo. Padrão: autenticação/política do gateway → rota ShareAI por modelo → medir estatísticas do marketplace → ajustar políticas.
Do OpenRouter
Mapear nomes de modelos, verificar paridade de prompts, então sombrear 10% o tráfego e aumentar gradualmente 25% → 50% → 100% conforme os orçamentos de latência/erro forem mantidos. Os dados do marketplace tornam as trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado em rotas de produção que você não deseja operar; mantenha o LiteLLM para desenvolvimento, se desejado. Compare a sobrecarga operacional com os benefícios do roteamento gerenciado.
De Unify / Portkey / Orq / Kong
Definir expectativas de paridade de recursos (análises, guardrails, orquestração, plugins). Muitas equipes operam de forma híbrida: mantenha recursos especializados onde são mais fortes; use ShareAI para escolha transparente de provedores and failover.
Início rápido para desenvolvedores (copiar-colar)
Os seguintes utilizam uma superfície compatível com OpenAI. Substitua YOUR_KEY com sua chave ShareAI — obtenha uma em Criar Chave de API. Veja o Referência da API para detalhes.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
// process.env.SHAREAI_API_KEY = "YOUR_KEY"
async function main() {
const res = await fetch("https://api.shareai.now/v1/chat/completions", {
method: "POST",
headers: {
"Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
"Content-Type": "application/json"
},
body: JSON.stringify({
model: "llama-3.1-70b",
messages: [
{ role: "user", content: "Give me a short haiku about reliable routing." }
],
temperature: 0.4,
max_tokens: 128
})
});
if (!res.ok) {
console.error("Request failed:", res.status, await res.text());
return;
}
const data = await res.json();
console.log(JSON.stringify(data, null, 2));
}
main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde os prompts/respostas são armazenados, por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompts/respostas; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento de forma consistente.
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — Portal Arch vs outros concorrentes
Portal Arch vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. Portal Arch é uma camada de governança/roteamento consciente de prompts (trilhos de proteção, roteamento de agentes, acesso unificado a LLM). Muitas equipes usam ambos.
Portal Arch vs OpenRouter — acesso rápido a múltiplos modelos ou controles de portal?
OpenRouter oferece acesso rápido a múltiplos modelos; Arco centraliza políticas/limites e roteamento de agentes. Se você também quiser transparência pré-rota and failover instantâneo, ShareAI combina acesso multi-provedor com uma visão de marketplace e roteamento resiliente.
Arch Gateway vs Traefik AI Gateway — camada fina de IA ou roteamento de marketplace?
Ambos são gateways (credenciais/políticas; observabilidade). Se o objetivo for acesso agnóstico ao provedor com transparência and failover, adicione ShareAI.
Arch Gateway vs Kong AI Gateway — dois gateways
Ambos são gateways (políticas/plugins/analítica), não marketplaces. Muitas equipes combinam um gateway com ShareAI 3. para roteamento transparente multi-provedor and failover.
Arch Gateway vs Portkey — quem é mais forte em limites?
Ambos enfatizam governança e observabilidade; profundidade e ergonomia diferem. Se sua principal necessidade for escolha transparente de provedores and failover, adicione ShareAI.
Arch Gateway vs Unify — melhor seleção de modelo vs aplicação de políticas?
Unificar foca na seleção de modelo baseada em avaliação; Arco em limites + roteamento de agentes. Para uma API entre muitos provedores com estatísticas de marketplace ao vivo, use ShareAI.
Arch Gateway vs Eden AI — muitos serviços de IA ou controle de saída?
Eden IA agrega vários serviços de IA (LLM, imagem, TTS). Arco centraliza políticas/credenciais e roteamento de agentes. Para preços/latência transparentes entre muitos provedores and failover instantâneo, escolha ShareAI.
Arch Gateway vs LiteLLM — proxy auto-hospedado ou gateway gerenciado?
LiteLLM é um proxy DIY que você opera; Arco é um gateway gerenciado, ciente de prompts. Se você preferir não executar um proxy e quiser roteamento orientado por marketplace, escolha ShareAI.
Arch Gateway vs Orq — orquestração vs saída?
Orq orquestra fluxos de trabalho; Arco governa o tráfego de prompts e o roteamento de agentes. ShareAI complementa qualquer um com seleção de provedor transparente.
Arch Gateway vs Apigee — gerenciamento de API vs saída específica de IA
Apigee é gerenciamento amplo de API; Arco é governança de saída focada em LLM/agente. Necessita acesso agnóstico ao provedor com transparência de mercado? Uso ShareAI.
Arch Gateway vs NGINX — DIY vs turnkey
NGINX oferece filtros/políticas DIY; Arco oferece recursos de gateway empacotados e conscientes de prompts. Para evitar scripts personalizados e ainda obter seleção de provedor transparente, camada em ShareAI.
Para provedores: ganhe mantendo modelos online
Qualquer pessoa pode se tornar um provedor ShareAI — Comunidade ou Empresa. Embarque via Windows, Ubuntu, macOS ou Docker. Contribuir explosões de tempo ocioso ou executar sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Trocar (tokens/AI Prosumer), ou Missão (doar % para ONGs). À medida que você escala, você pode definir seus próprios preços de inferência e ganhar exposição preferencial.
Se você está pesquisando Alternativas ao Helicone, este guia apresenta o panorama como um construtor faria. Primeiro, esclarecemos o que é (e o que não é) o Helicone, depois comparamos o 10 melhores alternativas—colocando ShareAI primeiro para equipes que desejam uma API única para vários provedores, transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor), failover instantâneo, e economia impulsionada por pessoas (70% dos gastos vão para provedores que mantêm os modelos online).
O que é (e o que não é) o Helicone
Helicone começou como uma plataforma de observabilidade LLM de código aberto—um proxy que registra e analisa o tráfego do seu LLM (latência, custo, uso) para ajudá-lo a depurar e otimizar. Com o tempo, o produto adicionou uma Gateway de IA com uma API para mais de 100 modelos, enquanto continua a enfatizar roteamento, depuração e análises.
Do site oficial e documentos:
Observabilidade LLM de código aberto com configuração de uma linha; logs/métricas para solicitações.
Gateway de IA com uma interface unificada para acessar mais de 100 modelos e registrar solicitações automaticamente.
Posicionamento: roteie, depure e analise seus aplicativos de IA.
Interpretação: Helicone combina observabilidade (logs/métricas) com um gateway. Ele oferece alguma agregação, mas seu centro de gravidade ainda é telemetria-primeiro (investigar, monitorar, analisar). Isso é diferente de um mercado transparente de múltiplos provedores onde você decide rotas com base em pré-rota preço do modelo/provedor, latência, tempo de atividade e disponibilidade — e troca rapidamente quando as condições mudam. (É aí que o ShareAI se destaca.)
Agregadores vs Gateways vs Plataformas de Observabilidade
Agregadores/mercados de LLM: uma API em vários provedores com transparência pré-rota (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover.
Gateways de IA: governança e política na borda (chaves centralizadas, limites de taxa, trilhos de proteção), observabilidade, algum roteamento; você traz os provedores.
Plataformas de Observabilidade: capturar solicitações/respostas, latência, custos; solução de problemas no estilo APM.
Híbridos (como Helicone): núcleo de observabilidade + recursos de gateway, cada vez mais borrando as linhas.
Como avaliamos as melhores alternativas ao Helicone
Amplitude e neutralidade do modelo: proprietário + aberto; troca fácil; reescritas mínimas.
Latência e resiliência: políticas de roteamento, timeouts, tentativas, failover instantâneo.
2. Governança e segurança: manipulação de chaves, escopos; roteamento regional/localidade de dados.
Observabilidade: logs/rastreios e dashboards de custo/latência.
5. Transparência de preços e TCO: compare custos reais antes roteamento.
Experiência do desenvolvedor: docs, SDKs, quickstarts; tempo-para-primeiro-token.
11. — se seus gastos: se seu gasto aumenta a oferta (incentivos para proprietários de GPU).
As 10 principais alternativas ao Helicone
#1 — ShareAI (API de IA impulsionada por pessoas)
O que é. A API multi-fornecedor com um mercado transparente and roteamento inteligente. Com uma integração, navegue por um grande catálogo de modelos e provedores, compare preço, latência, tempo de atividade, disponibilidade, tipo de fornecedor, e roteie com failover instantâneo. A economia é impulsionada por pessoas: 70% de cada dólar flui para provedores (comunidade ou empresa) que mantêm os modelos online.
Por que é #1 aqui. Se você quiser agregação independente de fornecedor com transparência pré-rota and resiliência, o ShareAI é o ajuste mais direto. Mantenha um gateway se precisar de políticas para toda a organização; adicione o ShareAI para roteamento guiado por marketplace.
Uma API → mais de 150 modelos entre muitos provedores; sem reescritas, sem dependência.
Mercado transparente: escolha por preço, latência, tempo de atividade, disponibilidade, tipo de provedor.
Resiliência por padrão: políticas de roteamento + failover instantâneo.
Economia justa: 70% dos gastos vão para provedores (comunidade ou empresa).
Para provedores: ganhe mantendo modelos online Qualquer pessoa pode se tornar um provedor ShareAI—Comunidade ou Empresa. Integre via Windows, Ubuntu, macOS ou Docker. Contribua com rajadas de tempo ocioso ou opere sempre ativo. Escolha seu incentivo: Recompensas (dinheiro), Troca (tokens/AI Prosumer) ou Missão (doe % para ONGs). Conforme você escala, pode definir seus próprios preços de inferência e ganhar exposição preferencial. Links do provedor — Guia do Provedor · Painel do Provedor
#2 — OpenRouter
API unificada em um amplo catálogo—ótimo para experimentação rápida e cobertura. É forte em amplitude e testes rápidos; combine com um marketplace para transparência pré-rota e failover.
#3 — Eden AI
Agrega LLMs além de IA mais ampla (visão, tradução, fala). Útil para equipes que precisam de multimodalidade além de texto; adicione roteamento guiado por marketplace para equilibrar custo e latência.
#4 — Portkey
Gateway de IA enfatizando observabilidade, guardrails e governança—popular em ambientes regulados. Mantenha para profundidade de políticas; adicione ShareAI para escolha de provedores e failover.
#5 — LiteLLM
SDK Python leve e proxy auto-hospedado que utiliza uma interface compatível com OpenAI para muitos provedores. Ótimo para DIY; troque para ShareAI quando não quiser operar um proxy em produção.
#6 — Unify
Roteamento e avaliação orientados à qualidade para escolher melhores modelos por prompt. Complemente com ShareAI quando também precisar de estatísticas de marketplace ao vivo e failover instantâneo.
#7 — Orq AI
Orquestração e colaboração para passar de experimento à produção com fluxos de baixo código. Execute lado a lado com a camada de roteamento e marketplace do ShareAI.
#8 — Kong AI Gateway
Gateway empresarial: políticas, plugins, análises e observabilidade para tráfego de IA na borda. É um plano de controle em vez de um marketplace.
#9 — Traefik AI Gateway
Camada fina de IA sobre o gateway de API do Traefik — middlewares especializados, credenciais centralizadas e observabilidade compatível com OpenTelemetry. Combine com ShareAI para roteamento transparente de múltiplos provedores.
#10 — Apigee / NGINX (DIY)
Gerenciamento geral de API (Apigee) e proxy programável (NGINX). Você pode criar seus próprios controles de gateway de IA; adicione ShareAI para transparência de marketplace e failover sem encanamento personalizado.
Helicone vs ShareAI (em resumo)
Se você precisar uma API sobre muitos provedores com preços/latência/tempo de atividade transparentes and failover instantâneo, escolha ShareAI.
Se sua principal exigência for telemetria e depuração, a abordagem focada em observabilidade do Helicone é valiosa; com o novo AI Gateway, oferece acesso unificado, mas não um marketplace de provedores com pré-rota transparência.
Comparação rápida
Plataforma
Quem atende
Amplitude do modelo
2. Governança e segurança
Observabilidade
Roteamento / failover
Transparência do marketplace
Programa de provedores
ShareAI
Equipes de produto e plataforma que precisam de uma API + economia justa
150+ modelos, muitos provedores
Chaves de API e controles por rota
Uso do console + estatísticas do marketplace
Roteamento inteligente + failover instantâneo
Sim (preço, latência, tempo de atividade, disponibilidade, tipo de provedor)
Sim — fornecimento aberto; 70% para provedores
Helicone
Equipes que desejam telemetria + acesso ao AI Gateway
100+ modelos via Gateway
Chaves centralizadas via gateway
Sim — logs/métricas
Roteamento condicional
Parcial (visão do gateway; não um marketplace de preços)
n/d
OpenRouter
Desenvolvedores que precisam de acesso rápido a múltiplos modelos
Catálogo amplo
Controles básicos de API
Lado do aplicativo
Alternativas
Parcial
n/d
Eden IA
LLM + outros serviços de IA
Amplo
Controles padrão
Varia
Alternativas/cache
Parcial
n/d
Portkey
Regulamentado/empresarial
Amplo
Trilhos de proteção e governança
Rastreamentos profundos
Condicional
Parcial
n/d
LiteLLM
Proxy DIY/autohospedado
Muitos provedores
Limites de configuração/chave
Sua infraestrutura
Repetições/alternativas
n/d
n/d
Unificar
Equipes orientadas pela qualidade
Multi-modelo
Segurança padrão
Análises da plataforma
Seleção do melhor modelo
n/d
n/d
Orq
Orquestração em primeiro lugar
Suporte amplo
Controles da plataforma
Análises da plataforma
Fluxos de orquestração
n/d
n/d
Kong IA Gateway
Empresas/gateway
Provedores próprios
Políticas fortes de borda
Análises
Proxy/plugins, tentativas
Não (infra)
n/d
Traefik AI Gateway
Governança de saída
Provedores próprios
Políticas centralizadas
OpenTelemetry
Middlewares
Não (infra)
n/d
Preços e TCO: comparar real custos (não apenas preços unitários)
Tokens brutos $/1K escondem o quadro real. O TCO muda com tentativas/recuos, latência (que afeta o comportamento do usuário), variação do provedor, armazenamento de observabilidade e execuções de avaliação. Um mercado transparente ajuda você a escolher rotas que equilibram custo e UX.
Protótipo (~10k tokens/dia): Otimize para o tempo até o primeiro token (Playground, inícios rápidos).
Escala média (~2M tokens/dia): O roteamento/failover guiado pelo marketplace pode reduzir 10–20% enquanto melhora o UX.
Cargas de trabalho irregulares: Orçamento para custos efetivos mais altos de tokens devido a tentativas durante o failover.
Guia de migração: mudando para ShareAI (de Helicone ou outros)
De Helicone
Use o Helicone onde ele brilha—telemetria—e adicione o ShareAI para roteamento de marketplace e failover instantâneo. Padrão comum: App → (política de gateway opcional) → rota ShareAI por modelo → medir estatísticas do marketplace → ajustar políticas ao longo do tempo. Quando você trocar rotas, verifique a paridade do prompt e a latência/custo esperado no Playground antes do lançamento completo.
Do OpenRouter
Mapeie os nomes dos modelos, confirme a compatibilidade do prompt, então faça shadow de 10% do tráfego e aumente 25% → 50% → 100% se os orçamentos de latência/erro forem mantidos. Os dados do marketplace tornam as trocas de provedores diretas.
Do LiteLLM
Substitua o proxy auto-hospedado nas rotas de produção que você não deseja operar; mantenha o LiteLLM para desenvolvimento, se preferir. Compare a sobrecarga operacional versus os benefícios do roteamento gerenciado.
De Unify / Portkey / Orq / Kong / Traefik
Definir expectativas de paridade de recursos (análises, limites, orquestração, plugins). Muitas equipes operam de forma híbrida: mantenha recursos especializados onde são mais fortes; use ShareAI para escolha transparente de provedores e failover.
Início rápido para desenvolvedores (copiar-colar)
Os seguintes usam uma superfície compatível com OpenAI. Substitua YOUR_KEY pela sua chave ShareAI — crie uma em Criar Chave de API. Veja o Referência da API para detalhes.
// JavaScript (fetch) — Node 18+/Edge
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificação de segurança, privacidade e conformidade (agnóstica ao fornecedor)
Manipulação de chaves: cadência de rotação; escopos mínimos; separação de ambientes.
Retenção de dados: onde prompts/respostas são armazenados, por quanto tempo; padrões de redação.
PII & conteúdo sensível: mascaramento; controles de acesso; roteamento regional para localidade de dados.
Observabilidade: registro de prompt/resposta; capacidade de filtrar ou pseudonimizar; propagar IDs de rastreamento consistentemente (OTel).
Resposta a incidentes: caminhos de escalonamento e SLAs do provedor.
FAQ — Helicone vs outros concorrentes (e onde o ShareAI se encaixa)
Helicone vs ShareAI — qual para roteamento multi-provedor?
CompartilharAI. Foi construído para transparência de marketplace (preço, latência, tempo de atividade, disponibilidade, tipo de provedor) e roteamento inteligente/failover entre muitos provedores. Helicone se concentra em observabilidade e agora adiciona um AI Gateway; é uma telemetria útil, mas não um marketplace com transparência pré-rota. Muitas equipes usam ambos: Helicone para logs; ShareAI para escolha de roteamento.
Helicone vs OpenRouter — acesso rápido multi-modelo ou transparência de marketplace?
OpenRouter torna o acesso multi-modelo rápido; Helicone adiciona análise/logs profundos. Se você também quiser transparência pré-rota and failover instantâneo, ShareAI combina acesso multi-provedor com uma visão de marketplace e roteamento resiliente.
Helicone vs Portkey — quem é mais forte em guardrails?
Portkey foca em governança/guardrails; Helicone em telemetria + gateway. Se sua principal necessidade for escolha transparente de provedores and failover, adicione ShareAI.
Helicone vs LiteLLM — proxy auto-hospedado ou camadas gerenciadas?
LiteLLM é um proxy/SDK DIY; Helicone é observabilidade + gateway. Se você prefere não executar um proxy e quer roteamento orientado por marketplace, escolha ShareAI.
Helicone vs Unify — melhor seleção de modelo vs registro?
Unify enfatiza a seleção de modelo baseada em avaliação; Helicone enfatiza o registro. ShareAI adiciona estatísticas de marketplace ao vivo e roteamento quando você quer custo/latência controle antes de enviar o tráfego.
Helicone vs Eden AI — muitos serviços de IA ou observabilidade + gateway?
Eden AI agrega muitas modalidades; Helicone combina observabilidade + acesso ao modelo. Para preços/latência transparentes entre provedores e failover instantâneo, use ShareAI.
Helicone vs Orq — orquestração vs telemetria?
Orq ajuda a orquestrar fluxos de trabalho; Helicone ajuda a registrá-los e analisá-los. Camada ShareAI 3. para roteamento agnóstico de provedores vinculada às estatísticas do marketplace.
Helicone vs Kong AI Gateway — profundidade do gateway vs telemetria?
Kong é um gateway robusto (políticas/plugins/analytics); Helicone é observabilidade + gateway. Muitas equipes combinam um gateway com ShareAI 3. para roteamento transparente.
Helicone vs Traefik AI Gateway — Governança OTel ou roteamento de marketplace?
Traefik AI Gateway centraliza políticas de saída com observabilidade compatível com OTel; Helicone oferece telemetria mais uma superfície de gateway. Para uma API sobre muitos provedores com transparência pré-rota, use ShareAI.
Helicone vs Apigee / NGINX — solução pronta ou faça você mesmo?
Apigee/NGINX oferecem controles gerais de API; Helicone é telemetria específica para IA + gateway. Se você quiser seleção de provedor transparente and failover sem faça você mesmo, ShareAI é projetado para isso.
Fontes e leituras adicionais (Helicone)
Página inicial do Helicone — Gateway de IA e Observabilidade LLM; “rotear, depurar, analisar;” uma API para 100+ modelos.
Tema de cores: {theme}ClaroEscuroSistemaArtigos correspondentes: {count}Copiado {identifier}Remover filtro {label}Sem servidorAcederFornecedoresCriadoresTreinoRetençãoSedeCluster de GPUs / DatacenterPolíticasAcesso · RecomendadoCréditosUse créditos ShareAI para apoiar proprietários de GPUs em troca da capacidade de computação que não estão a utilizar.Os seus créditos recompensam as pessoas e empresas que partilham capacidade de computação ociosa. Recomendamos esta opção para apoiar um uso mais sustentável do hardware existente.A ShareAI combina salvaguardas técnicas com acordos de fornecedores para ajudar a proteger os seus dados.Troca de tokensOs fornecedores da ShareAI podem realizar inferências para outros e ganhar tokens de entrada e saída pelo trabalho que contribuem. Depois, podem usar esses tokens para as suas próprias inferências quando precisarem.Tal como os prosumers de energia que produzem e consomem eletricidade, pode tornar-se um AI Prosumer: contribua com capacidade de computação quando estiver ociosa e use a rede quando precisar.CuriosidadeEm março de 2025, a ShareAI tornou-se a primeira plataforma do mundo para AI prosumers. Compense o seu próprio uso de IA através da troca de tokens ou ganhe pagamentos no final do mês com contribuições remuneradas.ComunidadeOs fornecedores comunitários são indivíduos que partilham a sua capacidade de computação em troca de créditos ou tokens através da troca de tokens.Eles colocam a capacidade de computação que, de outra forma, estaria ociosa a trabalhar para outros na rede ShareAI.A ShareAI toma medidas para proteger os seus dados, e todos os fornecedores, Comunitários ou Empresariais, assinam um acordo. Para cargas de trabalho sensíveis, recomendamos fornecedores Empresariais.EmpresaCada fornecedor Empresarial assina um acordo rigoroso. As salvaguardas da ShareAI vão além do código, abrangendo a responsabilidade e a reputação da empresa.Analisamos onde a empresa está sediada, quem a formou e sua estrutura de propriedade para compreender os beneficiários finais por trás dela.Região e os seus dados pessoaisAs regras sobre dados pessoais diferem entre países e regiões. Um fornecedor pode continuar sujeito às leis do país onde está estabelecido, mesmo que os seus datacenters estejam em outro local.Hospedar dados em outra região não remove automaticamente essas obrigações. As regras do local onde os dados são processados e as proteções que se aplicam a si também podem ser relevantes.Verifique a entidade legal do fornecedor, os locais de processamento e a política de privacidade antes de partilhar dados pessoais.Fechar informações da regiãoFechar explicaçãoA pesquisar…Explorar documentaçãoNenhum artigo encontrado. Tente outra pesquisa ou base de conhecimento.A pesquisa está indisponível. Por favor, tente novamente.Copiado!Página copiada.Falha ao copiarFalha ao copiar. Selecione o texto da página para copiá-lo manualmente.Copiar páginaLink da página copiado.Não foi possível copiar o link. Copie-o a partir da barra de endereços.A preparar Markdown…Não foi possível copiar. Tente novamente ou abra Ver como Markdown.Copiar identificadorCopiadoCopiar identificador do modeloCopiar do providerCopiar prefixoFalha ao copiar. Selecione o prefixo para copiá-lo manualmente.Identificador do modelo copiadoCopiado {prefix}. Adicione o identificador do modelo após a barra.Não foi possível copiar. Selecione este identificador: {identifier}A verificação não pôde ser carregada. Por favor, tente novamente ou abra um ticket a partir da sua conta ShareAI.A verificação não pôde ser carregada. Por favor, tente novamente.Por favor, complete a verificação antes de enviar a sua mensagem.A sua mensagem foi enviada. Obrigado — a equipa ShareAI responderá por email.Não conseguimos confirmar a entrega. Por favor, verifique a sua conexão antes de tentar novamente.A enviar…Não conseguimos enviar a sua mensagem. Por favor, tente novamente.Por favor, envie este formulário a partir do ShareAI.A sua mensagem é demasiado longa. Por favor, mantenha-a abaixo de 10.000 caracteres.Por favor, insira um endereço de email válido.Insira um endereço de email válido.Por favor, insira uma mensagem com até 10.000 caracteres.Por favor, reduza o seu nome ou assunto.Por favor, complete a verificação.Complete a verificação.Por favor, verifique este campo.A verificação falhou. Por favor, tente novamente.Por favor, verifique os seus dados e tente novamente.Não conseguimos confirmar a entrega. Por favor, tente novamente mais tarde ou abra um ticket de suporte.{date}: {uptime}. Online {online}, offline {offline}, não observado {unknown}.Sem observaçõesTempo de atividade observado {percent}Tempo de atividade {percent}Tempo de atividade diário observado e cobertura de gravação durante {days} dias. Observações em falta são lacunas, não tempo de atividade zero. Use as teclas de seta ou os controlos de detalhes diários para explorar.Cobertura de gravaçãoOnlineOfflineNão observadoTempo de atividade observado{percent} deste período cobertoDo tempo gravadoA aguardar observaçõesDesconectado durante as verificaçõesAinda não há histórico disponívelÚltimos {days} diasO histórico está a ser construídoSem observações neste período{date} é o primeiro dia registado nesta visualização.As verificações registadas aparecerão aqui à medida que forem chegando.A mostrar os últimos {days} dias. {details}Online observadoOffline observadoFechar navegaçãoAbrir navegaçãoUtilize o formulário para enviar a sua mensagem.Formulário não encontrado.Dados do formulário não suportados.Dados do formulário inválidos.Não conseguimos enviar a sua candidatura. As suas respostas ainda estão aqui—por favor, tente novamente.A enviar a sua candidatura…Candidatura recebida.Obrigado por partilhar o seu projeto. Vamos analisá-lo e entrar em contacto consigo sobre a adequação e os próximos passos.Candidate-se ao piloto de €250Piloto Open Source · €250 em créditosCopiar JSON de encaminhamentoJSON de encaminhamento copiadoNão foi possível copiar. Selecione o JSON de encaminhamento para copiá-lo manualmente.Pedido cURL copiadoCorpo do pedido copiadoNão foi possível copiar. Seleciona o endpoint, os cabeçalhos e o corpo para os copiar manualmente.Não foi possível copiar. Seleciona o corpo do pedido para o copiar manualmente.