2. Si estás evaluando Alternativas a BytePlus API Gateway, esta guía compara el espacio de la manera en que lo hacen los constructores: por gobernanza, enrutamiento y resiliencia, observabilidad, transparencia de precios, y experiencia del desarrollador. Primero situamos BytePlus en la pila, luego clasificamos las 10 principales alternativas—con ShareAI primero para equipos que desean una API en muchos proveedores, un mercado transparente (precio/latencia/tiempo de actividad/disponibilidad antes del enrutamiento), conmutación por error instantánea y economía impulsada por personas (70% del gasto va a proveedores que mantienen los modelos en línea).
Qué es (y qué no es) BytePlus API Gateway
Puerta de enlace de API de BytePlus es una capa de gestión/control de API. Usted trae sus servicios y políticas; proporciona características de gateway como credenciales centralizadas, limitación de velocidad, autenticación, enrutamiento y controles del ciclo de vida de la API. Eso es infraestructura centrada en la gobernanza—útil cuando necesita políticas de perímetro y control a nivel organizacional.
Es no transparente mercado de modelos. No se centra en enrutamiento de IA multi-proveedor con visibilidad previa a la ruta en precio, latencia, tiempo de actividad, disponibilidad y tipo de proveedor, y no existe para aumentar el suministro comunitario. Si su requisito principal es transparencia previa a la ruta and conmutación por error instantánea entre muchos proveedores de IA, a menudo combinará un gateway con un agregador como ShareAI.
Agregadores vs Gateways vs Plataformas de Agentes/Orquestación
Agregadores LLM (por ejemplo, ShareAI, OpenRouter, Eden AI): Una API para muchos modelos/proveedores con transparencia previa a la ruta (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover.
Gateways de IA/API (por ejemplo, BytePlus API Gateway, Kong, Portkey, Apache APISIX): Políticas/gobernanza en el borde (credenciales, cuotas, límites) más observabilidad. Traes a los proveedores detrás de ellos.
Plataformas de Agente/Orquestación (por ejemplo, Orq, Unify): UX empaquetado, herramientas, memoria, flujos y evaluaciones. Ideal para asistentes o selección del mejor modelo; no son mercados.
Cómo evaluamos las mejores alternativas a BytePlus API Gateway
Amplitud y neutralidad del modelo: propietario + abierto; cambio fácil; reescrituras mínimas
Latencia y resiliencia: políticas de enrutamiento, tiempos de espera/reintentos, conmutación por error instantánea
Gobernanza y seguridad: manejo de claves, alcances, enrutamiento regional, barandillas
Observabilidad: registros/rastros más vistas de costos/latencia
Transparencia de precios y TCO: comparar real costos antes de enrutar, no solo el precio unitario
Experiencia del desarrollador: documentación, SDKs, inicios rápidos; tiempo hasta el primer token
Comunidad y economía: si tu gasto aumenta la oferta (incentivos para propietarios/proveedores de GPU)
Las 10 mejores alternativas a BytePlus API Gateway
#1 — ShareAI (API de IA impulsada por personas)
Qué es. A API de múltiples proveedores con un mercado transparente and enrutamiento inteligente. Con una integración, explora un amplio catálogo de modelos y proveedores, compara precio, latencia, tiempo de actividad, disponibilidad, y tipo de proveedor, luego enrutar con conmutación por error instantánea. La economía está impulsada por personas: 70% de cada dólar fluye hacia los proveedores (comunidad o empresa) que mantienen los modelos en línea.
Por qué es #1. Si deseas una agregación independiente del proveedor con transparencia previa a la ruta and resiliencia, ShareAI es el ajuste más directo. Mantén una puerta de enlace si necesitas políticas a nivel de organización; agrega ShareAI para enrutamiento guiado por el mercado.
Una API → 150+ modelos a través de muchos proveedores; sin reescrituras, sin dependencia
Mercado transparente: elige por precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor
Resiliencia por defecto: políticas de enrutamiento + conmutación por error instantánea
Economía justa: 70% del gasto va a los proveedores (comunidad o empresa)
Para proveedores: gana manteniendo modelos en línea. Cualquiera puede convertirse en un proveedor de ShareAI—Comunidad or Empresa. Incorporarse a través de Windows, Ubuntu, macOS, o Docker. Contribuye con ráfagas de tiempo inactivo o ejecuta siempre activo. Elige tu incentivo: Recompensas (dinero), Intercambio (tokens/AI Prosumer), o Misión (dona un % a ONGs). A medida que escalas, establece tu propia precios de inferencia y ganar exposición preferencial.
Qué es. Puerta de enlace empresarial: gobernanza/políticas/plugins, analíticas y observabilidad para el tráfico de IA/API. Un controlador en lugar de un mercado.
Cuándo recogerlo. Si necesitas políticas de borde a través de muchos servicios y ya estandarizado en Kong, entonces emparejar con ShareAI para obtener elección de proveedor impulsada por el mercado y conmutación por error.
#3 — Portkey
Qué es. puerta de enlace de IA que enfatiza observabilidad, límites de seguridad, y gobernanza—popular en cargas de trabajo reguladas.
Cuándo recogerlo. Fuerte si tu prioridad es aplicación de políticas + rastreos profundos; agrega ShareAI para transparencia previa a la ruta y resiliencia multi-proveedor.
#4 — OpenRouter
Qué es. API unificada para muchos modelos; ideal para experimentación rápida a través de un amplio catálogo.
Cuándo recogerlo. Para acceso rápido a múltiples modelos; si también quieres conmutación por error instantánea y estadísticas del mercado (precio/latencia/tiempo de actividad/disponibilidad/tipo de proveedor), capa ShareAI.
#5 — Eden AI
Qué es. Agrega LLMs and IA más amplia (visión, traducción, TTS), con alternativas y almacenamiento en caché.
Cuándo recogerlo. Si necesitas muchas modalidades de IA a través de una sola API; combínalo con ShareAI para visibilidad en tiempo real del mercado y enrutamiento resiliente.
#6 — LiteLLM
Qué es. SDK ligero de Python + proxy auto-hospedable que habla interfaces compatibles con OpenAI para muchos proveedores.
Cuándo recogerlo. Si prefieres Hazlo tú mismo control con dependencias mínimas. Usa ShareAI para enrutamiento gestionado y para evitar operar el proxy en rutas de producción.
#7 — Unify
Qué es. Enrutamiento orientado a la calidad y selección de modelos basada en evaluación por solicitud.
Cuándo recogerlo. Si “el mejor modelo por solicitud” es el objetivo; complétalo con ShareAI’s catálogo + conmutación por error instantánea.
#8 — Orq AI
Qué es.Orquestación/colaboración plataforma para ayudar a los equipos a pasar de experimentos a producción con flujos de bajo código.
Cuándo recogerlo. Si quieres flujos and orquestación de equipos; enruta las llamadas de modelo a través de ShareAI para la elección de proveedor y conmutación por error.
#9 — Apigee (con LLMs detrás)
Qué es. Maduro Gestión de API/pasarela que puedes colocar frente a los proveedores de LLM para políticas/claves/cupos.
Cuándo recogerlo. Si tu organización se estandariza en Apigee; añade ShareAI para enrutamiento multi-proveedor and transparencia en el mercado.
#10 — Apache APISIX
Qué es.Pasarela de API de código abierto con complementos, políticas de tráfico y extensibilidad.
Cuándo recogerlo. Si quieres OSS + DIY control de gateway; combinar con ShareAI para enrutamiento independiente del proveedor and conmutación por error instantánea sin construirlo todo tú mismo.
BytePlus API Gateway vs ShareAI
Si tu principal requisito es una API sobre muchos proveedores con precios/transparencia/latencia/tiempo de actividad/disponibilidad and conmutación por error instantánea, elegir ShareAI. 1. . Si su requisito principal es 2. gobernanza de salida—credenciales centralizadas, aplicación de políticas y observabilidad—BytePlus API Gateway encaja en ese ámbito. Muchos equipos los combinan: gateway para políticas de la organización + ShareAI para enrutamiento guiado por el mercado.
7. A quién sirve
Plataforma
8. Amplitud del modelo
9. Enrutamiento / conmutación por error
Gobernanza y seguridad
Observabilidad
10. Transparencia del mercado
11. Programa de proveedores
12. Equipos de producto/plataforma que necesitan una API + economía justa
ShareAI
13. , muchos proveedores
Más de 150 modelos, muchos proveedores
Claves API y controles por ruta
Uso de consola + estadísticas del mercado
Enrutamiento inteligente + conmutación por error instantánea
Sí (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor)
Sí — suministro abierto; 70% a proveedores
Puerta de enlace de API de BytePlus
Equipos que desean gobernanza de salida
Proveedores propios
Credenciales/políticas centralizadas
Analíticas de Gateway
Enrutamiento condicional mediante políticas
No (herramienta de infraestructura, no un mercado)
n/a
Kong IA Gateway
Empresas que necesitan políticas a nivel de puerta de enlace
Trae lo tuyo
Políticas/plugins de borde fuertes
Analíticas
Proxy/plugins, reintentos
No
n/a
Portkey
Equipos regulados/empresariales
Amplio
Límites y profundidad de gobernanza
Rastros profundos
Enrutamiento condicional
Parcial
n/a
OpenRouter
Desarrolladores que quieren una clave
Catálogo amplio
Controles básicos de API
Lado de la aplicación
Alternativas
Parcial
n/a
Eden IA
Equipos que necesitan LLM + otras IA
Amplio
Controles estándar
Varía
Alternativas/caché
Parcial
n/a
LiteLLM
Proxy DIY/autohospedado
Muchos
Límites de configuración/clave
Tu infraestructura
Reintentos/alternativas
n/a
n/a
Unificar
Equipos orientados a la calidad
Multi-modelo
Seguridad estándar de API
Analíticas de plataforma
Selección del mejor modelo
n/a
n/a
Orq
Equipos centrados en la orquestación
Amplio soporte
Controles de plataforma
Analíticas de plataforma
Flujos de orquestación
n/a
n/a
Apigee
Empresas/gestión de API
Trae lo tuyo
Políticas maduras
Complementos
Personalizado
n/a
n/a
Apache APISIX
Puerta de enlace DIY/OSS
Trae lo tuyo
Plugins/políticas
Herramientas de la comunidad
Personalizado
n/a
n/a
Precios y TCO: comparar costos reales (no solo precios unitarios)
Crudo $/1K tokens oculta la imagen real. El TCO cambia con reintentos/retrocesos, latencia (lo que afecta el comportamiento del usuario y los costos), variación del proveedor, almacenamiento de observabilidad, y ejecuciones de evaluación. Un mercado transparente te ayuda a elegir rutas que equilibran costo y UX.
Prototipo (~10k tokens/día): Optimizar para tiempo hasta el primer token (Playground, inicios rápidos).
Escala media (~2M tokens/día): Enrutamiento/failover guiado por el marketplace puede recortar 10–20% mientras mejora la UX.
Cargas de trabajo irregulares: Espere costos efectivos de tokens más altos por reintentos durante el failover; presupueste para ello.
Guía de migración: mudarse a ShareAI
Desde BytePlus API Gateway
Mantenga las políticas a nivel de gateway donde brillen; agregue ShareAI 3. para enrutamiento de mercado + conmutación por error instantánea. Patrón: autenticación/política del gateway → ShareAI ruta por modelo → medir estadísticas del marketplace → ajustar políticas.
Desde OpenRouter
Mapear nombres de modelos, verificar paridad de indicaciones, luego sombrear 10% del tráfico y aumentar gradualmente 25% → 50% → 100% mientras se mantengan los presupuestos de latencia/errores. Los datos del mercado hacen que los intercambios de proveedores sean sencillos.
Desde LiteLLM
Reemplace el proxy autohospedado en las rutas que no desee operar; mantenga LiteLLM para desarrollo si lo desea. Compare la sobrecarga de operaciones frente a los beneficios del enrutamiento gestionado.
Desde Unify / Portkey / Orq / Kong / APISIX
Defina expectativas de paridad de características (analíticas, límites de seguridad, orquestación, plugins). Muchos equipos operan híbridos: mantenga características especializadas donde sean más fuertes; use ShareAI 3. para elección transparente de proveedores and conmutación por error.
Inicio rápido para desarrolladores (copiar-pegar)
Los siguientes usan un Compatible con OpenAI superficie. Reemplazar YOUR_KEY con tu clave de ShareAI—crea una en Crear clave API. Consulte el Referencia de API para más detalles.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificación de seguridad, privacidad y cumplimiento (independiente del proveedor)
Manejo de claves: cadencia de rotación; alcances mínimos; separación de entornos
Retención de datos: dónde se almacenan los prompts/respuestas, por cuánto tiempo; redacción predeterminada
PII y contenido sensible: enmascaramiento; controles de acceso; enrutamiento regional para la localización de datos
Observabilidad: registro de solicitudes/respuestas; capacidad para filtrar o seudonimizar; propagar IDs de rastreo consistentemente
Respuesta a incidentes: rutas de escalamiento y SLAs del proveedor
Preguntas Frecuentes — BytePlus API Gateway vs otros competidores
BytePlus API Gateway vs ShareAI — ¿cuál para enrutamiento multi-proveedor?
ComparteAI. Está diseñado para transparencia en el mercado (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover a través de muchos proveedores. BytePlus API Gateway es una 2. gobernanza de salida herramienta (credenciales/política centralizada; observabilidad del gateway). Muchos equipos usan ambos—política en el borde + ShareAI para enrutamiento.
BytePlus API Gateway vs OpenRouter — ¿controles del gateway o acceso rápido multi-modelo?
OpenRouter hace que el acceso multi-modelo sea rápido; BytePlus centraliza la política y la observabilidad. Si también quieres transparencia previa a la ruta and conmutación por error instantánea, ShareAI combina acceso de múltiples proveedores con una vista de mercado y enrutamiento resiliente.
BytePlus API Gateway vs Kong — dos gateways
Ambos son gateways (políticas, plugins, analíticas), no mercados. Muchos equipos combinan un gateway con ShareAI 3. para enrutamiento transparente multi-proveedor and conmutación por error.
BytePlus API Gateway vs Portkey — ¿quién es más fuerte en guardrails?
Ambos enfatizan la gobernanza y la observabilidad; la profundidad y la ergonomía difieren. Si tu principal necesidad es elección transparente de proveedores and conmutación por error, añade ShareAI.
BytePlus API Gateway vs LiteLLM — gateway gestionado vs proxy autoalojado
LiteLLM es un proxy DIY que operas; BytePlus es gobernanza/observabilidad gestionada. Si prefieres no ejecutar un proxy and quieres enrutamiento impulsado por el mercado, elige ShareAI.
BytePlus API Gateway vs Unify — aplicación de políticas vs selección del mejor modelo
Unificar se centra en selección impulsada por evaluación; BytePlus en políticas/observabilidad. Para una API sobre muchos proveedores con estadísticas de mercado en vivo, usa ShareAI.
BytePlus API Gateway vs Orq — orquestación vs salida
Orq ayuda a orquestar flujos de trabajo; BytePlus regula el tráfico de salida. ShareAI complementa cualquiera con enrutamiento del mercado.
BytePlus API Gateway vs Apigee — gestión amplia de API vs egreso específico de IA
Apigee es gestión más amplia de API; BytePlus es gobernanza de egreso sesgada hacia IA (cuando se usa de esa manera). Si necesitas acceso independiente del proveedor con transparencia en el mercado, usa ShareAI.
BytePlus API Gateway vs Apache APISIX — llave en mano vs OSS DIY
APISIX ofrece plugins/políticas OSS; BytePlus ofrece una capa gestionada con integraciones de gateway. Para evitar construir enrutamiento personalizado pero obtener selección transparente de proveedores, añade ShareAI.
Si estás buscando un alternativas a TensorBlock Forge, esta guía compara las 10 mejores opciones de la manera en que lo haría un constructor. Primero, aclaramos qué es TensorBlock Forge—luego mapeamos sustitutos creíbles entre agregadores, puertas de enlace, herramientas de orquestación y proxies SDK. Colocamos ShareAI primero para equipos que quieren una API entre muchos proveedores, datos transparentes del mercado (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) antes de enrutar, conmutación por error instantánea, y economía impulsada por personas (70% del gasto fluye hacia los proveedores).
TensorBlock Forge se presenta como una API de IA unificada que ayuda a los desarrolladores a acceder y orquestar modelos entre proveedores con con una clave segura, enfatizando el enrutamiento inteligente, cifrado de nivel empresarial, con conmutación por error automatizada, y control de costos en tiempo real. Esa es una capa de control y enrutamiento para el uso de LLM de múltiples proveedores, no un mercado de modelos transparente que puedas explorar antes de enrutar.
Agregadores vs Gateways vs Orquestadores vs proxies SDK
Agregadores LLM (por ejemplo, ShareAI, OpenRouter, Eden AI): una API para muchos modelos/proveedores con transparencia previa a la ruta (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover.
Gateways de IA (por ejemplo, Traefik AI Gateway, Kong, Apache APISIX, Apigee): política/gobernanza en el borde (credenciales, límites de tasa, barreras de seguridad), más observabilidad. Tú traes los proveedores; ellos aplican y observan.
Plataformas de agentes/orquestación (por ejemplo, Orq, Unify): constructores de flujo, evaluación de calidad y colaboración para pasar de experimentos a producción.
Proxies SDK (por ejemplo, LiteLLM): un proxy ligero/superficie compatible con OpenAI que se adapta a muchos proveedores; ideal para aficionados y autoalojamiento.
Dónde encaja Forge: “API unificada con enrutamiento y control” se superpone a partes de las categorías de agregadores y gateways, pero es no un mercado transparente y neutral que expone en vivo 8. antes de enrutar, antes de enrutar el tráfico.
Cómo evaluamos las mejores alternativas de TensorBlock Forge
Amplitud y neutralidad del modelo — modelos propietarios + abiertos; cambio fácil sin reescrituras.
Latencia y resiliencia — políticas de enrutamiento, tiempos de espera, reintentos, conmutación por error instantánea.
Gobernanza y seguridad — manejo de claves, alcances, enrutamiento regional.
Observabilidad — registros/trazas y paneles de costos/latencia.
Transparencia de precios y TCO — comparar real costos antes de enrutar.
Experiencia del desarrollador — documentación clara, SDKs, inicios rápidos; tiempo hasta el primer token.
Comunidad y economía — ya sea que tu gasto aumente la oferta (incentivos para propietarios de GPU y empresas).
Las 10 mejores alternativas a TensorBlock Forge
#1 — ShareAI (API de IA impulsada por personas)
Qué es. A API de múltiples proveedores con un mercado transparente and enrutamiento inteligente. Con una integración, puedes explorar un amplio catálogo de modelos y proveedores, comparar precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor, y enruta con conmutación por error instantánea. La economía está impulsada por las personas: 70% de cada dólar flujos hacia proveedores (comunidad o empresa) que mantienen los modelos en línea.
Por qué es #1 aquí. Si deseas una agregación independiente del proveedor con transparencia previa a la ruta y resiliencia, ShareAI es el ajuste más directo. Mantén una puerta de enlace si necesitas políticas a nivel de organización; agrega ShareAI para enrutamiento guiado por el mercado.
Una API → catálogo amplio entre muchos proveedores; sin reescrituras, sin bloqueo.
Mercado transparente: elige por precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor.
Resiliencia por defecto: políticas de enrutamiento + conmutación por error instantánea.
Economía justa: 70% del gasto va a los proveedores (comunidad o empresa).
Para proveedores: gana manteniendo modelos en línea. Regístrate a través de Windows, Ubuntu, macOS o Docker. Contribuye con ráfagas de tiempo inactivo o ejecuta siempre activo. Elige tu incentivo: Recompensas (dinero), Intercambio (tokens/AI Prosumer), o Misión (dona un % a ONG). A medida que escalas, puedes establecer tus propios precios de inferencia y obtener exposición preferencial.
Qué es. Una API unificada sobre muchos modelos; ideal para experimentación rápida en un amplio catálogo.
Mejor para. Desarrolladores que quieren probar muchos modelos rápidamente con una sola clave.
Por qué considerar vs Forge. Variedad más amplia de modelos desde el principio; combínalo con ShareAI para estadísticas del mercado y conmutación por error.
#3 — Portkey
Qué es. Una puerta de enlace de IA que enfatiza observabilidad, límites de seguridad, y gobernanza empresarial.
Mejor para. Industrias reguladas que necesitan controles de políticas profundos.
Por qué considerar vs Forge. Si la gobernanza y la observabilidad son tus principales prioridades, Portkey destaca; añade ShareAI para un enrutamiento transparente.
#4 — Kong AI Gateway
Qué es. Pasarela API empresarial con características de tráfico AI/LLM—políticas, plugins, análisis en el borde.
Mejor para. Equipos de plataforma estandarizando controles de salida.
Por qué considerar vs Forge. Gobernanza sólida en el borde; combínalo con ShareAI para una selección guiada por el mercado de múltiples proveedores.
#5 — Eden AI
Qué es. Un agregador que cubre LLMs más IA más amplia (imagen, traducción, TTS), con respaldos y almacenamiento en caché.
Mejor para. Equipos que necesitan multimodalidad en una API.
Por qué considerar vs Forge. Área de superficie de IA más amplia; ShareAI sigue siendo más fuerte en transparencia antes del enrutamiento.
#6 — LiteLLM
Qué es. Un SDK ligero de Python y un proxy opcional autoalojado que expone una interfaz compatible con OpenAI entre proveedores.
Mejor para. Constructores DIY que quieren un proxy en su pila.
Por qué considerar vs Forge. Interfaz familiar de OpenAI y configuración centrada en desarrolladores; combínalo con ShareAI para delegar enrutamiento gestionado y conmutación por error.
#7 — Unify
Qué es.Enrutamiento y evaluación orientados a la calidad. para elegir mejores modelos por solicitud.
Mejor para. Equipos que buscan ganancias de calidad medibles (tasa de éxito) en los prompts.
Por qué considerar vs Forge. Si “elegir el mejor modelo” es el objetivo, las herramientas de evaluación de Unify son el enfoque; agrega ShareAI cuando también desees estadísticas del mercado en vivo y confiabilidad de múltiples proveedores.
#8 — Orq
Qué es.Orquestación y colaboración plataforma para pasar de experimentos a producción con flujos de bajo código.
Mejor para. Equipos construyendo flujos de trabajo/agentes que abarcan múltiples herramientas y pasos.
Por qué considerar vs Forge. Ve más allá de una capa de API hacia flujos orquestados; combínalo con ShareAI para acceso neutral y conmutación por error.
#9 — Traefik AI Gateway
Qué es. A gobernanza primero gateway—credenciales centralizadas y políticas con observabilidad compatible con OpenTelemetry y middlewares especializados en IA (por ejemplo, controles de contenido, almacenamiento en caché).
Mejor para. Organizaciones estandarizando la gobernanza de salida sobre Traefik.
Por qué considerar vs Forge. Capa delgada de IA sobre un gateway probado; agrega ShareAI para elegir proveedores por 8. antes de enrutar, y enrutar de manera resiliente.
#10 — Apache APISIX
Qué es. Un gateway de API de alto rendimiento de código abierto con complementos extensibles y políticas de tráfico.
Mejor para. Equipos que prefieren el control de gateway DIY de código abierto.
Por qué considerar vs Forge. Modelo de políticas y plugins de grano fino; añade ShareAI para obtener transparencia en el mercado y conmutación por error entre múltiples proveedores.
TensorBlock Forge vs ShareAI
Si necesitas una API sobre muchos proveedores con precios/transparencia/latencia/tiempo de actividad/disponibilidad and conmutación por error instantánea, elegir ShareAI. Si tu principal requisito es la gobernanza de salida—credenciales centralizadas, aplicación de políticas y observabilidad profunda—Forge se posiciona más cerca de las herramientas de capa de control. Muchos equipos los combinan: puerta de enlace/control para políticas de la organización + ShareAI para enrutamiento guiado por el mercado.
7. A quién sirve
Plataforma
8. Amplitud del modelo
9. Enrutamiento / conmutación por error
Gobernanza y seguridad
Observabilidad
10. Transparencia del mercado
11. Programa de proveedores
12. Equipos de producto/plataforma que necesitan una API + economía justa
ShareAI
Equipos de producto/plataforma que buscan una API + economía justa
Amplio catálogo entre muchos proveedores
Claves API y controles por ruta
Uso de consola + estadísticas del mercado
Enrutamiento inteligente + conmutación por error instantánea
Sí (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor)
Sí — suministro abierto; 70% a proveedores
TensorBlock Forge
Equipos que desean API unificada + control
Proveedores propios
Manejo centralizado de claves
Análisis en tiempo de ejecución (varía según la configuración)
Enrutamiento condicional, conmutación por error
No (capa de herramientas, no un mercado)
n/a
OpenRouter
Desarrolladores que desean una clave para muchos modelos
Catálogo amplio
Controles básicos de API
Lado de la aplicación
Alternativas
Parcial
n/a
Portkey
Equipos regulados/empresariales
Amplio
Barandillas y gobernanza
Rastros profundos
Enrutamiento condicional
Parcial
n/a
Kong IA Gateway
Empresas que necesitan políticas de puerta de enlace
Trae lo tuyo
Políticas/plugins de borde fuertes
Analíticas
Proxy/plugins, reintentos
No (infra)
n/a
Eden IA
IA de múltiples servicios (LLM + visión/TTS)
Amplio
Controles estándar
Varía
Alternativas/caché
Parcial
n/a
LiteLLM
Proxy DIY/autohospedado
Muchos proveedores
Límites de configuración/clave
Tu infraestructura
Reintentos/alternativas
n/a
n/a
Unificar
Equipos orientados a la calidad
Multi-modelo
Seguridad estándar de API
Analíticas de plataforma
Selección del mejor modelo
n/a
n/a
Orq
Equipos centrados en la orquestación
Amplio soporte
Controles de plataforma
Analíticas de plataforma
Flujos de orquestación
n/a
n/a
Traefik / APISIX
Empresas / DIY
Trae lo tuyo
Políticas
Complementos/personalizados
Personalizado
n/a
n/a
¿Quieres comparar precios en vivo y latencia antes de enrutar? Comienza con el Mercado de Modelos y envía tu primera solicitud desde el Área de pruebas.
Precios y TCO: comparar real costos (no solo precios unitarios)
Los dólares brutos por 1K tokens rara vez cuentan toda la historia. El TCO efectivo cambia con reintentos/retrocesos, latencia (afecta el comportamiento del usuario), variación del proveedor, almacenamiento de observabilidad, y ejecuciones de evaluación. Un mercado transparente te ayuda a elegir rutas que equilibran costo y UX.
Prototipo (~10k tokens/día): Optimizar para tiempo hasta el primer token. Usa el Playground y los quickstarts.
Escala media (~2M tokens/día): El enrutamiento/failover guiado por Marketplace puede recortar 10–20% mientras mejora la UX.
Cargas de trabajo irregulares: Espere costos efectivos más altos de tokens por reintentos durante la conmutación por error; presupuestar para ello.
Guía de migración: mudarse a ShareAI
Desde TensorBlock Forge
Mantén cualquier política de capa de control donde brillen; agrega ShareAI para el enrutamiento del mercado y la conmutación por error instantánea. Patrón: autenticación/política de capa de control → ruta ShareAI por modelo → medir estadísticas del mercado → ajustar políticas.
Desde OpenRouter
Mapea nombres de modelos, verifica la paridad de los prompts, luego sombrea el 10% del tráfico y aumenta 25% → 50% → 100% mientras se mantengan los presupuestos de latencia/errores. Los datos del mercado hacen que los intercambios de proveedores sean sencillos.
Desde LiteLLM
Reemplace el proxy autoalojado en rutas de producción que no desee operar; mantenga LiteLLM para desarrollo si lo desea. Compare la sobrecarga operativa frente a los beneficios de enrutamiento gestionado.
Desde Unify / Portkey / Orq / Kong / Traefik / APISIX
Define expectativas de paridad de características (analíticas, límites, orquestación, plugins). Muchos equipos operan híbridos: mantén características especializadas donde sean más fuertes; usa ShareAI para una elección transparente de proveedores y una conmutación por error resiliente.
Inicio rápido para desarrolladores (copiar-pegar)
Los siguientes usan un Compatible con OpenAI superficie. Reemplaza YOUR_KEY con tu clave de ShareAI—obtén una en Crear clave API.
Lista de verificación de seguridad, privacidad y cumplimiento (independiente del proveedor)
Manejo de claves — cadencia de rotación; alcances mínimos; separación de entornos.
Retención de datos — dónde se almacenan los prompts/respuestas, por cuánto tiempo; redacción por defecto.
PII y contenido sensible — enmascaramiento; controles de acceso; enrutamiento regional para la localización de datos.
Observabilidad — registro de solicitudes/respuestas; capacidad de filtrar o seudonimizar; propagar ID de trazas de manera consistente.
Respuesta a incidentes — rutas de escalamiento y SLAs del proveedor.
FAQ — TensorBlock Forge vs otros competidores
TensorBlock Forge vs ShareAI — ¿cuál para enrutamiento multi-proveedor? Elegir ShareAI. Está diseñado para la transparencia del mercado (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento/respaldo resiliente entre muchos proveedores. Utiliza una capa de puerta de enlace/control cuando la política/observabilidad a nivel organizacional es tu principal necesidad, y combínalo con ShareAI para una elección transparente de proveedores.
TensorBlock Forge vs OpenRouter — ¿acceso rápido multi-modelo o transparencia del mercado? OpenRouter hace que el acceso multi-modelo sea rápido; ShareAI agrega transparencia previa a la ruta and conmutación por error instantánea. Si deseas elegir rutas basadas en datos concretos (precio/latencia/tiempo de actividad/disponibilidad), ShareAI lidera.
TensorBlock Forge vs Eden AI — ¿muchos servicios de IA o enrutamiento enfocado en LLM? Eden AI cubre LLMs además de visión/traducción/TTS. Si principalmente necesitas una elección transparente de proveedores y un respaldo robusto para LLMs, ShareAI encaja mejor.
TensorBlock Forge vs LiteLLM — ¿proxy autoalojado o enrutamiento gestionado? LiteLLM es un proxy DIY que operas. ShareAI proporciona agregación gestionada con estadísticas del mercado y respaldo instantáneo—sin necesidad de operar un proxy.
TensorBlock Forge vs Portkey — ¿quién es más fuerte en guardrails/observabilidad? Portkey enfatiza la gobernanza y trazas profundas. Si también deseas transparencia en precio/latencia y enrutamiento resiliente multi-proveedor, agrega ShareAI.
TensorBlock Forge vs Kong AI Gateway — ¿controles de gateway o mercado? Kong es un gateway fuerte de políticas/analíticas. ShareAI es la capa de mercado/agrupación que selecciona proveedores basándose en datos en vivo y cambia instantáneamente en caso de fallos.
TensorBlock Forge vs Traefik AI Gateway — ¿gobernanza de salida o inteligencia de enrutamiento? Traefik se centra en credenciales centralizadas y observabilidad. ShareAI sobresale en enrutamiento independiente del proveedor con transparencia de mercado—muchos equipos usan ambos.
TensorBlock Forge vs Unify — ¿selección basada en calidad o enrutamiento de mercado? Unify se centra en la selección del mejor modelo basada en evaluaciones. ShareAI añade estadísticas de mercado y confiabilidad multi-proveedor; se complementan entre sí.
TensorBlock Forge vs Orq — ¿orquestación vs enrutamiento? Orq orquesta flujos y agentes; ShareAI te da la capa neutral de proveedores con estadísticas transparentes y conmutación por error.
TensorBlock Forge vs Apache APISIX — ¿gateway de código abierto vs mercado transparente? APISIX ofrece políticas/plugins DIY. ShareAI proporciona transparencia previa a la ruta y conmutación por error gestionada; combina ambos si deseas un control detallado del gateway con enrutamiento guiado por el mercado.
¿TensorBlock Forge vs Apigee — gestión de API vs enrutamiento específico de IA? Apigee es una gestión de API amplia. Para uso de IA, ShareAI agrega la vista del mercado y la resiliencia multi-proveedor que Apigee por sí solo no proporciona.
Descripción general y posicionamiento del sitio de TensorBlock: tensorblock.co
Alternativas a Google Apigee 2026: Top 10
Actualizado septiembre 2026
2. Si estás evaluando Alternativas a Google Apigee, 4. , esta guía mapea el panorama como lo haría un constructor. Primero, aclaramos qué Apigee es—la plataforma de gestión de API empresarial de Google Cloud con proxies de API, un catálogo profundo de políticas (autenticación, cuotas, transformación), análisis y híbrido implementación—luego comparamos las 10 mejores opciones para tráfico de IA/LLM y programas modernos de API. Colocamos ShareAI primero para equipos que desean una API en muchos proveedores, un mercado transparente (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) antes enrutamiento, conmutación por error instantánea y economía impulsada por personas donde 70% de gasto fluye hacia los proveedores. Apigee sigue siendo atractivo para la gestión y gobernanza de API de espectro completo; no es un modelo de mercado agnóstico de proveedores ni un enrutador de múltiples proveedores.
Qué es (y qué no es) Google Apigee
Apigee es el producto de gestión de API completamente gestionado de Google Cloud. Se colocan los backends con proxies de API, se aplican docenas de políticas preconstruidas (seguridad, limitación de velocidad, transformación), se publican portales para desarrolladores, analizar el tráfico y (opcionalmente) ejecutar en híbrido modo con un plano de gestión alojado en Apigee más un tiempo de ejecución que operas en Kubernetes. En un portal de IA contexto, los equipos comúnmente colocan proveedores de LLM detrás de Apigee para claves centralizadas, cuotas y observabilidad. Pero Apigee no es neutral mercado de modelos ni un enrutador inteligente de múltiples proveedores—tú traes los proveedores; Apigee proporciona gobernanza y análisis.
Si deseas la introducción oficial más tarde, comienza con la página del producto Apigee y la descripción general “¿Qué es Apigee?”.
Agregadores vs Gateways vs Plataformas de Agentes/Orquestación
Agregadores de LLM (por ejemplo, ShareAI, OpenRouter, Eden AI) – Una API para muchos modelos/proveedores con transparencia previa a la ruta (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento/conmutación por error incorporados. ShareAI también enfatiza la economía impulsada por personas (70% a proveedores) y la amplitud del catálogo (150+ modelos).
Puertas de enlace AI/API (por ejemplo, Apigee, Kong, Traefik AI Gateway, Apache APISIX, NGINX, Portkey) – Centralizar credenciales, políticas, cuotas y observabilidad en el borde; tú traes proveedores. Apigee vive aquí; es centrado en programación de API, no un mercado de modelos.
Plataformas de agentes/orquestación (por ejemplo, Orq, Unify) – Flujos empaquetados, herramientas, evaluaciones y colaboración—excelente para experimentos y orquestación de producción, no para enrutamiento independiente de proveedores.
TL;DR: Si necesitas elección de modelo guiada por el mercado and conmutación por error instantánea, elige una agregador. Si necesitas política empresarial, gobernanza, análisis y portales, elige un puerta de enlace. Muchos equipos de producción combinan ambos.
Cómo evaluamos las mejores alternativas a Google Apigee
Amplitud y neutralidad del modelo: propietario + abierto; intercambio rápido; sin reescrituras.
Latencia y resiliencia: políticas de enrutamiento, tiempos de espera/reintentos, conmutación por error instantánea.
Gobernanza y seguridad: manejo de claves, alcances, políticas a nivel de organización, enrutamiento regional.
Observabilidad: registros/rastros y paneles de costos/latencia que realmente usarás.
Transparencia de precios y TCO: comparar real costos antes de enrutar.
Experiencia del desarrollador: documentos, SDKs, inicios rápidos; tiempo hasta el primer token.
Comunidad y economía: si tu gasto aumenta el suministro (incentivos para propietarios de GPU).
Las 10 mejores alternativas a Google Apigee
#1 — ShareAI (API de IA impulsada por personas)
Qué es. A API de múltiples proveedores con un mercado transparente and enrutamiento inteligente. Con una integración, explora un amplio catálogo de modelos y proveedores, compara precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor, y enruta con conmutación por error instantánea. La economía es impulsada por personas: 70% de cada dólar fluye hacia los proveedores (comunidad o empresa) que mantienen los modelos en línea.
Por qué es #1 aquí. Si quieres agregación independiente del proveedor con transparencia previa a la ruta and resiliencia, ShareAI es el ajuste más directo. Mantén Apigee si necesitas a nivel de organización programa de API características (catálogo de políticas, análisis, portales); agregar ShareAI para enrutamiento guiado por el mercado.
Una API → más de 150 modelos a través de muchos proveedores; sin reescrituras, sin dependencia.
Mercado transparente: elige por precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor.
Resiliencia por defecto: políticas de enrutamiento + conmutación por error instantánea.
Economía justa: 70% del gasto va a los proveedores (comunidad o empresa).
Para proveedores: gana manteniendo los modelos en línea Cualquiera puede convertirse en un proveedor de ShareAI—Comunidad or Empresa. Incorporarse a través de Windows, Ubuntu, macOS o Docker. Contribuir tiempo inactivo ráfagas o ejecuta siempre activo. Elige tu incentivo: Recompensas (dinero), Intercambio (tokens/AI Prosumer), o Misión (donar un % a ONGs). A medida que escalas, puedes establecer tus propios precios de inferencia y ganar exposición preferencial. Comience en el Guía del proveedor o gestionar dispositivos a través del Panel de Control del Proveedor.
#2 — Kong AI Gateway
Qué es. Gateway empresarial para gobernanza, políticas/plugins, análisis y observabilidad en el borde. Es un plano de control en lugar de un mercado.
#3 — Portkey
Qué es. puerta de enlace de IA que enfatiza observabilidad, límites de seguridad, y gobernanza—a menudo elegido para cargas de trabajo reguladas.
#4 — OpenRouter
Qué es. Agregador con un amplio catálogo de modelos y un API unificada; excelente para la experimentación rápida entre proveedores.
#5 — Eden AI
Qué es. Agrega LLMs más capacidades de IA más amplias (visión, traducción, TTS) con alternativas/caché y procesamiento por lotes.
#6 — LiteLLM
Qué es. SDK ligero de Python + proxy autoalojable que utiliza una interfaz compatible con OpenAI para muchos proveedores.
#7 — Unify
Qué es.Orientado a la calidad enrutamiento y evaluación para elegir mejores modelos por solicitud.
#8 — Orq
Qué es.Orquestación/colaboración plataforma que ayuda a los equipos a pasar de experimentos a producción con flujos de bajo código.
#9 — Apache APISIX
Qué es.Pasarela de API de código abierto (plugins, control de tráfico, políticas). Tú traes los proveedores; APISIX aplica el comportamiento del gateway.
#10 — NGINX
Qué es. Enfoque DIY: construir enrutamiento, aplicación de tokens, y almacenamiento en caché para backends LLM con primitivas de alto rendimiento.
Apigee vs ShareAI
Si necesitas una API sobre muchos proveedores con precio/transparencia/latencia/tiempo de actividad and conmutación por error instantánea, elegir ShareAI. 1. . Si su requisito principal es gestión de API empresarial3. —credenciales centralizadas, aplicación de políticas, analíticas, híbrido/multinube—Apigee encaja en ese ámbito. Muchos equipos los combinan: Apigee para la política de organización y portales de desarrolladores, ShareAI para enrutamiento guiado por el mercado y resiliencia.
Comparación rápida (de un vistazo)
Plataforma
8. Amplitud del modelo
9. Enrutamiento / conmutación por error
Gobernanza y seguridad
Observabilidad
10. Transparencia del mercado
11. Programa de proveedores
12. Equipos de producto/plataforma que necesitan una API + economía justa
ShareAI
13. , muchos proveedores
más de 150 modelos, 14. Claves API y controles por ruta
Claves API y controles por ruta
Uso de consola + estadísticas del mercado
Enrutamiento inteligente + conmutación por error instantánea
Sí (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor)
Sí — suministro abierto; 70% a proveedores
Apigee
Empresas que necesitan una gestión amplia de API
Proveedores/modelos propios
Biblioteca de políticas sólida (autenticación, cuotas, transformación)
Análisis y monitoreo integrados
Flujos de proxy condicionales, reintentos
No (gobernanza de plataforma, no un mercado)
n/a
Las fortalezas de Apigee en bibliotecas de políticas, análisis, portales y el híbrido tiempo de ejecución son bien conocidas; transparencia y enrutamiento en mercados de múltiples proveedores en vivo con agregadores como ShareAI.
Precios y TCO: comparar real costos (no solo precios unitarios)
Crudo $/1K tokens oculta la imagen real. TCO cambios con reintentos/alternativas, latencia (lo que cambia el uso), variación de proveedores, almacenamiento de observabilidad y ejecuciones de evaluación. A mercado transparente te ayuda a elegir rutas que equilibren costo and UX.
Prototipo (~10k tokens/día): Optimizar para tiempo hasta el primer token (usar el Abrir Playground y los inicios rápidos).
Escala media (~2M tokens/día):Enrutamiento guiado por el marketplace + conmutación por error puede recortar un 10–20% mientras mejora la UX.
Cargas de trabajo irregulares: Espere costos efectivos más altos de tokens por reintentos durante la conmutación por error; presupuesto para ello.
Guía de migración: mudarse a ShareAI
Desde Apigee Mantén Apigee donde destaca (política, gobernanza, portales, análisis); agrega ShareAI para el enrutamiento del marketplace + conmutación por error instantánea. Patrón: autenticación/política de Apigee → enrutamiento de ShareAI por modelo → monitorear estadísticas del marketplace → ajustar políticas.
Desde OpenRouter Mapear nombres de modelos, verificar paridad de indicaciones; sombra 10% de tráfico y rampa 25% → 50% → 100% mientras se mantengan los presupuestos de latencia/errores. Los datos del mercado hacen que los intercambios de proveedores sean sencillos.
Desde LiteLLM Reemplace el proxy autoalojado en rutas de producción que no desee operar; mantenga LiteLLM para desarrollo si lo desea. Compare la sobrecarga operativa frente a los beneficios de enrutamiento gestionado.
Desde Unify / Portkey / Orq / Kong / APISIX / NGINX Definir expectativas de paridad de características (analíticas, límites, orquestación, complementos). Muchos equipos trabajan de forma híbrida: mantienen características especializadas donde son más fuertes; usan ShareAI para elección de proveedor transparente y conmutación por error.
Inicio rápido para desarrolladores (copiar-pegar)
Los siguientes usan un Compatible con OpenAI superficie. Reemplazar YOUR_KEY con tu clave de ShareAI—crea una en Crear clave API. Consulte el Referencia de API para más detalles.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Lista de verificación de seguridad, privacidad y cumplimiento (independiente del proveedor)
Manejo clave: cadencia de rotación; alcances mínimos; separación de entornos.
Retención de datos: donde se almacenan las indicaciones/respuestas; ventana de retención; valores predeterminados de redacción.
PII y contenido sensible: enmascaramiento; controles de acceso; enrutamiento regional para la localidad de datos.
Observabilidad: registro de indicaciones/respuestas; capacidad de filtrar o seudonimizar; propagar ID de trazas de manera consistente.
Respuesta a incidentes: rutas de escalamiento y SLAs del proveedor.
Preguntas frecuentes — Apigee vs otros competidores (más variantes competidor-vs-competidor)
Apigee vs ShareAI — ¿cuál para enrutamiento multi-proveedor?
ComparteAI. Está diseñado para la transparencia del mercado (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover a través de muchos proveedores. Apigee es una plataforma de gestión de API (políticas, análisis, híbrido, portales). Muchos equipos usan ambos.
Apigee vs OpenRouter — ¿acceso rápido a múltiples modelos o controles de puerta de enlace?
OpenRouter hace que el acceso multi-modelo sea rápido; Apigee centraliza la política y la observabilidad. Si también quieres transparencia previa a la ruta and conmutación por error instantánea, ShareAI combina acceso multi-proveedor con una vista de mercado y enrutamiento resiliente.
Apigee vs LiteLLM — ¿proxy autoalojado o gobernanza gestionada?
LiteLLM es un proxy DIY que operas; Apigee ofrece gobernanza/observabilidad gestionada para cualquier tráfico de API. Si prefieres no ejecutar un proxy and deseas enrutamiento impulsado por el mercado, elige ShareAI.
Apigee vs Portkey — ¿quién es más fuerte en las barreras de seguridad?
Ambos enfatizan la gobernanza/observabilidad; la profundidad y la ergonomía difieren. Si tu principal necesidad es elección transparente de proveedores and conmutación por error, añade ShareAI.
Apigee vs Unify — ¿selección del mejor modelo vs aplicación de políticas?
Unificar se centra en la selección de modelos basada en evaluación; Apigee en políticas y análisis. Para una API sobre muchos proveedores con estadísticas de mercado en vivo, utiliza ShareAI.
Apigee vs Eden AI — ¿muchos servicios de IA o control de salida?
Eden IA agrega múltiples servicios de IA (LLM, imagen, TTS). Apigee centraliza políticas/credenciales y análisis. Para precios/transparencia de latencia entre muchos proveedores y conmutación por error instantánea, elegir ShareAI.
Apigee vs Orq — ¿orquestación vs salida?
Orq ayuda a orquestar flujos de trabajo; Apigee regula el tráfico de salida y los portales de desarrolladores. ShareAI complementa cualquiera con enrutamiento de mercado.
Apigee vs Kong AI Gateway — dos gateways
Ambos son gateways (políticas, plugins, analíticas), no mercados. Muchos equipos combinan un gateway con ShareAI 3. para enrutamiento transparente multi-proveedor and conmutación por error.
Apigee vs Apache APISIX — ¿gateway de código abierto o plataforma gestionada?
APISIX es de código abierto y basado en complementos; Apigee está completamente gestionado con características empresariales avanzadas (políticas, análisis, híbrido). Si también necesitas acceso neutral al modelo de proveedores y enrutamiento inteligente, añade ShareAI.
Apigee vs NGINX — bricolaje vs llave en mano
NGINX ofrece filtros/políticas DIY; Apigee ofrece una capa de plataforma empaquetada con análisis y portales. Para evitar la escritura de scripts personalizados y aún obtener selección transparente de proveedores, capa en ShareAI.
OpenRouter vs Apache APISIX (competidor-vs-competidor)
Manzanas y naranjas: OpenRouter es un agregador (una API sobre muchos modelos), mientras APISIX es un puerta de enlace. Para la transparencia del mercado + enrutamiento de múltiples proveedores, ShareAI supera a ambos al emparejar catálogo + enrutamiento + conmutación por error—y puede estar detrás de gateways como APISIX cuando se desea política de borde más selección inteligente de modelos.
Kong vs Portkey (competidor-vs-competidor)
Ambos son gateways con gobernanza/observabilidad; Kong tiene un ecosistema de plugins maduro, mientras Portkey enfatiza las barreras específicas de IA y trazas profundas. De cualquier manera, ShareAI suministros transparencia previa a la ruta and enrutamiento resiliente más allá del alcance del gateway.
Traefik AI Gateway vs Apigee (competidor-vs-competidor)
Ambos son gateways; Puerta de Enlace de IA de Traefik agrega una capa delgada de IA y middlewares especializados, mientras Apigee es una suite integral de gestión de API con híbrido, portales y análisis. Muchos equipos usan ShareAI para el mercado y conmutación por error instantánea pieza.
LiteLLM vs NGINX (competidor-vs-competidor)
LiteLLM = proxy autohospedado; NGINX = primitivas de gateway DIY. Si no quieres operar infraestructura y aún necesitas independiente del proveedor acceso con enrutamiento inteligente, ShareAI es más simple.
Unify vs Eden AI (competidor-vs-competidor)
Unificar se centra en la evaluación basada selección del mejor modelo; Eden IA abarca muchos tipos de servicios de IA. ShareAI complementa cualquiera con un mercado transparente and conmutación por error instantánea entre proveedores.
Dónde encaja ShareAI a continuación
Explorar modelos: Comparar precios, latencia, tiempo de actividad, disponibilidad y tipo de proveedor en Explorar Modelos.
Probar ahora: Envía tu primer mensaje en el Abrir Playground (no se requiere SDK).
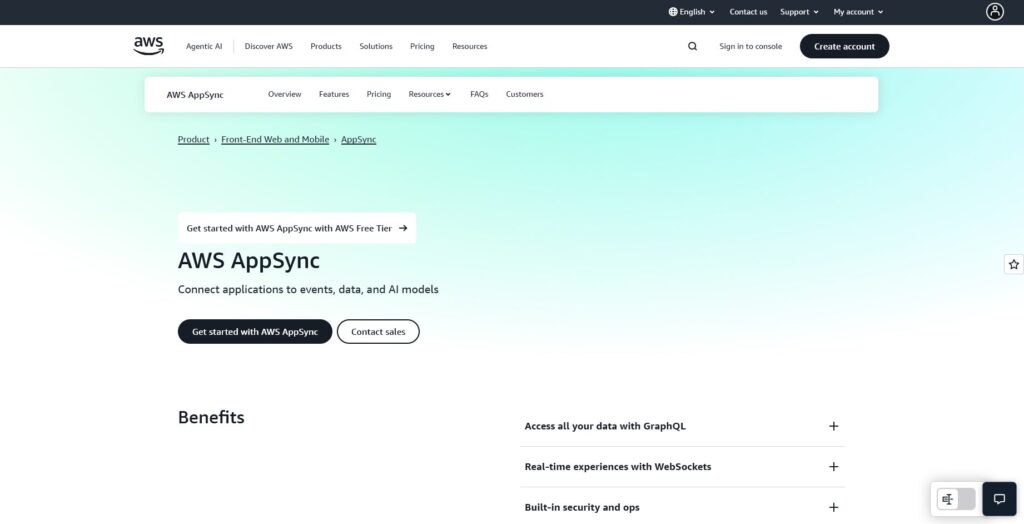
2. Si estás evaluando Alternativas a AWS AppSync, esta guía mapea el panorama como lo haría un constructor. Primero, aclaramos qué es AppSync—un servicio GraphQL completamente gestionado que se conecta a fuentes de datos de AWS (DynamoDB, Lambda, Aurora, OpenSearch, HTTP), admite suscripciones en tiempo real a través de WebSockets y se utiliza a menudo como un patrón de “puerta de enlace de IA” frente a Amazon Bedrock—luego comparamos el 10 mejores alternativas. Colocamos ShareAI primero para equipos que quieren una API entre muchos proveedores, un mercado transparente con precio/latencia/tiempo de actividad/disponibilidad antes de enrutar, conmutación por error instantánea, y economía impulsada por personas (70% de gasto va a los proveedores).
Qué es (y qué no es) AWS AppSync
Qué es AppSync. AppSync es la capa GraphQL gestionada de AWS: analiza consultas y mutaciones, resuelve campos contra fuentes de datos configuradas (DynamoDB, Lambda, Aurora, OpenSearch, HTTP) y puede enviar actualizaciones en tiempo real usando GraphQL suscripciones a través de WebSockets seguros. También ofrece resolutores JavaScript para que puedas escribir lógica de resolutores en JS familiar. En aplicaciones de IA, muchos equipos frente Amazon Bedrock con AppSync: manejando autenticación y limitación en GraphQL mientras transmite tokens a clientes mediante suscripciones.
Lo que AppSync no es. Es no un mercado de modelos y no unifica el acceso a muchos proveedores de IA de terceros bajo una API. Usted trae servicios de AWS (y Bedrock). Para el enrutamiento de múltiples proveedores (transparencia previa al enrutamiento; conmutación por error entre proveedores), empareje o reemplace con un agregador como ShareAI.
Por qué escucha “puerta de enlace de IA para Bedrock”.” GraphQL + WebSockets + resolutores de AppSync lo convierten en una capa natural de salida/gobernanza frente a Bedrock para cargas de trabajo tanto sincrónicas como de transmisión. Usted mantiene GraphQL como su contrato de cliente mientras invoca Bedrock en sus resolutores o funciones.
Agregadores vs Gateways vs plataformas de agentes
Agregadores de LLM (ShareAI, OpenRouter, Eden AI, LiteLLM): una API entre muchos modelos/proveedores con transparencia previa a la ruta (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover.
Puertas de enlace de IA (Kong AI Gateway, Portkey, AppSync-as-gateway, Apigee/NGINX/APISIX/Tyk/Azure APIM/Gravitee): gobernanza en el borde (claves, cuotas, límites), observabilidad, y política — usted trae proveedores.
Plataformas de agentes/chatbots (Unify, Orq): evaluación empaquetada, herramientas, memoria, canales—orientados a la lógica de la aplicación en lugar de la agregación independiente del proveedor.
En la práctica, muchos equipos ejecutan ambos: una puerta de enlace para la política organizacional + ShareAI para enrutamiento guiado por el mercado y resiliencia.
Cómo evaluamos las mejores alternativas a AppSync
Amplitud y neutralidad del modelo: propietario + abierto; cambio fácil; sin reescrituras.
Latencia y resiliencia: políticas de enrutamiento, tiempos de espera, reintentos, conmutación por error instantánea.
Gobernanza y seguridad: manejo de claves, alcances, enrutamiento regional.
Observabilidad: registros/trazas y paneles de costos/latencia.
Transparencia de precios y TCO: comparar real costos antes de enrutar.
Experiencia del desarrollador: documentos, SDKs, inicios rápidos; tiempo hasta el primer token.
Comunidad y economía: si su gasto aumenta el suministro (incentivos para propietarios/proveedores de GPU).
Las 10 mejores alternativas a AWS AppSync
#1 — ShareAI (API de IA impulsada por personas)
Qué es. A API de múltiples proveedores con un mercado transparente and enrutamiento inteligente. Con una integración, explore un amplio catálogo de modelos y proveedores; compare precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor; y enrute con conmutación por error instantánea. La economía está impulsada por personas: 70% de cada dólar flujos hacia proveedores (comunidad o empresa) que mantienen los modelos en línea.
Por qué es #1 aquí. Si quieres agregación independiente del proveedor con transparencia previa a la ruta and resiliencia, ShareAI es el ajuste más directo. Mantén una puerta de enlace si necesitas políticas a nivel organizacional; agrega ShareAI para enrutamiento guiado por el mercado.
Una API → 150+ modelos a través de muchos proveedores; sin reescrituras, sin dependencia.
Mercado transparente: elige por precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor.
Resiliencia por defecto: políticas de enrutamiento + conmutación por error instantánea.
Economía justa: el 70% del gasto va a los proveedores (comunidad o empresa).
Para proveedores: gana manteniendo modelos en línea. Embarcarse a través de Windows, Ubuntu, macOS, Docker; contribuya tiempo inactivo ráfagas o ejecuta siempre activo. Elige tu incentivo: Recompensas (dinero), Intercambio (tokens/AI Prosumer), o Misión (done un % a ONG). A medida que escala, puede establecer precios de inferencia y obtener exposición preferencial. Guía del proveedor · Panel de Control del Proveedor
#2 — Kong AI Gateway
Qué es. Puerta de enlace empresarial de IA/LLM: gobernanza, complementos/políticas, análisis y observabilidad para el tráfico de IA en el borde. Es un plano de control en lugar de un mercado.
#3 — Portkey
Qué es. Puerta de enlace de IA que enfatiza las barreras de seguridad, la gobernanza y la observabilidad profunda, popular en entornos regulados.
#4 — OpenRouter
Qué es. Una API unificada sobre muchos modelos; ideal para experimentación rápida en un amplio catálogo.
#5 — Eden AI
Qué es. Agrega LLMs más IA más amplia (imagen, traducción, TTS), con retrocesos/caché y agrupación.
#6 — LiteLLM
Qué es. Un SDK ligero de Python + proxy autoalojable que utiliza una interfaz compatible con OpenAI para muchos proveedores.
#7 — Unify
Qué es. Enrutamiento basado en evaluación y comparación de modelos para elegir mejores modelos por solicitud.
#8 — Orq AI
Qué es. Plataforma de orquestación/colaboración que ayuda a los equipos a pasar de experimentos a producción con flujos de bajo código.
#9 — Apigee (con LLMs detrás)
Qué es. Una plataforma madura de gestión de API que puede colocar frente a proveedores de LLM para aplicar políticas, claves y cuotas.
#10 — NGINX
Qué es. Usa NGINX para construir enrutamiento personalizado, aplicación de tokens y caché para los backends de LLM si prefieres control DIY.
Estos son resúmenes direccionales para ayudarle a hacer una lista corta. Para catálogos de modelos, precios en vivo o características de proveedores, explore el mercado ShareAI y ruta basada en tiempo real 8. antes de enrutar,.
AWS AppSync vs ShareAI
Si necesitas una API sobre muchos proveedores con precios/transparencia/latencia/tiempo de actividad and conmutación por error instantánea, elegir ShareAI. 1. . Si su requisito principal es 2. gobernanza de salida y nativo de AWS GraphQL con suscripciones en tiempo real, AppSync encaja en ese ámbito—especialmente al frente de Amazon Bedrock cargas de trabajo. Muchos equipos los combinan: puerta de enlace para políticas de la organización + ShareAI para enrutamiento de mercado.
7. A quién sirve
Plataforma
8. Amplitud del modelo
9. Enrutamiento / conmutación por error
Gobernanza y seguridad
Observabilidad
10. Transparencia del mercado
11. Programa de proveedores
12. Equipos de producto/plataforma que necesitan una API + economía justa
ShareAI
13. , muchos proveedores
Más de 150 modelos, muchos proveedores
Claves API y controles por ruta
Uso de consola + estadísticas del mercado
Enrutamiento inteligente + conmutación por error instantánea
Sí (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor)
Sí — suministro abierto; 70% a proveedores
AWS AppSync
Equipos que desean GraphQL nativo de AWS + tiempo real + integración con Bedrock
Trae lo tuyo (Bedrock, servicios de datos de AWS)
Autenticación/llaves centralizadas en AWS
Patrones compatibles con CloudWatch/OTel
Distribución condicional mediante resolutores/suscripciones
No (herramienta de infraestructura, no un mercado)
n/a
Kong IA Gateway
Empresas que necesitan políticas a nivel de puerta de enlace
Trae lo tuyo
Políticas/plugins de borde fuertes
Analíticas
Proxy/plugins, reintentos
No (infra)
n/a
OpenRouter
Desarrolladores que desean una clave para muchos modelos
Catálogo amplio
Controles básicos de API
Lado de la aplicación
Alternativas
Parcial
n/a
(Tabla resumida. Usa el mercado ShareAI para comparar en vivo precio/latencia/disponibilidad entre proveedores.)
Precios y TCO: comparar real costos (no solo precios unitarios)
$/1K tokens en bruto oculta la realidad. El TCO cambia con reintentos/alternativas, latencia (afectando el uso), variación del proveedor, almacenamiento de observabilidad y ejecuciones de evaluación. A mercado transparente ayuda a elegir rutas que equilibran costo y UX.
Prototipo (~10k tokens/día): optimizar para tiempo hasta el primer token (Playground, inicios rápidos).
Escala media (~2M tokens/día): enrutamiento/failover guiado por el mercado puede recortar 10–20% mientras mejora la UX.
Cargas de trabajo irregulares: espera costos efectivos de tokens más altos por reintentos durante el failover; presupuesta para ello.
Notas de migración: moviendo to ShareAI
Desde AWS AppSync (como puerta de enlace para Bedrock): Mantenga las políticas a nivel de gateway donde brillen; agregue ShareAI 3. para enrutamiento de mercado + conmutación por error instantánea entre múltiples proveedores. Patrón: Autenticación/política de AppSync → ruta por modelo de ShareAI → medir estadísticas del mercado → ajustar políticas.
Desde OpenRouter: Mapear nombres de modelos, verificar paridad de indicaciones; sombra 10% del tráfico y aumentar gradualmente 25% → 50% → 100% mientras se mantengan los presupuestos de latencia/errores.
Desde LiteLLM: Reemplazar el proxy autoalojado en rutas de producción que no deseas operar; mantener LiteLLM para desarrollo si se desea. Comparar la sobrecarga operativa frente a los beneficios de enrutamiento gestionado.
De Unify / Portkey / Orq / Kong: Definir expectativas de paridad de características (analíticas, límites, orquestación, complementos). Muchos equipos ejecutan híbrido: mantener características especializadas donde son más fuertes; usar ShareAI para elección transparente de proveedores y recuperación.
Inicio rápido para desarrolladores (copiar-pegar)
Los siguientes usan un Compatible con OpenAI superficie. Reemplazar YOUR_KEY con su clave de ShareAI—obtenga una en Crear clave API. Consulte el Referencia de API para más detalles.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
¿Prefieres no codificar ahora? Abre el Playground y ejecutar una solicitud en vivo en minutos.
Lista de verificación de seguridad, privacidad y cumplimiento (independiente del proveedor)
Manejo clave: cadencia de rotación; alcances mínimos; separación de entornos.
Retención de datos: donde se almacenan los mensajes/respuestas, cuánto tiempo; valores predeterminados de redacción.
PII y contenido sensible: enmascaramiento; controles de acceso; enrutamiento regional para la localidad de datos.
Observabilidad: registro de indicaciones/respuestas; capacidad de filtrar o seudonimizar; propagar ID de trazas de manera consistente.
Respuesta a incidentes: rutas de escalamiento y SLAs del proveedor.
Preguntas frecuentes — AWS AppSync vs otros competidores
AWS AppSync vs ShareAI — ¿cuál para enrutamiento multi-proveedor? ComparteAI. Está diseñado para transparencia en el mercado (precio, latencia, tiempo de actividad, disponibilidad, tipo de proveedor) y enrutamiento inteligente/failover 14. enrutamiento inteligente y conmutación por error instantánea muchos proveedores. AppSync es nativo de AWS GraphQL con Roca madre integraciones y suscripciones. Muchos equipos usan ambos: AppSync para GraphQL/política; ShareAI para acceso agnóstico al proveedor y resiliencia.
AWS AppSync vs OpenRouter — ¿acceso rápido multi-modelo o controles GraphQL? OpenRouter hace que el acceso multi-modelo sea rápido; AppSync centraliza la política y las suscripciones en tiempo real de GraphQL en AWS. Si también quieres transparencia previa a la ruta and conmutación por error instantánea entre proveedores, añadir ShareAI detrás de tu API.
AWS AppSync vs LiteLLM — ¿proxy autoalojado o GraphQL gestionado? LiteLLM es un proxy/SDK DIY; AppSync está gestionado GraphQL con suscripciones WebSocket e integraciones de fuentes de datos de AWS. Para un mercado impulsado por elección de proveedor and conmutación por error, enrutar vía ShareAI.
AWS AppSync vs Portkey — ¿quién es más fuerte en medidas de seguridad? Ambos enfatizan la gobernanza; la ergonomía difiere. Si tu necesidad principal es elección transparente de proveedores and conmutación por error entre múltiples proveedores, añadir ShareAI.
AWS AppSync vs Unify — ¿selección basada en evaluación o salida GraphQL? Unificar se centra en la selección de modelos basada en evaluación; AppSync se centra en la salida GraphQL + integraciones de AWS. Para una API sobre muchos proveedores con estadísticas de mercado en vivo, elige ShareAI.
AWS AppSync vs Orq — ¿orquestación o GraphQL? Orq orquesta flujos; AppSync es una capa de acceso a datos GraphQL con vínculos en tiempo real + Bedrock. Usa ShareAI para una selección de proveedor transparente y conmutación por error.
AWS AppSync vs Apigee — ¿Gestión de API vs GraphQL específico de IA? Apigee es gestión amplia de API; AppSync es el servicio GraphQL de AWS con suscripciones e integraciones de servicios AWS. Si deseas acceso independiente del proveedor con transparencia de mercado, conecta ShareAI.
AWS AppSync vs NGINX — ¿Hazlo tú mismo vs llave en mano? NGINX ofrece filtros y políticas DIY; AppSync ofrece una capa GraphQL gestionada con WebSockets/suscripciones. Para evitar configuraciones de bajo nivel y aún obtener selección de proveedor transparente, enruta a través de ShareAI.
AWS AppSync vs Kong AI Gateway — dos gateways Ambos son gateways (políticas, plugins, analíticas), no mercados. Muchos equipos combinan un gateway con ShareAI 3. para enrutamiento transparente multi-proveedor and conmutación por error.
AWS AppSync vs Apache APISIX — GraphQL vs gateway de API APISIX es un potente gateway de API para políticas y enrutamiento; AppSync es GraphQL gestionado para datos de AWS + Bedrock. Para neutralidad de modelos y comparaciones en vivo de precio/latencia/tiempo de actividad, añade ShareAI.
AWS AppSync vs Tyk — motor de políticas vs capa de resolución GraphQL Tyk centraliza políticas/cupos/claves; AppSync centraliza GraphQL y entrega en tiempo real. Para enrutamiento de IA independiente del proveedor y conmutación por error instantánea, elige ShareAI.
AWS AppSync vs Azure API Management — elección en la nube Azure APIM es la puerta de enlace empresarial de Microsoft; AppSync es el servicio GraphQL de AWS. Si también deseas IA multiproveedor con transparencia en el mercado, utiliza ShareAI.
AWS AppSync vs Gravitee — puerta de enlace de código abierto vs GraphQL gestionado Gravitee es una puerta de enlace API con políticas, análisis y eventos; AppSync está diseñado específicamente para GraphQL + tiempo real. Para visibilidad de precio/latencia/disponibilidad previa a la ruta y conmutación por error, añade ShareAI.
Cuando AppSync destaca (y cuando no lo hace)
Destaca para: pilas centradas en AWS que desean GraphQL, tiempo real mediante suscripciones, y estrechas Roca madre conexiones — todo dentro de los flujos de autenticación/IAM de AWS y CloudWatch/OTel.
Menos ideal para:multiproveedor enrutamiento de IA entre nubes/proveedores, comparaciones transparentes previas a la ruta (precio/latencia/disponibilidad), o automático conmutación por error a través de muchos proveedores. Eso es ShareAI’el carril de.
Cómo los patrones de AppSync se mapean a Bedrock (para contexto)
Invocaciones cortas y síncronas a modelos de Bedrock directamente desde resolvers — bueno para respuestas rápidas.
De larga duración/streaming: usar suscripciones/WebSockets para transmitir tokens progresivamente a los clientes; combinar con backends impulsados por eventos cuando sea necesario.
Cómo monetizar el tiempo inactivo de la GPU con ShareAI
Si has comprado una GPU potente para juegos, IA o minería, probablemente te hayas preguntado cómo monetizar la GPU cuando no la estás utilizando. La mayor parte del tiempo, tu hardware solo consume electricidad y se deprecia. ShareAI te permite monetizar el tiempo inactivo de la GPU alquilándola para cargas de trabajo de inferencia de IA, así que te pagan por el “tiempo muerto” que tus GPUs y servidores normalmente desperdiciarían.
TL;DR: Por qué funciona monetizar el tiempo muerto de la GPU con ShareAI
Tiempo muerto ⇒ dinero perdido. Las GPUs de consumo y de centros de datos suelen estar infrautilizadas, especialmente fuera de las horas pico.
ShareAI agrega la demanda de startups que necesitan inferencia bajo demanda y la dirige a tu hardware.
Te pagan por cada token servido, sin tener que lidiar con DevOps ni alquilar máquinas completas a desconocidos.
Cómo ShareAI convierte GPUs inactivas en ingresos (sin gestión de servidores)
ShareAI opera una red descentralizada de GPU que empareja trabajos de inferencia en tiempo real con dispositivos disponibles. Ejecutas un agente proveedor ligero; la red maneja el despacho de modelos, el enrutamiento y la conmutación por error. En lugar de buscar trabajos, simplemente estás en línea cuando quieres y ganas siempre que tu GPU sirva tokens.
Pago por token, no “alquila-mi-equipo”
Los alquileres tradicionales bloquean tu equipo por horas o días—genial cuando está ocupado, terrible cuando está inactivo. ShareAI cambia esto: ganas por uso, así que en el momento en que la demanda se detiene, tu exposición de costos es cero. Eso significa que el “tiempo muerto” finalmente paga.
Para fundadores: pagas por token consumido (sin inactividad 24/7 en instancias costosas).
Para proveedores: usted captura picos de demanda de muchos compradores que nunca alcanzaría solo.
El Flujo de Dinero: Quién Paga, Quién Recibe el Pago
Un desarrollador llama a ShareAI para un modelo (por ejemplo, un modelo de texto de la familia Llama).
La red dirige la solicitud a un nodo compatible (su GPU).
Los tokens se transmiten de vuelta; los pagos se acumulan para usted basado en los tokens servidos.
Si su nodo se desconecta a mitad del trabajo, conmutación automática por error mantiene al usuario feliz mientras su sesión simplemente termina—sin supervisión manual.
Porque ShareAI agrupa la demanda, su GPU puede mantenerse ocupada solo cuando tiene sentido—exactamente cuándo compradores necesitan rendimiento y tú estás disponible.
Paso a Paso: Monetiza GPU en Minutos (Ruta del Proveedor)
Verifica hardware y VRAM 8–24 GB de VRAM funciona para muchos modelos de texto; más VRAM desbloquea modelos más grandes/tareas de visión. Térmicas estables y una conexión confiable ayudan.
Instala el agente del proveedor Sigue la Guía del Proveedor para instalar, registrar tu dispositivo y pasar verificaciones básicas. Documentos: Guía del proveedor
Elige lo que ofreces Opta por colas que se ajusten a tu VRAM (por ejemplo, modelos de texto 7B/13B, visión ligera). Más ventanas de disponibilidad = más ganancias.
Conéctate y gana Cuando no estés jugando o entrenando localmente, activa tu nodo en línea y deja que ShareAI asigne trabajo automáticamente.
Rastrea ganancias y tiempo activo Usa el Panel de Proveedor (a través de la Consola) para monitorear sesiones, tokens y pagos. Consola (claves, uso): Crear clave API • Guía del Usuario: Resumen de la Consola
Manual de Optimización para Proveedores
Empareja VRAM con colas: Prioriza modelos que se ajusten cómodamente; evita casos límite de OOM que interrumpan sesiones.
Planifica ventanas de disponibilidad: Si juegas por la noche, configura tu nodo en línea durante las horas de trabajo o durante la noche—cuando la demanda aumenta.
La estabilidad de la red importa: Wi-Fi cableado o sólido mantiene un rendimiento constante y reduce los fallos.
Térmicas y energía: Mantén las temperaturas bajo control; relojes consistentes = ganancias consistentes.
Escalar: Si posees múltiples GPUs o un pequeño servidor, intégralos incrementalmente para probar térmicas, ruido y márgenes netos.
Paso a paso: Fundadores usan ShareAI para inferencia elástica y de bajo costo (Ruta del comprador)
Enruta por latencia/precio/región según las preferencias de solicitud; ShareAI maneja conmutación por error and el escalado multinodo.
Deja de pagar por tiempo inactivo: la economía basada en uso reemplaza los alquileres de GPU 24/7.
Prueba indicaciones rápidamente en el Chat Playground: Abrir Playground
Bono: Si ya realizas entrenamiento en otro lugar, mantenlo allí. Usa ShareAI solo para inferencia, convirtiendo un costo fijo en un costo puramente variable uno.
Patrones de Arquitectura que Recomendamos
Entrenamiento/inferencia híbridos: Mantén el entrenamiento en tu nube preferida/en las instalaciones; descarga la inferencia a ShareAI para absorber el tráfico volátil de usuarios.
Modo ráfaga: Mantén tu servicio principal al mínimo; desvía el exceso a ShareAI durante lanzamientos y picos de marketing.
A/B o “ruleta de modelos”: Dirige una porción del tráfico a través de múltiples modelos abiertos para optimizar costo/calidad sin desplegar nuevas flotas.
Estudio de Caso (Proveedor): De Jugador Nocturno → “Tiempo Muerto” Pagado”
Perfil: • 1× RTX 3080 (10 GB VRAM) en una PC doméstica. • Juegos del propietario 19:00–22:00 y está desconectado algunos fines de semana.
Configuración: • Agente del proveedor instalado; nodo configurado en línea 08:00–18:00 y 22:30–01:00 (ventanas entre semana). • Suscrito a texto 7B/13B colas; trabajos ocasionales de visión que encajen.
Resultado (ilustrativo): • El nodo atendió una demanda constante durante el día entre semana más ráfagas nocturnas. • Las ganancias siguen tokens servidos, no horas de reloj, así que períodos cortos y intensos 1. cuenta más que largos períodos de inactividad. 2. • Después del mes 1, el proveedor ajustó las ventanas para superponerse con la 3. demanda máxima 4. y aumentó sus ingresos efectivos por hora.
5. Qué cambió: 6. • El tiempo muerto de la GPU 7. se convirtió en 8. tiempo pagado 9. • El uso de electricidad aumentó modestamente durante las ventanas activas, pero el neto fue positivo porque. 10. el cómputo utilizado paga 11. mientras que la inactividad no. 12. Estudio de Caso (Fundador): Reducción de Factura de Inferencia al Alinear Costos con el Uso.
13. Antes:
14. • 2× instancias A100 estacionadas 24/7 para evitar arranques en frío para una función generativa. • 2× instancias A100 estacionadas 24/7 para evitar arranques en frío para una función generativa. • Promedio utilización <40%; la factura no importaba—las instancias se ejecutaron de todos modos.
Después (ShareAI): • Cambiado a pago por token inferencia a través de ShareAI. • Mantuvo un pequeño endpoint interno para trabajos por lotes; solicitudes intermitentes e interactivas fueron al grid. • Enrutamiento conmutación por error and multinodo incorporado mantuvo SLA.
Resultado: • Costo mensual de inferencia seguimiento del uso, no tiempo, mejorando márgenes brutos y liberando al equipo de la planificación constante de capacidad de GPU.
Análisis Económico Detallado: Cuando Monetizar Supera al Alojamiento DIY
Por qué las aplicaciones pequeñas son aplastadas por la subutilización
Ejecutar tu propia GPU para una carga ligera a menudo significa pagar por horas inactivas. Los grandes proveedores de API ganan a través de agrupamiento masivo; ShareAI da a las aplicaciones más pequeñas una eficiencia similar al agrupar el tráfico de muchos compradores en nodos compartidos.
Intuición de punto de equilibrio (ilustrativo)
Carga ligera: Normalmente ahorrarás con pago por token frente a alquilar una GPU completa 24/7.
Carga media: Mezcla y combina: fija una pequeña base, el resto en ráfagas.
Carga pesada: La capacidad dedicada puede tener sentido; muchos equipos aún mantienen ShareAI para desbordamiento or regional cobertura.
Sensibilidades que importan
Niveles de VRAM: Una VRAM más grande desbloquea modelos más grandes (trabajos con mayor rendimiento de tokens).
Ancho de banda y localidad: Cerca de la demanda = menor latencia, más volumen para tu nodo.
Elección de modelo: Los modelos más pequeños y eficientes (cuantificados/optimizados) a menudo producen más tokens por vatio—bueno para ambas partes.
Confianza, Calidad y Control
Aislamiento: Los trabajos se despachan a través del runtime de ShareAI; los pesos del modelo y el manejo de datos siguen los controles de aislamiento de la red.
Tolerancia a fallos por diseño: Si un proveedor se desconecta a mitad de transmisión, otro nodo completa el trabajo—los fundadores no persiguen incidentes, los proveedores no son penalizados por eventos normales de la vida.
Informes transparentes: Los proveedores ven sesiones, tokens, ganancias; los fundadores ven solicitudes, tokens, gastos.
Actualizaciones: Nuevas variantes de modelos optimizados aparecen en el mercado sin necesidad de reconstruir tu flota.
¿Puedo jugar y proporcionar al mismo tiempo? Puedes, pero recomendamos cambiar tu nodo a modo offline durante un uso local intensivo para evitar conflictos y limitaciones.
¿Qué pasa si mi máquina se desconecta a mitad del trabajo? La red cambia automáticamente a otro nodo; simplemente dejas de ganar durante esa sesión.
¿Necesito una red de nivel empresarial? No. Una conexión estable de consumidor funciona. Menor fluctuación y mayor subida ayudan sensible a la latencia colas.
¿Qué modelos caben en 8/12/16/24 GB de VRAM? Como regla general: modelos de texto de 7B en 8–12 GB, 13B a menudo prefiere ≥16 GB, y los modelos más grandes/de visión se benefician de 24 GB+.
¿Cómo y cuándo se programan los pagos? Los pagos se basan en tokens servidos. Configura los detalles de tu pago en la Consola; consulta la Guía del Proveedor para detalles específicos sobre la cadencia.
Conclusión: Infraestructura de IA impulsada por personas — Deja de desperdiciar tiempo muerto, comienza a ganar
Monetizar GPU 7. se convirtió en solía ser difícil: o alquilabas todo un equipo o construías una mini-nube. ShareAI lo hace tan simple como presionar un botón: ejecuta el agente cuando estés libre, gana con el uso real, y deja que la demanda global te encuentre. Para los fundadores, es la misma historia al revés: solo paga cuando los usuarios generan tokens, no por GPUs inactivas esperando.
Proveedores: Convierte horas inactivas en ingresos — comienza con el Guía del proveedor.
Fundadores: Envíe inferencia elástica rápidamente — comienza en el Área de pruebas, luego conecta el API.
Alquile GPU para Entrenamiento e Inferencia de IA: Tendencias del Mercado 2025 y la Revolución Descentralizada
Actualizado septiembre 2026
En 2025 el mercado para alquilar GPU para IA pasó de escasez a excedente. Los precios se desinflaron, la capacidad explotó y las redes descentralizadas comenzaron a agregar GPUs inactivas de miles de propietarios. Este estudio de caso destila qué cambió, por qué es importante para startups y proveedores, y cómo ShareAI convierte el “tiempo muerto” en GPUs y servidores en ingresos, mientras ofrece a los equipos de IA computación más barata y elástica tanto para entrenamiento como para inferencia.
Por qué los equipos alquilan GPU para IA en 2025
La inferencia a escala es la nueva normalidad. Las aplicaciones GenAI ahora atienden millones de solicitudes; las horas de GPU están cambiando de ráfagas de entrenamiento a inferencia siempre activa.
La capacidad es abundante pero fragmentada. Los hyperscalers, nubes especializadas, mercados comunitarios y redes descentralizadas compiten—excelente para los compradores, complejo de navegar.
El costo y la utilización dominan los resultados. Cuando los modelos son críticos para el producto, reducir entre un 50–80% el costo de GPU o aumentar la utilización en 20–40 puntos cambia las matemáticas del negocio de la noche a la mañana.
Punto clave: Los ganadores en 2025 no son aquellos que simplemente alquilan más GPUs; son los que usa usan mejor las GPUs—aprovechando el tiempo inactivo, ubicando cargas de trabajo cerca de los usuarios y evitando primas de bloqueo. Explora el panorama de modelos de ShareAI para planificar tu mezcla: Explorar Modelos o prueba rápidamente en el Área de pruebas.
La brecha de utilización que se esconde dentro de cada clúster de GPU
Incluso en entornos bien financiados, las GPUs a menudo están inactivo esperando la preparación de datos, el almacenamiento I/O, la orquestación o la programación de trabajos. Los síntomas típicos incluyen cargadores de datos que dejan a las GPUs sin uso, ciclos de entrenamiento intermitentes que dejan las máquinas inactivas durante horas o días, y la inferencia que no siempre necesita GPUs de entrenamiento de primera categoría—dejando tarjetas costosas infrautilizadas.
Si tú alquilar GPU para IA de la manera antigua (clusters estáticos, un solo proveedor, regiones fijas), pagas por este tiempo inactivo—lo uses o no.
Qué cambió: deflación de precios + un gráfico de suministro más amplio
Deflación: Las tarifas bajo demanda para GPUs insignia cayeron a dígitos bajos (USD/hora) en muchas plataformas; los especialistas y los grupos comunitarios a menudo superan a las grandes nubes.
Elección: Más de 100 proveedores viables más redes descentralizadas que agregan operadores individuales, laboratorios de investigación y sitios periféricos.
Elasticidad: La capacidad ahora puede reunirse en poco tiempo—si tu programador y red pueden encontrarla.
Efecto neto: los compradores obtienen ventaja—pero solo si pueden dirigir las cargas de trabajo a la capacidad más adecuada en tiempo real. Para una introducción técnica más profunda, consulta nuestro Documentación and Lanzamientos.
Presentamos ShareAI: convierte el tiempo muerto en valor (para ambos lados)
Para propietarios y proveedores de GPUs
Monetiza ventanas inactivas. Si tus GPUs H100/A100/de consumidor no están reservadas en 100%, ShareAI te permite vender los espacios—de minutos a meses—sin comprometer máquinas enteras a tiempo completo.
Mantén el control total. Tú eliges los precios mínimos, ventanas de disponibilidad y qué cargas de trabajo se ejecutan.
Recibe pagos por lo que ya posees. Has invertido capital en equipos; ShareAI convierte el “tiempo muerto” en ingresos predecibles en lugar de depreciación.
Datos del proveedor: instaladores para Windows/Ubuntu/macOS/Docker; programación amigable con tiempo inactivo; recompensas transparentes por tiempo activo, confiabilidad y rendimiento; exposición preferencial a medida que aumenta la confiabilidad.
¿Listo para configurar? Comienza con el Guía del proveedor. También puedes ajustar Iniciar sesión o Registrarse para acceder a configuraciones de proveedor como Recompensas, Intercambio y políticas de región.
Para equipos de IA (startups, MLEs, investigadores)
Menor costo efectivo $/token y $/step. La colocación dinámica mueve trabajos no urgentes o interrumpibles a nodos de menor costo; la inferencia sensible a la latencia se dirige más cerca de los usuarios finales.
Híbrido por defecto. Mantén la capacidad “imprescindible” donde la necesites; el desbordamiento y los experimentos se trasladan al pool descentralizado de ShareAI.
Menos dependencia de proveedores. Combina y mezcla proveedores sin reescribir tu stack.
Mejor utilización en el mundo real. Nuestra orquestación apunta a una alta ocupación de GPU (menos interrupciones por E/S o programación), por lo que las horas que compras hacen más trabajo.
Cómo ShareAI captura tiempo inactivo de GPU (bajo el capó)
Incorporación de suministro: Los proveedores conectan nodos mediante agentes ligeros (compatibles con Kubernetes y Docker). Los nodos anuncian capacidades, políticas y ubicación para el enrutamiento consciente de la latencia.
Modelado de demanda: Las cargas de trabajo llegan con SLAs (latencia, techo de precio, fiabilidad). El emparejador ensambla el micro-pool adecuado por trabajo.
Señales económicas: Subasta inversa + ponderación de fiabilidad significa que se eligen primero los nodos más baratos y fiables; los proveedores ven retroalimentación inmediata en la tasa de llenado y las ganancias.
Maximización de utilización: Rellenando pequeños huecos; colocación consciente de datos para evitar el estancamiento de GPU; carriles de preempción para tareas interrumpibles.
Pruebas y telemetría: Las atestaciones y la telemetría continua verifican la finalización del trabajo, el tiempo de actividad y la integridad del hardware, construyendo confianza sin guardianes centrales.
Resultado: Los propietarios de GPU ganan durante intervalos que de otro modo serían improductivos; los arrendatarios obtienen computación significativamente más barata sin sacrificar la calidad del resultado.
Cuándo alquilar GPU para IA a través de ShareAI (lista de verificación de decisiones)
Necesitas inferencia más barata sin comprometer el SLA.
Experimentas falta de stock en tu proveedor principal.
Tus trabajos son intermitentes o interrumpibles (LLMs ajustados, inferencia por lotes, evaluación, barridos de hiperparámetros).
Tienes objetivos de latencia regional (AR/VR, UX en tiempo real).
Tus datos ya están fragmentados o almacenables en caché cerca de sitios periféricos.
Quédate con tu nube principal para límites de cumplimiento estrictos que requieran regiones/certificaciones específicas, o datos profundamente estatales y ultra-sensibles que no puedan salir de un enclave estrecho. La mayoría de los equipos ejecutan un híbrido: núcleo en primario → elástico/interrumpible en ShareAI. Vea nuestro Documentación para políticas de enrutamiento y mejores prácticas.
Economía del proveedor: por qué el “tiempo muerto” paga
Llena micro-huecos entre reservas con trabajos cortos.
Precios dinámicos aumentan tarifas en ventanas pico y mantienen el equipo generando ingresos en horas valle.
Reputación → ingresos: Puntuaciones de mayor fiabilidad hacen que sus nodos aparezcan antes en las coincidencias.
Sin compromisos monolíticos: Ofrezca solo las ventanas que desee; mantenga a sus clientes principales y aún monetice el resto.
Para muchos operadores, esto cambia el ROI de “larga lucha para alcanzar el punto de equilibrio” a rendimiento mensual constante—sin añadir personal de ventas o contratos. Revise el Guía del proveedor y ajuste Autenticación configuraciones para Recompensas/Intercambio para comenzar a ganar en tiempo inactivo.
Trae tus contenedores: Usa imágenes estándar de Docker/K8s; ShareAI admite frameworks y controladores populares.
Estrategia de datos: Pre-etapa de conjuntos de datos o habilita el calentamiento de caché para mantener las GPUs alimentadas.
Observa e itera: Observa la utilización, latencia p95, $/token; ajusta políticas a medida que crezca la confianza.
Para proveedores (propietarios de GPU)
Instala el agente en hosts o nodos de K8s; publica tu calendario y políticas.
Establece pisos y alertas: Precio mínimo, cargas de trabajo permitidas, límites térmicos/energéticos.
Refuerza el borde: Aísla trabajos con contenedores/VMs; habilita volúmenes cifrados; rota credenciales.
Persigue la insignia: Mejora el tiempo de actividad y el rendimiento → desbloquea colas de mayor valor.
Compón el rendimiento: Invierte ganancias en más nodos o actualizaciones.
Seguridad y confianza (notas rápidas)
Aislamiento en tiempo de ejecución a través de contenedores/VMs y sandboxes por trabajo.
Controles de datos: Almacenamiento cifrado, limpieza de memoria, políticas de no persistencia.
Atestaciones: Huellas digitales de hardware/controladores más prueba de ejecución basada en telemetría; pruebas criptográficas opcionales para flujos sensibles.
Gobernanza: Reglas transparentes para actualizaciones y penalizaciones en caso de fraude o violaciones de políticas.
Lente de ROI: cómo se ve lo “bueno”.
Capacitación: Menos pausas inactivas y mejores tokens/seg o imágenes/seg con el mismo gasto, o el mismo rendimiento por menos.
Inferencia: Menor latencia p95 con grupos regionales, y ahorros del 30–70% cuando los niveles bronce/plata absorben tráfico no urgente.
Proveedores: Rendimiento significativo en ventanas inactivas, con ventanas pico a precio de mercado y ventanas fuera de pico aún generando ingresos.
El camino por delante
El arco 2025–2030 favorece híbrido + descentralizado: nubes centralizadas para la base y el cumplimiento; ShareAI para computación elástica, eficiente en precio y consciente del borde. A medida que más propietarios incorporan GPUs y más equipos de IA adoptan prácticas centradas en la utilización, el mercado pasa de “quién tiene GPUs” a “quién usa mejor las GPUs”.” Ahí es donde vive ShareAI. Mantente atento a nuestro Lanzamientos para actualizaciones y mejoras a medida que ampliamos la capacidad y las funciones.
Preguntas frecuentes, respondidas brevemente
¿Es esto solo para H100/A100? No. Emparejamos según la carga de trabajo. Muchos trabajos de inferencia funcionan muy bien en GPUs de nivel inferior; los picos de entrenamiento pueden solicitar silicio premium.
¿Qué pasa si un trabajo es interrumpido? Puedes prohibir la interrupción o marcar trabajos como interrumpibles; los precios se ajustan en consecuencia.
¿Puedo mantener los datos en la región (por ejemplo, UE)? Sí: establece requisitos de región y residencia en tus políticas; ShareAI solo se dirigirá a nodos compatibles.
Soy un proveedor con ventanas pequeñas (por ejemplo, noches/fines de semana). ¿Vale la pena? Sí. Esos tiempos muertos son franjas ideales para inferencia por lotes y evaluación; ShareAI los llena y te paga. Comienza con el Guía del proveedor and Iniciar sesión o Registrarse.
Tema de color: {theme}ClaroOscuroSistemaArtículos relacionados: {count}Copiado {identifier}Eliminar filtro {label}Sin servidorAccesoProveedoresCreadoresEntrenamientoRetenciónSedeClúster de GPU / Centro de datosPolíticasAcceso · RecomendadoCréditosUsa créditos de ShareAI para apoyar a los propietarios de GPU a cambio de la potencia de cómputo que no están utilizando.Tus créditos recompensan a las personas y empresas que comparten capacidad de cómputo inactiva. Recomendamos esta opción para fomentar un uso más sostenible del hardware existente.ShareAI combina salvaguardas técnicas con acuerdos de proveedores para ayudar a proteger tus datos.Intercambio de tokensLos proveedores de ShareAI pueden realizar inferencias para otros y ganar tokens de entrada y salida por el trabajo que contribuyen. Luego pueden usar esos tokens para sus propias inferencias cuando lo necesiten.Al igual que los prosumidores de energía que producen y consumen electricidad, puedes convertirte en un AI Prosumer: contribuye con capacidad de cómputo cuando esté inactiva y utiliza la red cuando lo necesites.Dato curiosoEn marzo de 2025, ShareAI se convirtió en la primera plataforma del mundo para AI prosumers. Compensa tu propio uso de IA mediante el intercambio de tokens o gana pagos al final del mes a través de contribuciones remuneradas.ComunidadLos proveedores comunitarios son individuos que comparten su poder de cómputo a cambio de créditos o tokens mediante el intercambio de tokens.Ponen a trabajar recursos de cómputo que de otro modo estarían sin usar para otros en toda la red de ShareAI.ShareAI toma medidas para proteger tus datos, y cada proveedor, ya sea Comunitario o Empresarial, firma un acuerdo. Para cargas de trabajo sensibles, recomendamos proveedores Empresariales.EmpresaCada proveedor Empresarial firma un acuerdo riguroso. Las salvaguardas de ShareAI van más allá del código, abarcando la responsabilidad y reputación de la empresa.Revisamos dónde tiene su sede la empresa, quién la formó y su estructura de propiedad para entender quiénes son los beneficiarios finales detrás de ella.Región y tus datos personalesLas reglas sobre datos personales varían entre países y regiones. Un proveedor puede estar sujeto a las leyes del país donde está establecido, incluso si sus centros de datos están en otro lugar.Alojar datos en otra región no elimina automáticamente esas obligaciones. Las reglas del lugar donde se procesan los datos y las protecciones que se aplican a ti también pueden ser relevantes.Verifica la entidad legal del proveedor, las ubicaciones de procesamiento y la política de privacidad antes de compartir datos personales.Cerrar información de regiónCerrar explicaciónBuscando…Explorar documentaciónNo se encontraron artículos. Intenta con otra búsqueda o consulta la base de conocimientos.La búsqueda no está disponible. Por favor, inténtalo de nuevo.¡Copiado!Página copiada.Error al copiarError al copiar. Selecciona el texto de la página para copiarlo manualmente.Copiar páginaEnlace de la página copiado.No se pudo copiar el enlace. Cópialo desde la barra de direcciones.Preparando Markdown…No se pudo copiar. Inténtalo de nuevo o abre Ver como Markdown.Copiar identificadorCopiadoCopiar identificador del modeloCopiar del proveedorCopiar prefijoError al copiar. Selecciona el prefijo para copiarlo manualmente.Identificador del modelo copiadoCopiado {prefix}. Añade el identificador del modelo después de la barra.No se pudo copiar. Selecciona este identificador: {identifier}No se pudo cargar la verificación. Por favor, inténtalo de nuevo o abre un ticket desde tu cuenta de ShareAI.No se pudo cargar la verificación. Por favor, inténtalo de nuevo.Por favor, completa la verificación antes de enviar tu mensaje.Tu mensaje ha sido enviado. Gracias — el equipo de ShareAI responderá por correo electrónico.No pudimos confirmar la entrega. Por favor, verifica tu conexión antes de intentarlo de nuevo.Enviando…No pudimos enviar tu mensaje. Por favor, inténtalo de nuevo.Por favor, envía este formulario desde ShareAI.Tu mensaje es demasiado largo. Por favor, mantenlo por debajo de 10,000 caracteres.Por favor, introduce una dirección de correo electrónico válida.Introduce una dirección de correo electrónico válida.Por favor, introduce un mensaje de hasta 10,000 caracteres.Por favor, acorta tu nombre o asunto.Por favor, completa la verificación.Completa la verificación.Por favor, revisa este campo.La verificación falló. Por favor, inténtalo de nuevo.Por favor, revisa tus datos e inténtalo de nuevo.No pudimos confirmar la entrega. Por favor, inténtalo de nuevo más tarde o abre un ticket de soporte.{date}: {uptime}. En línea {online}, fuera de línea {offline}, no observado {unknown}.Sin observacionesTiempo de actividad observado {percent}Tiempo de actividad {percent}Tiempo de actividad diario observado y cobertura de grabación durante {days} días. Las observaciones faltantes son lagunas, no tiempo de actividad cero. Usa las teclas de flecha o los controles de detalles diarios para explorar.Cobertura de grabaciónEn líneaFuera de líneaNo observadoTiempo de actividad observado{percent} de este período cubiertoDel tiempo registradoEsperando observacionesDesconectado durante las verificacionesAún no hay historial disponibleÚltimos {days} díasEl historial se está construyendoSin observaciones en este período{date} es el primer día registrado en esta vista.Las verificaciones registradas aparecerán aquí a medida que lleguen.Mostrando los últimos {days} días. {details}Observado en líneaObservado fuera de líneaCerrar navegaciónAbrir navegaciónUsa el formulario para enviar tu mensaje.Formulario no encontrado.Datos del formulario no compatibles.Datos del formulario no válidos.No pudimos enviar tu solicitud. Tus respuestas siguen aquí—por favor, inténtalo de nuevo.Enviando tu solicitud…Solicitud recibida.Gracias por compartir tu proyecto. Lo revisaremos y te contactaremos sobre su idoneidad y los próximos pasos.Solicita el piloto de €250Piloto de Código Abierto · €250 en créditosCopiar JSON de enrutamientoJSON de enrutamiento copiadoNo se pudo copiar. Selecciona el JSON de enrutamiento para copiarlo manualmente.Solicitud cURL copiadaCuerpo de la solicitud copiadoNo se pudo copiar. Selecciona el endpoint, los encabezados y el cuerpo para copiarlos manualmente.No se pudo copiar. Selecciona el cuerpo de la solicitud para copiarlo manualmente.