Mga Alternatibo sa BytePlus API Gateway 2026: Nangungunang 10
Na-update Setyembre 2026
Kung ikaw ay nagsusuri Mga alternatibo sa BytePlus API Gateway, ang gabay na ito ay inihahambing ang espasyo sa paraan ng paggawa ng mga tagabuo: sa pamamagitan ng pamamahala, routing at katatagan, pagmamasid, transparency sa pagpepresyo, at karanasan ng developer. Una naming inilalagay ang BytePlus sa stack, pagkatapos ay niraranggo ang nangungunang 10 alternatibo—kasama ang IbahagiAI una para sa mga team na nais ng isang API sa maraming provider, isang transparent na marketplace (presyo/latency/uptime/availability bago mag-routing), instant failover, at ekonomiyang pinapagana ng tao (70% ng gastusin ay napupunta sa mga provider na nagpapanatili ng mga modelo online).
Ano ang BytePlus API Gateway (at hindi ito)
BytePlus API Gateway ay isang API management/control layer. Dinadala mo ang iyong mga serbisyo at patakaran; nagbibigay ito ng mga tampok ng gateway tulad ng centralized credentials, rate limiting, auth, routing, at mga kontrol sa lifecycle ng API. Iyon ay imprastrakturang nakatuon sa pamamahala—kapaki-pakinabang kapag kailangan mo ng mga perimeter na patakaran at kontrol sa antas ng organisasyon.
Ito ay hindi isang transparent marketplace ng modelo. Hindi ito nakatuon sa multi-provider na AI routing na may pre-route visibility sa presyo, latency, uptime, availability, at uri ng provider, at hindi ito umiiral upang palaguin ang supply ng komunidad. Kung ang iyong pangunahing pangangailangan ay transparency bago ang ruta at agarang failover sa maraming AI providers, madalas mong ipapareha ang isang gateway sa isang aggregator tulad ng ShareAI.
Mga Aggregator vs Gateways vs Agent/Orchestration platforms
Mga Tagapagtipon ng LLM (hal., ShareAI, OpenRouter, Eden AI): Isang API sa maraming modelo/provider na may transparency bago ang ruta (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover.
AI/API Gateways (hal., BytePlus API Gateway, Kong, Portkey, Apache APISIX): Mga Patakaran/pamamahala sa gilid (mga kredensyal, quotas, guardrails) kasama ang pagmamasid. Ikaw ang magdadala ng mga provider sa likod ng mga ito.
Mga Agent/Orchestration platforms (hal., Orq, Unify): Naka-package na UX, mga tool, memorya, daloy, at mga pagsusuri. Mahusay para sa mga assistant o pinakamahusay na pagpili ng modelo; hindi mga marketplace.
Paano namin sinuri ang pinakamahusay na mga alternatibo sa BytePlus API Gateway
Lawak ng modelo at neutralidad: proprietary + bukas; madaling paglipat; minimal na muling pagsulat
Latency at katatagan: mga patakaran sa routing, timeouts/retries, agarang failover
Pamamahala at seguridad: paghawak ng key, saklaw, regional routing, guardrails
Pagmamasid: mga log/traces plus cost/latency views
Kalinawan sa pagpepresyo at TCO: ihambing tunay mga gastos bago mag-routing, hindi lang unit price
Karanasan ng developer: mga dokumento, SDKs, quickstarts; oras-sa-unang-token
Komunidad at ekonomiya: kung ang iyong gastusin ay nagpapalaki ng supply (mga insentibo para sa mga may-ari/provider ng GPU)
Nangungunang 10 BytePlus API Gateway alternatibo
#1 — ShareAI (People-Powered AI API)
Ano ito. A multi-provider API na may isang transparent na marketplace at matalinong routing. Sa isang integrasyon, mag-browse ng malaking katalogo ng mga modelo at provider, ihambing presyo, latency, oras ng operasyon, pagkakaroon, at uri ng provider, pagkatapos ay mag-route gamit ang agarang failover. Ang ekonomiya ay pinapagana ng tao: 70% ng bawat dolyar ay napupunta sa mga provider (komunidad o kumpanya) na nagpapanatili ng mga modelo online.
Bakit ito ay #1. Kung nais mo ng provider-agnostic aggregation na may transparency bago ang ruta at katatagan, ShareAI ang pinaka-direktang tugma. Panatilihin ang gateway kung kailangan mo ng mga patakaran sa buong organisasyon; idagdag ang ShareAI para sa marketplace-guided routing.
Isang API → 150+ modelo mula sa maraming provider; walang rewrites, walang lock-in
Transparent na marketplace: pumili ayon sa presyo, latency, oras ng operasyon, pagkakaroon, uri ng provider
Resilience bilang default: mga routing policy + agarang failover
Makatarungang ekonomiya: 70% ng gastusin ay napupunta sa mga provider (komunidad o kumpanya)
Para sa mga provider: kumita sa pamamagitan ng pagpapanatili ng mga modelo online. Sinuman ay maaaring maging isang ShareAI provider—Komunidad or Kumpanya. Mag-onboard sa pamamagitan ng Windows, Ubuntu, macOS, o Docker. Mag-ambag ng idle-time bursts o magpatakbo ng always-on. Piliin ang iyong insentibo: Mga Gantimpala (pera), Palitan (mga token/AI Prosumer), o Misyon (mag-donate ng % sa mga NGO). Habang lumalaki, itakda ang iyong sariling inference presyo at makakuha ng mas pabor na exposure.
Ano ito. Gateway ng enterprise: pamamahala/mga polisiya/plugin, analytics, at observability para sa AI/API traffic. Isang controller sa halip na isang marketplace.
Kailan ito pipiliin. Kung kailangan mo ng mga edge policy sa maraming serbisyo at kasalukuyang nag-iistandardize sa Kong, pagkatapos ipares sa ShareAI upang makuha ang marketplace-driven na pagpili ng provider at failover.
#3 — Portkey
Ano ito. AI gateway na nagbibigay-diin sa pagmamasid, mga guardrail, at pamamahala—sikat sa mga regulated na workload.
Kailan ito pipiliin. Malakas kung ang iyong prayoridad ay pagpapatupad ng patakaran + malalalim na bakas; idagdag ang ShareAI para sa transparency bago ang ruta at multi-provider na resiliency.
#4 — OpenRouter
Ano ito. Unified API para sa maraming modelo; mahusay para sa mabilis na eksperimento sa malawak na katalogo.
Kailan ito pipiliin. Para sa mabilis na multi-model na access; kung nais mo rin agarang failover at mga stats ng marketplace (presyo/latency/uptime/availability/provider type), layer ShareAI.
#5 — Eden AI
Ano ito. Pinagsasama-sama ang mga LLM at mas malawak na AI (vision, translation, TTS), na may fallbacks at caching.
Kailan ito pipiliin. Kung kailangan mo ng maraming AI modalities sa pamamagitan ng isang API; pagsamahin sa ShareAI para sa live na visibility ng marketplace at matatag na routing.
#6 — LiteLLM
Ano ito. Magaan na Python SDK + self-hostable proxy na nagsasalita ng OpenAI-compatible interfaces sa maraming provider.
Kailan ito pipiliin. Kung mas gusto mo DIY kontrol na may minimal na dependencies. Gamitin ang ShareAI para sa pinamamahalaang pagruruta at upang maiwasan ang pagpapatakbo ng proxy sa mga landas ng produksyon.
#7 — Unify
Ano ito. Routing na nakatuon sa kalidad at pagpili ng modelo na batay sa pagsusuri bawat prompt.
Kailan ito pipiliin. Kung “pinakamahusay na modelo bawat prompt” ang layunin; kumpletuhin gamit ang ShareAI’s katalogo + instant failover.
#8 — Orq AI
Ano ito.Orkestrasyon/pakikipagtulungan platform upang tulungan ang mga koponan na lumipat mula sa mga eksperimento patungo sa produksyon gamit ang low-code flows.
Kailan ito pipiliin. Kung gusto mo daloy at orkestrasyon ng koponan; i-route ang mga tawag sa modelo sa pamamagitan ng ShareAI para sa pagpili ng provider at failover.
#9 — Apigee (na may LLMs sa likod nito)
Ano ito. Matatag pamamahala ng API/gateway na maaari mong ilagay sa harap ng mga provider ng LLM para sa mga patakaran/susi/quota.
Kailan ito pipiliin. Kung ang iyong organisasyon ay nag-standardize sa Apigee; idagdag ang ShareAI para sa multi-provider routing at transparency ng marketplace.
#10 — Apache APISIX
Ano ito.Bukas na API gateway na may mga plugin, mga patakaran sa trapiko, at extensibility.
Kailan ito pipiliin. Kung gusto mo OSS + DIY kontrol ng gateway; pagsamahin sa ShareAI para sa provider-agnostic na pagruruta at agarang failover nang hindi mo kailangang buuin lahat ng sarili mo.
BytePlus API Gateway vs ShareAI
Kung ang iyong pangunahing pangangailangan ay isang API sa maraming provider na may transparent na pagpepresyo/latency/uptime/availability at agarang failover, pumili IbahagiAI. Kung ang iyong pangunahing pangangailangan ay pamamahala ng egress—sentralisadong kredensyal, pagpapatupad ng patakaran, at observability—ang BytePlus API Gateway ay akma sa landas na iyon. Maraming mga koponan ipinares ang mga ito: gateway para sa patakaran ng organisasyon + ShareAI para sa marketplace-guided routing.
Mabilis na paghahambing
Plataporma
Sino ang pinaglilingkuran nito
Lawak ng modelo
Pamamahala at seguridad
Pagmamasid
Pag-route / failover
Transparency ng marketplace
Programa ng provider
IbahagiAI
Mga koponan ng produkto/platform na nangangailangan ng isang API + patas na ekonomiya
150+ modelo, maraming provider
Mga susi ng API at mga kontrol sa bawat ruta
Paggamit ng console + mga istatistika ng marketplace
Matalinong pag-ruta + agarang failover
Oo (presyo, latency, uptime, availability, uri ng provider)
Oo — bukas na supply; 70% sa mga provider
BytePlus API Gateway
Mga team na nagnanais ng egress governance
BYO na mga provider
Sentralisadong mga kredensyal/patakaran
Analytics ng Gateway
Conditional routing sa pamamagitan ng mga patakaran
Hindi (tool ng imprastraktura, hindi isang marketplace)
wala/n/a
Kong AI Gateway
Mga negosyo na nangangailangan ng gateway-level na polisiya
BYO
Malalakas na edge na polisiya/plugin
Analitika
Proxy/plugin, mga retries
Hindi
wala/n/a
Portkey
Mga regulated/enterprise na koponan
Malawak
Guardrails at lalim ng pamamahala
Malalalim na bakas
Kondisyunal na pag-ruruta
Bahagya
wala/n/a
OpenRouter
Mga developer na nais ng isang susi
Malawak na katalogo
Pangunahing mga kontrol sa API
Panig-app
Mga fallback
Bahagya
wala/n/a
Eden AI
Mga team na nangangailangan ng LLM + iba pang AI
Malawak
Karaniwang mga kontrol
Nag-iiba
Mga fallback/caching
Bahagya
wala/n/a
LiteLLM
DIY/sariling-host na proxy
Marami
Mga limitasyon sa config/key
Iyong infra
Mga retries/fallback
wala/n/a
wala/n/a
Pag-isahin
Mga team na nakatuon sa kalidad
Multi-model
Karaniwang seguridad ng API
Analytics ng platform
Pinakamahusay na pagpili ng modelo
wala/n/a
wala/n/a
Orq
Mga koponan na inuuna ang orkestrasyon
Malawak na suporta
Mga kontrol ng plataporma
Analytics ng platform
Daloy ng orkestrasyon
wala/n/a
wala/n/a
Apigee
Mga Enterprise/pamamahala ng API
BYO
Mga mature na patakaran
Mga add-on
Pasadyang
wala/n/a
wala/n/a
Apache APISIX
DIY/OSS gateway
BYO
Plugins/patakaran
Tooling ng komunidad
Pasadyang
wala/n/a
wala/n/a
Pagpepresyo at TCO: ihambing ang tunay na mga gastos (hindi lamang mga unit price)
Raw $/1K token itinatago ang tunay na larawan. Ang TCO ay nagbabago sa mga pagsubok/mga alternatibo, latency (na nakakaapekto sa pag-uugali ng gumagamit at mga gastos), pagkakaiba-iba ng provider, imbakan ng observability, at mga evaluation run. Isang transparent na marketplace tumutulong sa iyo na pumili ng mga ruta na nagbabalanse ng gastos at UX.
Prototipo (~10k token/araw): I-optimize para sa oras-sa-unang-token (Playground, quickstarts).
Katamtamang sukat (~2M token/araw): Routing/failover na pinapatnubayan ng Marketplace maaaring bawasan 10–20% habang pinapabuti ang UX.
Mga trabahong may matutulis na workload: Asahan ang mas mataas na epektibong gastos sa token mula sa mga retries sa panahon ng failover; maglaan ng badyet para dito.
Gabay sa Migration: paglipat sa ShareAI
Mula sa BytePlus API Gateway
Panatilihin ang mga patakaran sa antas ng gateway kung saan sila mahusay; magdagdag IbahagiAI para sa routing ng marketplace + instant failover. Pattern: gateway auth/patakaran → IbahagiAI ruta bawat modelo → sukatin ang mga istatistika ng marketplace → higpitan ang mga patakaran.
Mula sa OpenRouter
I-map ang mga pangalan ng modelo, i-verify ang pagkakapareho ng prompt, pagkatapos ay shadow 10% ng trapiko at pagtaas 25% → 50% → 100% habang ang latency/error budgets ay nananatili. Ginagawa ng data ng marketplace ang pagpapalit ng provider na simple.
Mula sa LiteLLM
Palitan ang self-hosted proxy sa mga ruta na ayaw mong patakbuhin; panatilihin ang LiteLLM para sa dev kung nais. Ihambing overhead ng ops vs. pinamamahalaang routing mga benepisyo.
Mula sa Unify / Portkey / Orq / Kong / APISIX
Tukuyin ang mga inaasahan sa feature-parity (analytics, guardrails, orchestration, plugins). Maraming mga koponan ang nagpapatakbo ng hybrid: panatilihin ang mga espesyal na tampok kung saan sila pinakamalakas; gamitin IbahagiAI para sa transparent na pagpili ng provider at failover.
Mabilisang simula para sa developer (copy-paste)
Ang sumusunod ay gumagamit ng Tugma sa OpenAI ibabaw. Palitan YOUR_KEY gamit ang iyong ShareAI key—gumawa ng isa sa Gumawa ng API Key. Tingnan ang Sanggunian ng API para sa mga detalye.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Checklist para sa seguridad, privacy & pagsunod (vendor-agnostic)
Pangangasiwa ng key: cadence ng pag-ikot; minimal na saklaw; paghihiwalay ng kapaligiran
Pagpapanatili ng data: kung saan nakaimbak ang mga prompt/response, gaano katagal; default na redaction
PII at sensitibong nilalaman: masking; mga kontrol sa pag-access; routing na pang-rehiyon para sa lokalidad ng data
Pagmamasid: pag-log ng prompt/response; kakayahang mag-filter o mag-pseudonymize; ipalaganap subaybayan ang mga ID palagi
Pagtugon sa insidente: mga landas ng eskalasyon at mga SLA ng provider
FAQ — BytePlus API Gateway kumpara sa ibang mga kakumpitensya
BytePlus API Gateway kumpara sa ShareAI — alin para sa multi-provider routing?
IbahagiAI. Ito ay ginawa para sa transparency ng marketplace (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover sa maraming provider. Ang BytePlus API Gateway ay isang pamamahala ng egress tool (sentralisadong kredensyal/patakaran; gateway observability). Maraming team ang gumagamit ng pareho—patakaran sa gilid + ShareAI para sa routing.
BytePlus API Gateway kumpara sa OpenRouter — gateway controls o mabilis na multi-model access?
OpenRouter ginagawang mabilis ang multi-model access; BytePlus sentralisahin ang patakaran at observability. Kung nais mo rin transparency bago ang ruta at agarang failover, IbahagiAI pinagsasama ang multi-provider access sa isang tanawin ng pamilihan at matatag na routing.
BytePlus API Gateway kumpara sa Kong — dalawang gateway
Parehong gateways (policies, plugins, analytics), hindi marketplaces. Maraming teams ipares ang gateway sa ShareAI para sa transparent na multi-provider routing at failover.
BytePlus API Gateway kumpara sa Portkey — sino ang mas malakas sa guardrails?
Parehong binibigyang-diin ang governance at observability; magkaiba ang lalim at ergonomya. Kung ang pangunahing pangangailangan mo ay transparent na pagpili ng provider at failover, magdagdag ng IbahagiAI.
BytePlus API Gateway vs LiteLLM — pinamamahalaang gateway vs self-host proxy
LiteLLM isang DIY proxy na ikaw ang nagpapatakbo; BytePlus ay pinamamahalaang pamamahala/observability. Kung mas gusto mong hindi magpatakbo ng proxy at gusto ng marketplace-driven routing, piliin IbahagiAI.
BytePlus API Gateway vs Unify — pagpapatupad ng patakaran vs pinakamahusay na pagpili ng modelo
Pag-isahin nakatuon sa pagpili na nakabatay sa pagsusuri; BytePlus sa patakaran/obserbabilidad. Para sa isang API sa maraming provider na may live na stats ng marketplace, gamitin IbahagiAI.
BytePlus API Gateway vs Orq — orkestrasyon vs egress
Orq tumutulong sa pag-orkestra ng mga workflow; BytePlus namamahala sa egress na trapiko. IbahagiAI pinupunan ang alinman sa pagruruta ng pamilihan.
BytePlus API Gateway vs Apigee — malawak na pamamahala ng API vs AI-specific egress
Apigee ay mas malawak na pamamahala ng API; BytePlus ay AI-skewed egress governance (kapag ginamit sa ganitong paraan). Kung kailangan mo provider-agnostic na access na may transparency ng marketplace, gamitin IbahagiAI.
BytePlus API Gateway vs Apache APISIX — turnkey vs OSS DIY
APISIX nag-aalok ng OSS plugins/policies; BytePlus nag-aalok ng pinamamahalaang layer na may gateway integrations. Upang maiwasan ang paggawa ng custom routing ngunit makuha transparent na pagpili ng provider, magdagdag ng IbahagiAI.
Mga Alternatibo sa TensorBlock Forge 2026: Nangungunang 10
Na-update Setyembre 2026
Kung naghahanap ka ng mga alternatibo sa TensorBlock Forge, ang gabay na ito ay naghahambing ng 10 pinakamahusay na opsyon sa paraan ng isang tagabuo. Una, nililinaw namin kung ano ang TensorBlock Forge—pagkatapos ay inilalagay namin ang mga kredibleng kapalit sa mga aggregator, gateways, orchestration tools, at SDK proxies. Inilalagay namin IbahagiAI una para sa mga koponan na nais isang API sa maraming provider, transparent na data ng marketplace (presyo, latency, uptime, availability, uri ng provider) bago ang pag-route, agarang failover, at ekonomiyang pinapatakbo ng tao (70% ng gastusin ay napupunta sa mga provider).
Ang TensorBlock Forge ay nagpapakilala bilang isang pinag-isang AI API na tumutulong sa mga developer ma-access at ma-orchestrate ang mga modelo sa iba't ibang provider na may gamit ang isang secure na key, na binibigyang-diin ang intelligent na pag-route, enterprise-grade na encryption, automated na failover, at kontrol sa gastos sa real-time. Iyon ay isang control-and-routing layer para sa multi-provider LLM na paggamit—hindi isang transparent na model marketplace na maaari mong i-browse bago ka mag-route.
Mga Aggregator vs Gateways vs Orchestrators vs SDK proxies
Mga LLM aggregator (hal., ShareAI, OpenRouter, Eden AI): isang API sa maraming mga modelo/provider na may transparency bago ang ruta (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover.
Mga AI gateway (hal., Traefik AI Gateway, Kong, Apache APISIX, Apigee): patakaran/pamamahala sa gilid (mga kredensyal, mga limitasyon sa rate, mga guardrails), kasama ang observability. Ikaw ang nagdadala ng mga provider; sila ang nagpapatupad at nagmamasid.
Mga platform ng Agent/orchestration (hal., Orq, Unify): mga tagabuo ng daloy, pagsusuri ng kalidad, at pakikipagtulungan upang lumipat mula sa mga eksperimento patungo sa produksyon.
Mga proxy ng SDK (hal., LiteLLM): isang magaan na proxy/OpenAI-compatible na surface na nagma-map sa maraming provider; mahusay para sa mga DIYers at self-hosting.
Kung saan ang Forge ay angkop: “Unified API with routing & control” ay sumasaklaw sa mga bahagi ng aggregator at gateway na mga kategorya, ngunit ito ay hindi isang transparent, neutral marketplace na naglalantad ng live presyo/latency/uptime/availability bago ka mag-route ng traffic.
Paano namin sinuri ang pinakamahusay na mga alternatibo sa TensorBlock Forge
Lawak ng modelo at neutralidad — proprietary + open models; madaling paglipat nang walang rewrites.
Latency at katatagan — mga patakaran sa pag-ruruta, mga timeout, mga retries, agarang failover.
Pamamahala at seguridad — paghawak ng key, mga saklaw, regional routing.
Pagmamasid — mga log/traces at mga dashboard ng gastos/latency.
Kalinawan sa pagpepresyo at TCO — ihambing tunay mga gastos bago ka mag-ruta.
Karanasan ng developer — malinaw na dokumentasyon, SDKs, quickstarts; oras-sa-unang-token.
Komunidad at ekonomiya — kung ang iyong gastusin ay nagpapalago ng supply (mga insentibo para sa mga may-ari ng GPU at mga kumpanya).
Nangungunang 10 alternatibo sa TensorBlock Forge
#1 — ShareAI (People-Powered AI API)
Ano ito. A multi-provider API na may isang transparent na marketplace at matalinong routing. Sa isang integrasyon, maaari mong i-browse ang malawak na katalogo ng mga modelo at provider, magkumpara presyo, latency, uptime, availability, uri ng provider, at mag-route gamit ang agarang failover. Ang ekonomiya ay pinapagana ng tao: 70% ng bawat dolyar dumadaloy sa mga provider (komunidad o kumpanya) na nagpapanatili ng mga modelo online.
Bakit ito ang #1 dito. Kung nais mo ng provider-agnostic aggregation na may transparency bago ang ruta at resilience, ang ShareAI ang pinaka-direktang akma. Panatilihin ang gateway kung kailangan mo ng mga patakaran sa buong organisasyon; idagdag ang ShareAI para sa marketplace-guided routing.
Isang API → malaking katalogo sa maraming provider; walang rewrites, walang lock-in.
Transparent na marketplace: pumili batay sa presyo, latency, uptime, availability, uri ng provider.
Resilience bilang default: mga patakaran sa routing + agarang failover.
Makatarungang ekonomiya: 70% ng gastusin ay napupunta sa mga provider (komunidad o kumpanya).
Para sa mga provider: kumita sa pamamagitan ng pagpapanatili ng mga modelo online. Mag onboard sa pamamagitan ng Windows, Ubuntu, macOS, o Docker. Mag-ambag ng idle-time bursts o magpatakbo ng always-on. Piliin ang iyong insentibo: Mga Gantimpala (pera), Palitan (mga token/AI Prosumer), o Misyon (mag-donate ng % sa mga NGO). Habang lumalaki ka, maaari mong itakda ang sarili mong inference prices at makakuha ng preferential exposure.
Ano ito. Isang unified API sa maraming modelo; mahusay para sa mabilis na eksperimento sa malawak na katalogo.
Pinakamahusay para sa. Mga developer na nais subukan ang maraming modelo nang mabilis gamit ang isang key.
Bakit isaalang-alang kumpara sa Forge. Mas malawak na iba't ibang modelo mula sa kahon; ipares sa ShareAI para sa mga istatistika ng marketplace at failover.
#3 — Portkey
Ano ito. Isang AI gateway na binibigyang-diin pagmamasid, mga guardrail, at pamamahala ng enterprise.
Pinakamahusay para sa. Mga regulated na industriya na nangangailangan ng malalim na kontrol sa polisiya.
Bakit isaalang-alang kumpara sa Forge. Kung ang pamamahala at observability ang iyong pangunahing prayoridad, nagiging kapansin-pansin ang Portkey; idagdag ang ShareAI para sa transparent na routing.
#4 — Kong AI Gateway
Ano ito. Enterprise API gateway na may mga tampok sa AI/LLM traffic—mga polisiya, plugin, analytics sa gilid.
Pinakamahusay para sa. Mga platform team na nag-iistandardisa ng egress controls.
Bakit isaalang-alang kumpara sa Forge. Malakas na pamamahala sa gilid; ipares sa ShareAI para sa marketplace-guided multi-provider selection.
#5 — Eden AI
Ano ito. Isang aggregator na sumasaklaw sa LLMs kasama ang mas malawak na AI (larawan, pagsasalin, TTS), na may fallbacks at caching.
Pinakamahusay para sa. Mga team na nangangailangan multi-modality sa isang API.
Bakit isaalang-alang kumpara sa Forge. Mas malawak na AI surface area; nananatiling mas malakas ang ShareAI sa transparency bago ang routing.
#6 — LiteLLM
Ano ito. Isang magaan na Python SDK at opsyonal na self-hosted proxy na naglalantad ng OpenAI-compatible interface sa iba't ibang provider.
Pinakamahusay para sa. Mga DIY builder na nais ng proxy sa kanilang stack.
Bakit isaalang-alang kumpara sa Forge. Pamilyar na OpenAI surface at developer-centric config; ipares sa ShareAI upang ma-offload ang managed routing at failover.
#7 — Unify
Ano ito.Nakatuon sa kalidad na pagruruta at pagsusuri upang pumili ng mas mahusay na mga modelo bawat prompt.
Pinakamahusay para sa. Mga team na naghahangad ng nasusukat na pagtaas ng kalidad (win rate) sa mga prompt.
Bakit isaalang-alang kumpara sa Forge. Kung ang “piliin ang pinakamahusay na modelo” ang layunin, ang evaluation tooling ng Unify ang pokus; idagdag ang ShareAI kapag gusto mo rin ng live marketplace stats at multi-provider reliability.
#8 — Orq
Ano ito.Orkestrasyon at kolaborasyon platform upang lumipat mula sa mga eksperimento patungo sa produksyon gamit ang low-code flows.
Pinakamahusay para sa. Mga team na gumagawa workflows/agents na sumasaklaw sa maraming tools at hakbang.
Bakit isaalang-alang kumpara sa Forge. Lumampas sa isang API layer patungo sa mga orchestrated flows; ipares sa ShareAI para sa neutral na access at failover.
#9 — Traefik AI Gateway
Ano ito. A pamamahala-una gateway—centralized credentials at policy na may OpenTelemetry-friendly observability at specialized AI middlewares (hal., content controls, caching).
Pinakamahusay para sa. Mga organisasyong nag-i-standardize ng egress governance sa ibabaw ng Traefik.
Bakit isaalang-alang kumpara sa Forge. Manipis na AI layer sa ibabaw ng isang subok na gateway; idagdag ang ShareAI upang pumili ng mga provider presyo/latency/uptime/availability at mag-route nang resiliently.
#10 — Apache APISIX
Ano ito. Isang high-performance open-source API gateway na may extensible plugins at traffic policies.
Pinakamahusay para sa. Mga team na mas gusto ang open-source DIY gateway control.
Bakit isaalang-alang kumpara sa Forge. Pinong-grained na patakaran at modelo ng plugin; idagdag ang ShareAI upang makuha ang transparency ng marketplace at multi-provider failover.
TensorBlock Forge vs ShareAI
Kung kailangan mo ng isang API sa maraming provider na may transparent na pagpepresyo/latency/uptime/availability at agarang failover, pumili IbahagiAI. Kung ang iyong pangunahing pangangailangan ay egress governance—sentralisadong kredensyal, pagpapatupad ng patakaran, at malalim na observability—ang Forge ay nagpoposisyon ng sarili nito na mas malapit sa control-layer tooling. Maraming mga koponan ang nagpapareha sa kanila: gateway/control para sa patakaran ng org + ShareAI para sa marketplace-guided routing.
Mabilis na paghahambing
Plataporma
Sino ang pinaglilingkuran nito
Lawak ng modelo
Pamamahala at seguridad
Pagmamasid
Pag-route / failover
Transparency ng marketplace
Programa ng provider
IbahagiAI
Mga koponan ng produkto/platform na naghahanap ng isang API + patas na ekonomiya
Malawak na katalogo sa maraming provider
Mga susi ng API at mga kontrol sa bawat ruta
Paggamit ng console + mga istatistika ng marketplace
Matalinong pag-ruta + agarang failover
Oo (presyo, latency, uptime, availability, uri ng provider)
Oo — bukas na supply; 70% sa mga provider
TensorBlock Forge
Mga koponan na nais ng unified API + control
BYO na mga provider
Sentralisadong paghawak ng key
Runtime analytics (nag-iiba depende sa setup)
Conditional routing, failover
Hindi (tooling layer, hindi isang marketplace)
wala/n/a
OpenRouter
Mga developer na nais ng isang key sa maraming modelo
Malawak na katalogo
Pangunahing mga kontrol sa API
Panig-app
Mga fallback
Bahagya
wala/n/a
Portkey
Mga regulated/enterprise na koponan
Malawak
Guardrails at pamamahala
Malalalim na bakas
Kondisyunal na pag-ruruta
Bahagya
wala/n/a
Kong AI Gateway
Mga negosyo na nangangailangan ng gateway policy
BYO
Malalakas na edge na polisiya/plugin
Analitika
Proxy/plugin, mga retries
Wala (infra)
wala/n/a
Eden AI
Multi-service AI (LLM + vision/TTS)
Malawak
Karaniwang mga kontrol
Nag-iiba
Mga fallback/caching
Bahagya
wala/n/a
LiteLLM
DIY/sariling-host na proxy
Maraming provider
Mga limitasyon sa config/key
Iyong infra
Mga retries/fallback
wala/n/a
wala/n/a
Pag-isahin
Mga team na nakatuon sa kalidad
Multi-model
Karaniwang seguridad ng API
Analytics ng platform
Pinakamahusay na pagpili ng modelo
wala/n/a
wala/n/a
Orq
Mga koponan na inuuna ang orkestrasyon
Malawak na suporta
Mga kontrol ng plataporma
Analytics ng platform
Daloy ng orkestrasyon
wala/n/a
wala/n/a
Traefik / APISIX
Mga negosyo / DIY
BYO
Mga patakaran
Mga add-ons/kustom
Pasadyang
wala/n/a
wala/n/a
Nais bang ihambing ang mga live na presyo at latency bago mag-routing? Magsimula sa Pamilihan ng Modelo at ipadala ang iyong unang kahilingan mula sa Palaruan.
Pagpepresyo at TCO: ihambing tunay mga gastos (hindi lang mga presyo ng yunit)
Ang hilaw na dolyar bawat 1K na token ay bihirang magbigay ng buong kuwento. Ang epektibong TCO ay nagbabago sa mga pagsubok/mga alternatibo, latency (nakakaapekto sa pag-uugali ng gumagamit), pagkakaiba-iba ng provider, imbakan ng observability, at mga evaluation run. Ang isang transparent na pamilihan ay tumutulong sa iyo na pumili ng mga ruta na balanse gastos at UX.
Prototype (~10k token/araw): I-optimize para sa oras-sa-unang-token. Gamitin ang Playground at mga quickstarts.
Mid-scale (~2M token/araw): Ang routing/failover na ginabayan ng Marketplace ay maaaring magbawas 10–20% habang pinapabuti ang UX.
Matitinik na mga gawain: Asahan ang mas mataas na epektibong gastos ng token mula sa retries sa panahon ng failover; maglaan ng badyet para dito.
Gabay sa Migration: paglipat sa ShareAI
Mula sa TensorBlock Forge
Panatilihin ang anumang mga patakaran sa control-layer kung saan sila mahusay; idagdag ang ShareAI para sa marketplace routing at instant failover. Pattern: control-layer auth/policy → ShareAI route per model → sukatin ang marketplace stats → higpitan ang mga patakaran.
Mula sa OpenRouter
I-map ang mga pangalan ng modelo, i-verify ang prompt parity, pagkatapos ay i-shadow ang 10% ng trapiko at i-ramp 25% → 50% → 100% habang ang latency/error budgets ay nananatili. Ginagawa ng data ng marketplace ang pagpapalit ng provider na simple.
Mula sa LiteLLM
Palitan ang self-hosted proxy sa mga production route na ayaw mong patakbuhin; panatilihin ang LiteLLM para sa dev kung nais. Ihambing ang overhead ng ops vs. mga benepisyo ng managed routing.
Mula sa Unify / Portkey / Orq / Kong / Traefik / APISIX
Tukuyin ang mga inaasahan sa feature-parity (analytics, guardrails, orchestration, plugins). Maraming mga koponan ang nagpapatakbo ng hybrid: panatilihin ang mga espesyal na tampok kung saan sila pinakamalakas; gamitin ang ShareAI para sa transparent na pagpili ng provider at matatag na failover.
Mabilisang simula para sa developer (copy-paste)
Ang sumusunod ay gumagamit ng Tugma sa OpenAI ibabaw. Palitan ang YOUR_KEY ng iyong ShareAI key—kumuha ng isa sa Gumawa ng API Key.
Checklist para sa seguridad, privacy & pagsunod (vendor-agnostic)
Pangangasiwa ng key — cadence ng rotation; minimal na saklaw; paghihiwalay ng kapaligiran.
Pagpapanatili ng data — kung saan nakaimbak ang mga prompt/responses, gaano katagal; mga default ng redaction.
PII at sensitibong nilalaman — masking; mga kontrol sa pag-access; regional routing para sa lokalidad ng data.
Pagmamasid — pag-log ng prompt/response; kakayahang mag-filter o mag-pseudonymize; pare-parehong pagpapalaganap ng trace IDs.
Pagtugon sa insidente — mga landas ng eskalasyon at mga SLA ng provider.
FAQ — TensorBlock Forge vs ibang mga kakumpitensya
TensorBlock Forge vs ShareAI — alin para sa multi-provider routing? Pumili IbahagiAI. Ito ay ginawa para sa transparency ng marketplace (presyo, latency, uptime, availability, uri ng provider) at matatag na routing/failover sa maraming provider. Gumamit ng gateway/control layer kapag ang pang-organisasyong polisiya/observability ang iyong pangunahing pangangailangan, at ipares ito sa ShareAI para sa transparent na pagpili ng provider.
TensorBlock Forge vs OpenRouter — mabilis na multi-model access o transparency ng marketplace? Ginagawa ng OpenRouter ang mabilis na multi-model access; ang ShareAI ay nagdadagdag transparency bago ang ruta at agarang failover. Kung nais mong pumili ng mga ruta gamit ang matibay na datos (presyo/latency/uptime/availability), nangunguna ang ShareAI.
TensorBlock Forge vs Eden AI — maraming AI services o nakatuon sa LLM routing? Sinasaklaw ng Eden AI ang LLMs pati na rin ang vision/translation/TTS. Kung pangunahing kailangan mo ang transparent na pagpili ng provider at matatag na failover para sa LLMs, mas angkop ang ShareAI.
TensorBlock Forge vs LiteLLM — self-host proxy o managed routing? Ang LiteLLM ay isang DIY proxy na ikaw ang nagpapatakbo. Ang ShareAI ay nagbibigay ng managed aggregation na may marketplace stats at instant failover—walang proxy na kailangang patakbuhin.
TensorBlock Forge vs Portkey — sino ang mas malakas sa guardrails/observability? Binibigyang-diin ng Portkey ang governance at malalim na traces. Kung nais mo rin ang transparency ng presyo/latency at matatag na multi-provider routing, idagdag ang ShareAI.
TensorBlock Forge vs Kong AI Gateway — gateway controls o marketplace? Malakas ang Kong sa polisiya/analytics gateway. Ang ShareAI ay ang marketplace/aggregation layer na pumipili ng mga provider base sa live na data at agad na nagfa-failover.
TensorBlock Forge vs Traefik AI Gateway — egress governance o routing intelligence? Nakatuon ang Traefik sa centralized credentials at observability. Ang ShareAI ay mahusay sa provider-agnostic na pagruruta transparency ng marketplace—maraming teams ang gumagamit ng pareho.
TensorBlock Forge vs Unify — quality-driven selection o marketplace routing? Nakatuon ang Unify sa evaluation-driven best-model selection. Ang ShareAI ay nagdadagdag ng marketplace stats at multi-provider reliability; nagko-komplement sila sa isa't isa.
TensorBlock Forge vs Orq — orchestration o routing? Ina-orchestrate ng Orq ang mga flow at agents; binibigyan ka ng ShareAI ng neutral na provider layer na may transparent stats at failover.
TensorBlock Forge vs Apache APISIX — open-source gateway o transparent marketplace? Ang APISIX ay nagbibigay ng DIY policies/plugins. Ang ShareAI ay nagbibigay transparency bago ang ruta at pinamamahalaang failover; ipares ang pareho kung nais mo ng mas detalyadong kontrol sa gateway na may routing na ginagabayan ng marketplace.
TensorBlock Forge vs Apigee — Pamamahala ng API vs routing na partikular sa AI? Ang Apigee ay malawak na pamamahala ng API. Para sa paggamit ng AI, ang ShareAI ay nagdadagdag ng view ng marketplace at multi-provider resilience na hindi ibinibigay ng Apigee lamang.
Pangkalahatang-ideya ng site ng TensorBlock at pagpoposisyon: tensorblock.co
Mga Alternatibo sa Google Apigee 2026: Nangungunang 10
Na-update Setyembre 2026
Kung ikaw ay nagsusuri Mga alternatibo sa Google Apigee, ang gabay na ito ay nagmamapa sa tanawin tulad ng gagawin ng isang tagabuo. Una, nililinaw namin kung ano ang Apigee ay—ang enterprise API management platform ng Google Cloud na may API proxies, isang malalim na katalogo ng polisiya (auth, quotas, transformation), analytics, at hybrid deployment—pagkatapos ay ikinumpara namin ang 10 pinakamahusay na opsyon para sa AI/LLM traffic at modernong API programs. Inilalagay namin IbahagiAI una para sa mga team na nais ng isang API sa maraming provider, isang transparent na marketplace (presyo, latency, uptime, availability, uri ng provider) bago routing, instant failover, at ekonomiyang pinapatakbo ng tao kung saan 70% ng gastusin ay dumadaloy sa mga provider. Ang Apigee ay nananatiling kaakit-akit para sa full-spectrum API management at governance; hindi ito isang provider-agnostic na modelo ng marketplace o isang multi-provider router.
Ano ang Google Apigee (at kung ano ang hindi nito)
Apigee ay ang ganap na pinamamahalaang produkto ng API management ng Google Cloud. Ipinapronta mo ang mga backend gamit ang Mga proxy ng API, mag-apply ng dose-dosenang prebuilt na mga polisiya (seguridad, rate limiting, transformation), mag-publish mga portal ng developer, suriin ang trapiko, at (opsyonal) patakbuhin sa hybrid mode na may Apigee-hosted management plane kasama ang runtime na pinapatakbo mo sa Kubernetes. Sa isang gateway ng AI konteksto, karaniwang inilalagay ng mga team ang mga LLM provider sa likod ng Apigee para sa sentralisadong mga susi, quota, at observability. Ngunit ang Apigee ay hindi isang neutral marketplace ng modelo o isang matalinong multi-provider router—ikaw ang nagdadala ng mga provider; ang Apigee ang nagbibigay ng pamamahala at analytics.
Kung gusto mo ng opisyal na primer mamaya, magsimula sa Apigee product page at “Ano ang Apigee?” na overview.
Mga Aggregator vs Gateways vs Agent/Orchestration platforms
Mga LLM aggregator (hal., ShareAI, OpenRouter, Eden AI) – Isang API sa maraming modelo/provider na may transparency bago ang ruta (presyo, latency, uptime, availability, uri ng provider) at matatag pagruruta/paglipat na naka-embed. Binibigyang-diin din ng ShareAI ang ekonomiyang pinapagana ng tao (70% sa mga provider) at ang lawak ng katalogo (150+ na modelo).
AI/API gateways (hal., Apigee, Kong, Traefik AI Gateway, Apache APISIX, NGINX, Portkey) – I-centralize ang mga kredensyal, patakaran, quota, at observability sa gilid; ikaw ang magdadala ng mga provider. Nandito ang Apigee; ito ay API-program-centric, hindi isang model marketplace.
Mga platform ng agent/orchestration (hal., Orq, Unify) – Mga naka-package na daloy, tool, evals, at pakikipagtulungan—magaling para sa mga eksperimento at production orchestration, hindi para sa provider-agnostic routing.
TL;DR: Kung kailangan mo ng pagpili ng modelo na ginagabayan ng marketplace at agarang failover, pumili ng isang aggregator. Kung kailangan mo enterprise policy, pamamahala, analytics, at mga portal, pumili ng isang tarangkahan. Maraming production teams ang nagpapareha ng pareho.
Paano namin sinuri ang pinakamahusay na mga alternatibo sa Google Apigee
Lawak ng modelo at neutralidad: proprietary + bukas; mabilis na pagpapalit; walang muling pagsulat.
Latency at katatagan: mga routing policies, timeouts/retries, agarang failover.
Pamamahala at seguridad: key handling, scopes, mga patakaran sa antas ng organisasyon, regional routing.
Obserbabilidad: mga log/traces at mga dashboard ng gastos/latency talagang gagamitin mo.
Pagiging transparent ng pagpepresyo at TCO: ihambing tunay mga gastos bago ka mag-ruta.
Karanasan ng developer: mga docs, SDKs, quickstarts; oras-sa-unang-token.
Komunidad at ekonomiya: kung ang iyong gastusin ay nagpapalago ng suplay (mga insentibo para sa mga may-ari ng GPU).
Nangungunang 10 mga alternatibo sa Google Apigee
#1 — ShareAI (People-Powered AI API)
Ano ito. A multi-provider API na may isang transparent na marketplace at matalinong routing. Sa isang integrasyon, mag-browse ng malaking katalogo ng mga modelo at provider, ihambing presyo, latency, uptime, availability, uri ng provider, at mag-route gamit ang agarang failover. Ang ekonomiya ay pinapagana ng tao: 70% ng bawat dolyar ay napupunta sa mga provider (komunidad o kumpanya) na nagpapanatili ng mga modelo online.
Bakit ito ang #1 dito. Kung gusto mo provider-agnostic aggregation na may transparency bago ang ruta at katatagan, Ang ShareAI ang pinaka-direktang tugma. Panatilihin ang Apigee kung kailangan mo ng pang-organisasyong programa ng API mga tampok (catalog ng patakaran, analytics, portals); idagdag ang ShareAI para sa routing na ginagabayan ng marketplace.
Isang API → 150+ na mga modelo sa maraming provider; walang rewrites, walang lock-in.
Transparent na marketplace: pumili batay sa presyo, latency, uptime, availability, uri ng provider.
Resilience bilang default: mga patakaran sa routing + agarang failover.
Makatarungang ekonomiya: 70% ng gastusin ay napupunta sa mga provider (komunidad o kumpanya).
Para sa mga provider: kumita sa pamamagitan ng pagpapanatili ng mga modelo online Sinuman ay maaaring maging isang ShareAI provider—Komunidad or Kumpanya. Mag-onboard sa pamamagitan ng Windows, Ubuntu, macOS, o Docker. Mag-ambag idle-time bursts o magpatakbo laging-naka-on. Piliin ang iyong insentibo: Mga Gantimpala (pera), Palitan (mga token/AI Prosumer), o Misyon (mag-donate ng % sa mga NGO). Habang lumalaki ka, maaari mong itakda ang iyong sariling mga presyo ng inference at makakuha ng mas pabor na exposure. Magsimula sa Gabay sa Provider o pamahalaan ang mga device sa pamamagitan ng Dashboard ng Provider.
#2 — Kong AI Gateway
Ano ito. Enterprise gateway para sa pamamahala, mga patakaran/plugin, analytics, at observability sa gilid. Isa itong control plane sa halip na isang marketplace.
#3 — Portkey
Ano ito. AI gateway na nagbibigay-diin sa pagmamasid, mga guardrail, at pamamahala—madalas na pinipili para sa mga regulated na workload.
#4 — OpenRouter
Ano ito. Aggregator na may malawak na katalogo ng modelo at isang pinag-isang API; mahusay para sa mabilisang eksperimento sa iba't ibang provider.
#5 — Eden AI
Ano ito. Pinagsasama-sama LLMs kasama ang mas malawak na kakayahan ng AI (vision, translation, TTS) na may fallback/caching at batching.
#6 — LiteLLM
Ano ito. Magaan na Python SDK + proxy na maaaring i-host ng sarili na gumagamit ng OpenAI-compatible interface sa maraming provider.
#7 — Unify
Ano ito.Kalidad na nakatuon sa routing at pagsusuri upang pumili ng mas mahusay na mga modelo bawat prompt.
#8 — Orq
Ano ito.Orkestrasyon/pakikipagtulungan platform na tumutulong sa mga team na lumipat mula sa eksperimento patungo sa produksyon gamit ang low-code flows.
#9 — Apache APISIX
Ano ito.Bukas na API gateway (mga plugin, kontrol sa trapiko, mga patakaran). Ikaw ang nagdadala ng mga provider; APISIX ang nagpapatupad ng gateway na pag-uugali.
#10 — NGINX
Ano ito. DIY na paraan: bumuo pagruruta, pagpapatupad ng token, at pag-cache para sa mga backend ng LLM na may mataas na pagganap na mga primitive.
Apigee vs ShareAI
Kung kailangan mo ng isang API sa maraming provider na may malinaw na presyo/latency/uptime at agarang failover, pumili IbahagiAI. Kung ang iyong pangunahing pangangailangan ay pamamahala ng enterprise API—sentralisadong kredensyal, pagpapatupad ng patakaran, analytics, hybrid/multicloud—Apigee akma sa lane na iyon. Maraming mga koponan ipinares ang mga ito: Apigee para sa patakaran ng org at mga portal ng developer, IbahagiAI para sa pagruruta na ginagabayan ng marketplace at katatagan.
Mabilisang paghahambing (sa isang tingin)
Plataporma
Sino ang pinaglilingkuran nito
Lawak ng modelo
Pamamahala at seguridad
Pagmamasid
Pag-route / failover
Transparency ng marketplace
Programa ng provider
IbahagiAI
Mga koponan ng produkto/platform na nangangailangan ng isang API + patas na ekonomiya
150+ na mga modelo, maraming mga provider
Mga susi ng API at mga kontrol sa bawat ruta
Paggamit ng console + mga istatistika ng marketplace
Matalinong pag-ruta + agarang failover
Oo (presyo, latency, uptime, availability, uri ng provider)
Oo — bukas na supply; 70% sa mga provider
Apigee
Mga enterprise na nangangailangan ng malawak na pamamahala ng API
BYO mga provider/modelo
Malakas na librarya ng patakaran (auth, quotas, transform)
Naka-built-in na analytics at monitoring
Kondisyunal na proxy flows, retries
Hindi (pamamahala ng platform, hindi isang marketplace)
wala/n/a
Ang mga lakas ng Apigee sa mga librarya ng patakaran, analytics, portals, at ang hybrid runtime ay kilalang-kilala; transparency ng multi-provider marketplace at routing live kasama ang mga aggregator tulad ng ShareAI.
Pagpepresyo at TCO: ihambing tunay mga gastos (hindi lang mga presyo ng yunit)
Raw $/1K token itinatago ang totoong larawan. TCO mga pagbabago gamit ang retries/fallbacks, latency (na nagbabago ng paggamit), pagkakaiba-iba ng provider, observability storage, at mga evaluation runs. transparent na marketplace tumutulong sa iyo na pumili ng mga ruta na nagbabalanse gastos at UX.
Prototype (~10k token/araw): I-optimize para sa oras-sa-unang-token (gamitin ang Buksan ang Playground at mga quickstarts).
Mid-scale (~2M token/araw):Pag-route na ginagabayan ng Marketplace + failover maaaring magbawas ng 10–20% habang pinapabuti ang UX.
Matitinik na mga gawain: Asahan ang mas mataas na epektibong gastos ng token mula sa retries sa panahon ng failover; badyet para dito.
Gabay sa Migration: paglipat sa ShareAI
Mula sa Apigee Panatilihin ang Apigee kung saan ito mahusay (patakaran, pamamahala, mga portal, analytics); idagdag ang ShareAI para sa marketplace routing + instant failover. Pattern: Apigee auth/policy → ShareAI ruta bawat modelo → subaybayan ang marketplace stats → higpitan ang mga patakaran.
Mula sa OpenRouter I-map ang mga pangalan ng modelo, i-verify ang prompt parity; anino 10% ng trapiko at pagtaas 25% → 50% → 100% habang ang latency/error budgets ay nananatili. Ginagawa ng data ng marketplace ang pagpapalit ng provider na simple.
Mula sa LiteLLM Palitan ang self-hosted proxy sa mga production route na ayaw mong patakbuhin; panatilihin ang LiteLLM para sa dev kung nais. Ihambing ang overhead ng ops vs. mga benepisyo ng managed routing.
Mula sa Unify / Portkey / Orq / Kong / APISIX / NGINX Tukuyin ang mga inaasahan sa feature-parity (analytics, guardrails, orchestration, plugins). Maraming mga koponan ang nagpapatakbo ng hybrid: panatilihin ang mga espesyal na tampok kung saan sila pinakamalakas; gamitin ang ShareAI para sa transparent na pagpili ng provider at failover.
Mabilisang simula para sa developer (copy-paste)
Ang sumusunod ay gumagamit ng Tugma sa OpenAI ibabaw. Palitan YOUR_KEY gamit ang iyong ShareAI key—gumawa ng isa sa Gumawa ng API Key. Tingnan ang Sanggunian ng API para sa mga detalye.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Checklist para sa seguridad, privacy & pagsunod (vendor-agnostic)
Pangangasiwa ng key: cadence ng rotation; minimal na saklaw; paghihiwalay ng kapaligiran.
Pagpapanatili ng Data: kung saan nakaimbak ang mga prompt/responses; retention window; default na redaction.
PII at sensitibong nilalaman: masking; mga kontrol sa pag-access; routing na pang-rehiyon para sa lokasyon ng data.
Obserbabilidad: pag-log ng prompt/response; kakayahang mag-filter o mag-pseudonymize; pare-parehong pagpapalaganap ng trace IDs.
Pagtugon sa insidente: mga landas ng eskalasyon at mga SLA ng provider.
FAQ — Apigee vs ibang mga kakumpitensya (kasama ang mga variant ng kakumpitensya-vs-kakumpitensya)
Apigee vs ShareAI — alin para sa multi-provider routing?
IbahagiAI. Ito ay ginawa para sa transparency ng marketplace (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover sa maraming provider. Apigee ay isang API management platform (mga patakaran, analytics, hybrid, mga portal). Maraming mga koponan ang gumagamit ng pareho.
Apigee vs OpenRouter — mabilis na multi-model access o gateway controls?
OpenRouter ginagawang mabilis ang multi-model access; Apigee sentralisahin ang patakaran at observability. Kung nais mo rin transparency bago ang ruta at agarang failover, IbahagiAI pinagsasama ang multi-provider access sa isang marketplace view at matibay na routing.
Apigee vs LiteLLM — self-host proxy o managed governance?
LiteLLM isang DIY proxy na ikaw ang nagpapatakbo; Apigee nag-aalok ng managed governance/observability para sa anumang API traffic. Kung ayaw mong magpatakbo ng proxy at gusto mo ng marketplace-driven routing, piliin IbahagiAI.
Apigee vs Portkey — sino ang mas malakas sa guardrails?
Pareho ang nagbibigay-diin sa governance/observability; ang lalim at ergonomics ay magkaiba. Kung ang pangunahing pangangailangan mo ay transparent na pagpili ng provider at failover, magdagdag ng IbahagiAI.
Apigee vs Unify — pinakamahusay na pagpili ng modelo vs pagpapatupad ng patakaran?
Pag-isahin nakatuon sa evaluation-driven model selection; Apigee sa policy at analytics. Para sa isang API sa maraming provider na may live marketplace stats, gamitin IbahagiAI.
Apigee vs Eden AI — maraming AI services o egress control?
Eden AI pinagsasama ang maraming AI services (LLM, image, TTS). Apigee pinapagitna ang policy/credentials at analytics. Para sa transparent pricing/latency sa maraming provider at agarang failover, pumili IbahagiAI.
Apigee vs Orq — orkestrasyon vs egress?
Orq tumutulong sa pag-orkestra ng mga workflow; Apigee pinamamahalaan ang egress traffic at developer portals. IbahagiAI kumplemento sa alinman gamit ang marketplace routing.
Apigee vs Kong AI Gateway — dalawang gateways
Parehong gateways (policies, plugins, analytics), hindi marketplaces. Maraming teams ipares ang gateway sa ShareAI para sa transparent na multi-provider routing at failover.
Apigee vs Apache APISIX — open-source gateway o managed platform?
APISIX ay open-source at plugin-driven; Apigee ay ganap na pinamamahalaan na may malalalim na tampok para sa enterprise (mga patakaran, analytics, hybrid). Kung kailangan mo rin ng provider-neutral na modelo ng access at matalinong routing, idagdag IbahagiAI.
Apigee vs NGINX — DIY vs turnkey
NGINX nag-aalok ng DIY na mga filter/patakaran; Apigee nag-aalok ng isang naka-package na platform layer na may analytics at mga portal. Upang maiwasan ang custom scripting at makuha pa rin transparent na pagpili ng provider, mag-layer sa IbahagiAI.
OpenRouter vs Apache APISIX (kompetitor-laban-sa-kompetitor)
Mansanas at dalandan: OpenRouter ay isang aggregator (isang API sa maraming modelo), habang APISIX ay isang tarangkahan. Para sa transparency ng marketplace + multi-provider routing, IbahagiAI higit na mahusay sa parehong pinagsasama katalogo + routing + failover—at maaari itong umupo sa likod mga gateway tulad ng APISIX kapag gusto mo ng edge policy kasama ang matalinong pagpili ng modelo.
Kong vs Portkey (kompetitor-laban-sa-kompetitor)
Parehong mga gateway na may pamamahala/observability; Kong mayroong mature na plugin ecosystem, habang Portkey binibigyang-diin ang mga AI-specific na guardrails at malalalim na bakas. Sa alinmang paraan, IbahagiAI mga suplay transparency bago ang ruta at matatag na routing lampas sa saklaw ng gateway.
Traefik AI Gateway laban sa Apigee (katunggali-laban-sa-katunggali)
Pareho silang mga gateway; Ang Traefik AI Gateway nagdadagdag ng manipis na AI layer at mga espesyal na middleware, habang Apigee ay isang komprehensibong API management suite na may hybrid, mga portal, at analytics. Maraming mga koponan ang gumagamit IbahagiAI para sa marketplace at agarang failover piraso.
LiteLLM laban sa NGINX (katunggali-laban-sa-katunggali)
LiteLLM = sariling-host na proxy; NGINX = DIY gateway primitives. Kung ayaw mong magpatakbo ng infra at kailangan pa rin provider-hindi-tiyak access na may matalinong routing, IbahagiAI ay mas simple.
Unify vs Eden AI (katunggali-laban-sa-katunggali)
Pag-isahin nakatuon sa evaluation-driven pinakamahusay na pagpili ng modelo; Eden AI sumasaklaw sa maraming uri ng serbisyo ng AI. IbahagiAI pinupunan ang alinman sa isang transparent na marketplace at agarang failover sa iba't ibang provider.
Kung saan ang ShareAI ay susunod na magkasya
Galugarin ang mga modelo: Ihambing ang pagpepresyo, latency, uptime, availability, at uri ng provider sa Mag-browse ng Mga Modelo.
Subukan ngayon: Ipadala ang iyong unang prompt sa Buksan ang Playground (hindi kinakailangan ang SDK).
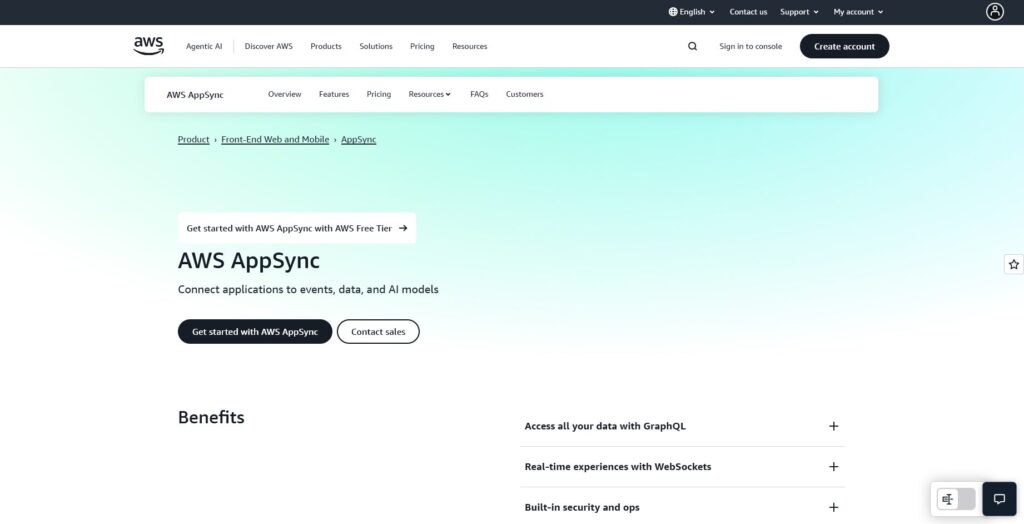
Mga Alternatibo sa AWS AppSync 2026: Nangungunang 10
Na-update Setyembre 2026
Kung ikaw ay nagsusuri Mga alternatibo sa AWS AppSync, ang gabay na ito ay nagmamapa sa tanawin sa paraan ng isang tagabuo. Una, nililinaw namin kung ano ang AppSync—isang ganap na pinamamahalaang serbisyo ng GraphQL na kumokonekta sa mga pinagmumulan ng data ng AWS (DynamoDB, Lambda, Aurora, OpenSearch, HTTP), sumusuporta sa mga real-time na subscription sa pamamagitan ng WebSockets, at madalas na ginagamit bilang isang “AI gateway” na pattern sa harap ng Amazon Bedrock—pagkatapos ay ikinukumpara namin ang 10 pinakamahusay na alternatibo. Inilalagay namin IbahagiAI una para sa mga koponan na nais isang API sa maraming provider, isang transparent na marketplace na may presyo/latency/uptime/availability bago ang pag-ruta, agarang failover, at ekonomiya na pinapagana ng tao (70% ng gastos ay napupunta sa mga provider).
Ano ang AWS AppSync (at hindi ito)
Ano ang AppSync. Ang AppSync ay ang pinamamahalaang layer ng GraphQL ng AWS: ini-parse nito ang mga query at mutation, nireresolba ang mga field laban sa mga naka-configure na pinagmumulan ng data (DynamoDB, Lambda, Aurora, OpenSearch, HTTP), at maaaring mag-push ng mga update sa real-time gamit ang GraphQL subscription sa pamamagitan ng secure na WebSockets. Nag-aalok din ito ng mga JavaScript resolver kaya maaari kang gumawa ng resolver logic gamit ang pamilyar na JS. Sa mga AI app, maraming team ang nasa harap Amazon Bedrock gamit ang AppSync—pinangangasiwaan ang auth at throttling sa GraphQL habang ini-stream ang mga token sa mga kliyente sa pamamagitan ng subscriptions.
Ano ang hindi AppSync. Ito ay hindi isang model marketplace at hindi nito pinagsasama ang access sa maraming third-party AI providers sa ilalim ng isang API. Ikaw ang nagdadala ng AWS services (at Bedrock). Para sa multi-provider routing (pre-route transparency; failover sa mga provider), ipares o palitan gamit ang isang aggregator tulad ng ShareAI.
Bakit naririnig mo ang “AI gateway para sa Bedrock.” Ang GraphQL + WebSockets + resolvers ng AppSync ay ginagawa itong natural na egress/governance layer sa harap ng Bedrock para sa parehong synchronous at streaming workloads. Pinapanatili mo ang GraphQL bilang iyong client contract habang ginagamit ang Bedrock sa iyong resolvers o functions.
Mga Aggregator vs Gateways vs Agent platforms
Mga tagapagtipon ng LLM (ShareAI, OpenRouter, Eden AI, LiteLLM): isang API sa maraming modelo/provider na may transparency bago ang ruta (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover.
Mga AI gateway (Kong AI Gateway, Portkey, AppSync-as-gateway, Apigee/NGINX/APISIX/Tyk/Azure APIM/Gravitee): pamamahala sa gilid (keys, quotas, guardrails), pagmamasid, at patakaran — ikaw ang nagdadala ng mga provider.
Mga plataporma ng ahente/chatbot (Unify, Orq): naka-package na pagsusuri, tools, memory, channels—nakatuon sa app logic kaysa sa provider-agnostic aggregation.
Sa praktika, maraming mga koponan ang nagpapatakbo pareho: isang gateway para sa org policy + IbahagiAI para sa pagruruta na ginagabayan ng marketplace at katatagan.
Paano namin sinuri ang pinakamahusay na mga alternatibo sa AppSync
Lawak ng modelo at neutralidad: proprietary + bukas; madaling paglipat; walang muling pagsusulat.
Latency at katatagan: mga patakaran sa pag-ruta, mga timeout, mga pagsubok muli, agarang failover.
Pamamahala at seguridad: paghawak ng key, saklaw, regional routing.
Pagmamasid: mga log/traces at mga dashboard ng gastos/latency.
Kalinawan sa pagpepresyo at TCO: ihambing tunay mga gastos bago ka mag-ruta.
Karanasan ng developer: mga docs, SDKs, quickstarts; oras-sa-unang-token.
Komunidad at ekonomiya: kung ang iyong paggastos ay nagpapalago ng suplay (mga insentibo para sa mga may-ari/tagapagbigay ng GPU).
Nangungunang 10 alternatibo sa AWS AppSync
#1 — ShareAI (People-Powered AI API)
Ano ito. A multi-provider API na may isang transparent na marketplace at matalinong routing. Sa isang integrasyon, mag-browse ng malaking katalogo ng mga modelo at tagapagbigay; ihambing presyo, latency, uptime, availability, uri ng provider; at mag-ruta gamit ang agarang failover. Ang ekonomiya ay pinapagana ng tao: 70% ng bawat dolyar dumadaloy sa mga provider (komunidad o kumpanya) na nagpapanatili ng mga modelo online.
Bakit ito ang #1 dito. Kung gusto mo provider-agnostic aggregation na may transparency bago ang ruta at katatagan, ang ShareAI ang pinaka-direktang akma. Panatilihin ang isang gateway kung kailangan mo ng mga patakaran sa buong organisasyon; idagdag ang ShareAI para sa routing na ginagabayan ng marketplace.
Isang API → 150+ na mga modelo sa maraming provider; walang rewrites, walang lock-in.
Transparent na marketplace: pumili ayon sa presyo, latency, uptime, availability, uri ng provider.
Resilience bilang default: mga patakaran sa pag-route + instant failover.
Makatarungang ekonomiya: 70% ng gastusin ay napupunta sa mga provider (komunidad o kumpanya).
Para sa mga provider: kumita sa pamamagitan ng pagpapanatili ng mga modelo online. Sumakay sa pamamagitan ng Sino ang maaaring magbigay:; mag-ambag idle-time bursts o magpatakbo laging-naka-on. Piliin ang iyong insentibo: Mga Gantimpala (pera), Palitan (mga token/AI Prosumer), o Misyon (mag-donate ng % sa mga NGO). Habang lumalaki ka, maaari mong itakda ang mga presyo ng inference at makakuha ng mas pabor na exposure. Gabay sa Provider · Dashboard ng Provider
#2 — Kong AI Gateway
Ano ito. Enterprise AI/LLM gateway—pamamahala, mga plugin/patakaran, analytics, at observability para sa AI traffic sa gilid. Isa itong control plane sa halip na isang marketplace.
#3 — Portkey
Ano ito. AI gateway na nagbibigay-diin sa mga guardrail, pamamahala, at malalim na observability—sikat sa mga regulated na kapaligiran.
#4 — OpenRouter
Ano ito. Isang unified API sa maraming modelo; mahusay para sa mabilis na eksperimento sa malawak na katalogo.
#5 — Eden AI
Ano ito. Pinagsasama ang LLMs kasama ang mas malawak na AI (larawan, pagsasalin, TTS), na may fallbacks/caching at batching.
#6 — LiteLLM
Ano ito. Isang magaan na Python SDK + self-hostable proxy na gumagamit ng OpenAI-compatible interface sa maraming provider.
#7 — Unify
Ano ito. Routing na nakabatay sa pagsusuri at paghahambing ng modelo upang pumili ng mas mahusay na mga modelo bawat prompt.
#8 — Orq AI
Ano ito. Platform ng orkestrasyon/kolaborasyon na tumutulong sa mga team na lumipat mula sa eksperimento patungo sa produksyon gamit ang low-code flows.
#9 — Apigee (na may LLMs sa likod nito)
Ano ito. Isang mature na platform ng pamamahala ng API na maaari mong ilagay sa harap ng mga tagapagbigay ng LLM upang mag-apply ng mga patakaran, susi, at quota.
#10 — NGINX
Ano ito. Gamitin ang NGINX upang bumuo ng custom routing, token enforcement, at caching para sa LLM backends kung mas gusto mo ang DIY control.
Ito ay mga direksyunal na buod upang matulungan kang mag-shortlist. Para sa mga katalogo ng modelo, live na pagpepresyo, o mga katangian ng tagapagbigay, mag-browse sa Pamilihan ng ShareAI at ruta batay sa real-time presyo/latency/uptime/availability.
AWS AppSync vs ShareAI
Kung kailangan mo ng isang API sa maraming provider na may transparent na pagpepresyo/latency/uptime at agarang failover, pumili IbahagiAI. Kung ang iyong pangunahing pangangailangan ay pamamahala ng egress at AWS-native GraphQL na may real-time na mga subscription, ang AppSync ay akma sa landas na iyon—lalo na kapag nasa harap ng Amazon Bedrock mga workload. Maraming mga koponan ipinares ang mga ito: gateway para sa patakaran ng organisasyon + ShareAI para sa marketplace routing.
Mabilis na paghahambing
Plataporma
Sino ang pinaglilingkuran nito
Lawak ng modelo
Pamamahala at seguridad
Pagmamasid
Pag-route / failover
Transparency ng marketplace
Programa ng provider
IbahagiAI
Mga koponan ng produkto/platform na nangangailangan ng isang API + patas na ekonomiya
150+ modelo, maraming provider
Mga susi ng API at mga kontrol sa bawat ruta
Paggamit ng console + mga istatistika ng marketplace
Matalinong pag-ruta + agarang failover
Oo (presyo, latency, uptime, availability, uri ng provider)
Oo — bukas na supply; 70% sa mga provider
AWS AppSync
Mga koponan na nagnanais ng AWS-native GraphQL + real-time + Bedrock integration
BYO (Bedrock, mga serbisyo ng data ng AWS)
Sentralisadong auth/keys sa AWS
Mga pattern na CloudWatch/OTel-friendly
Conditional fan-out sa pamamagitan ng resolvers/subscriptions
Hindi (infra tool, hindi isang marketplace)
wala/n/a
Kong AI Gateway
Mga negosyo na nangangailangan ng gateway-level na polisiya
BYO
Malalakas na edge na polisiya/plugin
Analitika
Proxy/plugin, mga retries
Wala (infra)
wala/n/a
OpenRouter
Mga developer na nais ng isang susi para sa maraming modelo
Malawak na katalogo
Pangunahing mga kontrol sa API
Panig-app
Mga fallback
Bahagya
wala/n/a
(Pinaiikling talahanayan. Gamitin ang Pamilihan ng ShareAI upang ihambing nang live presyo/latency/kakayahang magamit sa iba't ibang provider.)
Pagpepresyo at TCO: ihambing tunay mga gastos (hindi lang mga presyo ng yunit)
Ang Raw $/1K tokens ay nagtatago ng realidad. Ang TCO ay nagbabago sa mga retries/fallbacks, latency (nakakaapekto sa paggamit), pagkakaiba ng provider, imbakan ng observability, at mga evaluation run. A transparent na marketplace tumutulong sa iyo na pumili ng mga ruta na nagbabalanse ng gastos at UX.
Prototype (~10k token/araw): i-optimize para sa oras-sa-unang-token (Playground, quickstarts).
Mid-scale (~2M token/araw): ang routing/failover na ginagabayan ng marketplace ay maaaring magbawas 10–20% habang pinapabuti ang UX.
Matitinik na mga gawain: asahan ang mas mataas na epektibong gastos sa token mula sa retries sa panahon ng failover; maglaan ng badyet para dito.
Mga tala sa Migration: paglilipat sa IbahagiAI
Mula sa AWS AppSync (bilang gateway para sa Bedrock): Panatilihin ang mga patakaran sa antas ng gateway kung saan sila mahusay; magdagdag IbahagiAI para sa routing ng marketplace + instant failover sa iba't ibang provider. Pattern: AppSync auth/patakaran → ShareAI per-model na ruta → sukatin ang mga istatistika ng marketplace → higpitan ang mga patakaran.
Mula sa OpenRouter: I-map ang mga pangalan ng modelo, i-verify ang pagkakapareho ng prompt; shadow 10% ng trapiko at pagtaas 25% → 50% → 100% habang ang latency/error na mga badyet ay nananatili.
Mula sa LiteLLM: Palitan ang self-hosted na proxy sa mga production routes na ayaw mong patakbuhin; panatilihin ang LiteLLM para sa dev kung nais. Ihambing ang ops overhead laban sa mga benepisyo ng managed routing.
Mula sa Unify / Portkey / Orq / Kong: Tukuyin ang mga inaasahan sa feature-parity (analytics, guardrails, orchestration, plugins). Maraming mga team ang nagpapatakbo hybrid: panatilihin ang mga specialized features kung saan sila pinakamalakas; gamitin IbahagiAI para sa transparent na pagpili ng provider at failover.
Mabilisang simula para sa developer (copy-paste)
Ang sumusunod ay gumagamit ng Tugma sa OpenAI ibabaw. Palitan YOUR_KEY ng iyong ShareAI key—kumuha ng isa sa Gumawa ng API Key. Tingnan ang Sanggunian ng API para sa mga detalye.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Mas gusto bang huwag mag-code ngayon? Buksan ang Playground at patakbuhin ang isang live na request sa loob ng ilang minuto.
Checklist para sa seguridad, privacy & pagsunod (vendor-agnostic)
Pangangasiwa ng key: cadence ng rotation; minimal na saklaw; paghihiwalay ng kapaligiran.
Pagpapanatili ng Data: kung saan naka-store ang mga prompts/responses, gaano katagal; mga default ng redaction.
PII at sensitibong nilalaman: masking; mga kontrol sa pag-access; routing na pang-rehiyon para sa lokasyon ng data.
Obserbabilidad: pag-log ng prompt/response; kakayahang mag-filter o mag-pseudonymize; pare-parehong pagpapalaganap ng trace IDs.
Pagtugon sa insidente: mga landas ng eskalasyon at mga SLA ng provider.
FAQ — AWS AppSync vs ibang mga kakumpitensya
AWS AppSync vs ShareAI — alin para sa multi-provider routing? IbahagiAI. Ito ay ginawa para sa transparency ng marketplace (presyo, latency, uptime, availability, uri ng provider) at matalinong routing/failover sa kabuuan maraming provider. Ang AppSync ay AWS-native GraphQL na may Batong-lupa mga integrasyon at subscription. Maraming mga team ang gumagamit ng pareho: AppSync para sa GraphQL/patakaran; ShareAI para sa provider-agnostic na access at resilience.
AWS AppSync vs OpenRouter — mabilis na multi-model access o GraphQL controls? OpenRouter ginagawang mabilis ang multi-model access; AppSync sentralisado ang patakaran at real-time na mga subscription ng GraphQL sa AWS. Kung nais mo rin transparency bago ang ruta at agarang failover sa iba't ibang provider, magdagdag IbahagiAI sa likod ng iyong API.
AWS AppSync vs LiteLLM — self-host proxy o managed GraphQL? LiteLLM ay isang DIY proxy/SDK; AppSync ay pinamamahalaan GraphQL na may mga subscription sa WebSocket at mga integrasyon ng data-source ng AWS. Para sa marketplace-driven pagpili ng provider at failover, mag-route sa pamamagitan ng IbahagiAI.
AWS AppSync vs Portkey — sino ang mas malakas sa guardrails? Parehong binibigyang-diin ang pamamahala; magkaiba ang ergonomiya. Kung ang pangunahing pangangailangan mo ay transparent na pagpili ng provider at failover sa iba't ibang vendor, magdagdag IbahagiAI.
AWS AppSync vs Unify — pagpili batay sa pagsusuri vs GraphQL egress? Pag-isahin nakatuon sa evaluation-driven model selection; AppSync nakatuon sa GraphQL egress + mga integrasyon ng AWS. Para sa isang API sa maraming provider na may live na stats ng marketplace, pumili IbahagiAI.
AWS AppSync vs Orq — orkestrasyon vs GraphQL? Orq nag-oorkestra ng mga daloy; AppSync ay isang GraphQL data-access layer na may real-time + Bedrock na koneksyon. Gamitin IbahagiAI para sa transparent na pagpili ng provider at failover.
AWS AppSync vs Apigee — pamamahala ng API vs AI-specific GraphQL? Apigee ay malawak na pamamahala ng API; AppSync ay ang GraphQL service ng AWS na may subscriptions at AWS service integrations. Kung nais mo ng provider-agnostic na access na may marketplace transparency, ikonekta ang IbahagiAI.
AWS AppSync vs NGINX — DIY vs turnkey? NGINX nag-aalok ng DIY filters at policies; AppSync nag-aalok ng isang managed GraphQL layer na may WebSockets/subscriptions. Upang maiwasan ang low-level plumbing at makakuha pa rin ng transparent na pagpili ng provider, i-route sa pamamagitan ng IbahagiAI.
AWS AppSync vs Kong AI Gateway — dalawang gateways Pareho silang gateways (policies, plugins, analytics), hindi marketplaces. Maraming teams ang nagpa-pair ng gateway sa IbahagiAI para sa transparent na multi-provider routing at failover.
AWS AppSync vs Apache APISIX — GraphQL vs API gateway APISIX ay isang makapangyarihang API gateway para sa policies at routing; AppSync ay managed GraphQL para sa AWS data + Bedrock. Para sa model neutrality at live na paghahambing ng presyo/latency/uptime, idagdag ang IbahagiAI.
AWS AppSync vs Tyk — policy engine vs GraphQL resolver layer Tyk sentralisado ang mga patakaran/quota/susi; AppSync sentralisado ang GraphQL at real-time na paghahatid. Para sa provider-agnostic na AI routing at instant failover, piliin IbahagiAI.
AWS AppSync vs Azure API Management — pagpili ng ulap Azure APIM ay enterprise gateway ng Microsoft; AppSync ay serbisyo ng GraphQL ng AWS. Kung nais mo rin ng multi-provider AI na may transparency sa marketplace, gamitin IbahagiAI.
AWS AppSync vs Gravitee — open-source gateway vs managed GraphQL Gravitee ay isang API gateway na may mga patakaran, analytics, at mga kaganapan; AppSync ay partikular na ginawa para sa GraphQL + realtime. Para sa visibility ng presyo/latency/uptime bago ang ruta at failover, idagdag IbahagiAI.
Kailan kumikinang ang AppSync (at kailan hindi)
Kumikinang para sa: AWS-centric na mga stack na nais GraphQL, real-time sa pamamagitan ng mga subscription, at mahigpit na Batong-lupa koneksyon — lahat sa loob ng AWS auth/IAM at CloudWatch/OTel na mga daloy.
Hindi gaanong ideal para sa:multi-provider AI routing sa iba't ibang ulap/vendor, transparent na paghahambing bago ang ruta (presyo/latency/uptime), o awtomatiko failover sa maraming provider. Iyon ang IbahagiAI’lane ni.
Paano ang mga pattern ng AppSync ay tumutugma sa Bedrock (para sa konteksto)
Maikli, sabay-sabay na mga invocation sa mga modelo ng Bedrock direkta mula sa resolvers — maganda para sa mabilis na tugon.
Pangmatagalang/pag-stream: gamitin mga subscription/WebSockets upang i-stream ang mga token nang paunti-unti sa mga kliyente; pagsamahin sa mga backend na pinapatakbo ng event kapag kinakailangan.
Paano I-monetize ang Idle Time ng GPU gamit ang ShareAI
Kung bumili ka ng makapangyarihang GPU para sa gaming, AI, o mining, malamang na naisip mo kung paano i-monetize ang GPU kapag hindi mo ito ginagamit. Karamihan ng oras, ang iyong hardware ay nagkonsumo lamang ng kuryente at bumababa ang halaga. IbahagiAI nagbibigay-daan sa iyo na i-monetize ang idle time ng GPU sa pamamagitan ng pagrenta nito para sa AI inference workloads, kaya't ikaw ay binabayaran para sa “patay na oras” na karaniwang nasasayang ng iyong mga GPU at server.
TL;DR: Bakit Gumagana ang Pag-monetize ng GPU Dead Time gamit ang ShareAI
Patay na oras ⇒ nawawalang pera. Ang mga consumer at datacenter GPU ay madalas na hindi ganap na nagagamit, lalo na sa labas ng peak hours.
Pinagsasama-sama ng ShareAI ang demand mula sa mga startup na nangangailangan ng on-demand inference at iniruruta ito sa iyong hardware.
Binabayaran ka kada token na naihatid, nang hindi kinakailangang harapin ang DevOps o magrenta ng buong makina sa mga estranghero.
Paano Ginagawang Kita ng ShareAI ang Idle GPUs (Walang Server Management)
Ang ShareAI ay nagpapatakbo ng isang desentralisadong GPU grid na tumutugma sa mga real-time na inference na trabaho sa mga magagamit na device. Nagpapatakbo ka ng magaan na provider agent; ang network ang humahawak sa model dispatch, routing, at failover. Sa halip na habulin ang mga gigs, ikaw ay simpleng online kapag gusto mo at kumikita tuwing ang iyong GPU ay nagsisilbi ng mga token.
Bayad-per-token, hindi “rent-my-rig”
Ang tradisyunal na pagrenta ay nagla-lock ng iyong kahon ng ilang oras o araw—maganda kapag abala, masama kapag walang ginagawa. Binabaliktad ito ng ShareAI: kumikita ka sa paggamit, kaya sa sandaling huminto ang demand, ang iyong gastos ay zero. Ibig sabihin nito ang “patay na oras” ay sa wakas nagbabayad.
Para sa mga tagapagtatag: nagbabayad ka kada token na nagamit (walang 24/7 na idle sa mahal na mga instance).
Para sa mga provider: ikaw mahuli ang mga pagtaas ng demand mula sa maraming mamimili na hindi mo maaabot mag-isa.
Ang Daloy ng Pera: Sino ang Nagbabayad, Sino ang Binabayaran
Isang developer ang tumatawag sa ShareAI para sa isang modelo (hal., isang Llama family text model).
Ang network ay nagre-route ng kahilingan sa isang compatible na node (ang iyong GPU).
Ang mga token ay bumabalik; ang mga bayad ay napupunta sa iyo batay sa mga token na naihatid.
Kung ang iyong node ay mawawala sa gitna ng trabaho, awtomatikong failover pinapanatili ang kasiyahan ng user habang ang iyong session ay natatapos lamang—walang manual na pagbabantay.
Dahil ang ShareAI ay pinagsasama ang demand, ang iyong GPU ay maaaring manatiling abala lamang kapag may katuturan—eksakto kung kailan mga mamimili kailangan ng throughput at ikaw ay magagamit.
Hakbang-hakbang: I-monetize ang GPU sa Ilang Minuto (Landas ng Provider)
Suriin ang hardware at VRAM 8–24 GB VRAM ay gumagana para sa maraming text models; mas maraming VRAM ang nagbubukas ng mas malalaking modelo/mga gawain sa bisyon. Ang matatag na thermals at maaasahang uplink ay nakakatulong.
I-install ang provider agent Sundin ang Provider Guide upang i-install, irehistro ang iyong device, at pumasa sa mga pangunahing pagsusuri. Mga Dokumento: Gabay sa Provider
Piliin kung ano ang iyong ihahain Mag-opt in sa mga pila na akma sa iyong VRAM (hal., 7B/13B na mga text model, magaan na vision). Mas maraming availability windows = mas maraming kita.
Mag-online at kumita Kapag hindi ka naglalaro o nagte-train nang lokal, i-toggle ang iyong node online at hayaan ang ShareAI na awtomatikong mag-route ng trabaho.
Subaybayan ang kita at uptime Gamitin ang Provider Dashboard (sa pamamagitan ng Console) upang subaybayan ang mga session, token, at payout. Console (mga key, paggamit): Gumawa ng API Key • Gabay ng Gumagamit: Pangkalahatang-ideya ng Console
Optimization Playbook para sa mga Provider
Itugma ang VRAM sa mga pila: Bigyang-priyoridad ang mga model na komportableng akma; iwasan ang edge-case OOMs na nagpapaputol ng mga session.
Planuhin ang mga availability window: Kung naglalaro ka tuwing gabi, itakda ang iyong node online sa oras ng trabaho o magdamag—kapag tumataas ang demand.
Mahalaga ang katatagan ng network: Ang wired o solid Wi-Fi ay nagpapanatili ng steady throughput at binabawasan ang failovers.
Thermals at power: Panatilihing nasa tamang temperatura; consistent na clocks = consistent na kita.
Sukatin palabas: Kung mayroon kang maraming GPUs o maliit na server, i-onboard ang mga ito nang paunti-unti upang subukan ang thermals, ingay, at net margins.
Step-by-Step: Ginagamit ng Founders ang ShareAI para sa Elastic, Low-Cost Inference (Buyer Path)
Bonus: Kung ikaw ay mayroon nang nagpapatakbo ng pagsasanay sa ibang lugar, panatilihin ito doon. Gamitin ang ShareAI para lamang sa inference, ginagawang isang nakapirming gastos sa isang purong variable isa.
Mga Pattern ng Arkitektura na Inirerekomenda Namin
Hybrid na pagsasanay/inference: Panatilihin ang pagsasanay sa iyong gustong cloud/on-prem; ilipat ang inference sa ShareAI upang masalo ang pabagu-bagong trapiko ng user.
Burst mode: Panatilihin ang iyong pangunahing serbisyo na minimal; ilipat ang overflow sa ShareAI sa panahon ng paglulunsad at pagtaas ng marketing.
A/B o “model roulette”: I-route ang bahagi ng trapiko sa iba't ibang bukas na modelo upang i-optimize ang gastos/kalidad nang hindi nagtatayo ng bagong fleets.
Pag-aaral ng Kaso (Provider): Mula sa Evening Gamer → Bayad na “Patay na Oras”
Profile: • 1× RTX 3080 (10 GB VRAM) sa isang home PC. • Naglalaro ang may-ari ng mga laro mula 19:00–22:00 at offline tuwing ilang weekend.
Setup: • Nakainstall ang provider agent; nakaset ang node online 08:00–18:00 at 22:30–01:00 (weekday windows). • Nakasubscribe sa 7B/13B na teksto queues; paminsang-minsang vision jobs na akma.
Kinalabasan (ilustratibo): • Ang node ay nagserbisyo ng tuloy-tuloy na weekday daytime demand kasama ang late-night bursts. • Ang kita ay sumusunod sa tokens na naiserbisyo, hindi sa oras ng orasan, kaya maikli, mainit na mga panahon 1. bilangin ang higit pa sa mahabang idle na mga panahon. 2. • Pagkatapos ng buwan 1, in-adjust ng provider ang mga bintana upang mag-overlap sa 3. pinakamataas na demand ng network 4. at tumaas ang kanilang epektibong oras-oras na kita.
5. Ano ang nagbago: 6. • Ang dead time ng GPU 7. ay naging 8. bayad na oras 9. • Ang paggamit ng kuryente ay bahagyang tumaas sa panahon ng on-windows, ngunit positibo ang neto dahil. 10. ang ginagamit na compute ay nagbabayad 11. habang ang idle ay hindi. 12. Pag-aaral ng Kaso (Tagapagtatag): Nabawasan ang Gastos sa Inference sa pamamagitan ng Pag-align ng Mga Gastos sa Paggamit.
13. Bago:
14. • 2× A100 na mga instance na naka-park 24/7 upang maiwasan ang malamig na pagsisimula para sa isang generative na tampok. • 2× A100 na mga instance na naka-park 24/7 upang maiwasan ang malamig na pagsisimula para sa isang generative na tampok. • Karaniwan paggamit <40%; hindi inintindi ni bill—tumakbo pa rin ang mga instance.
Pagkatapos (ShareAI): • Lumipat sa bayad-per-token inference sa pamamagitan ng ShareAI. • Pinanatili ang isang maliit na internal endpoint para sa batch jobs; pabugso-bugso, interactive na mga kahilingan ay napunta sa grid. • Naka-built-in failover at multi-node na pagruruta pinanatili ang SLA.
Resulta: • Buwanang gastos sa inference sinusubaybayan ang paggamit, hindi oras, pagpapabuti kabuuang margin at pagpapalaya sa koponan mula sa patuloy na pagpaplano ng kapasidad ng GPU.
Malalim na Pagsusuri sa Ekonomiya: Kapag Ang Pag-monetize ay Mas Mabuti Kaysa sa DIY Hosting
Bakit ang maliliit na app ay nadudurog ng hindi sapat na paggamit
Ang pagpapatakbo ng sarili mong GPU para sa magaan na trabaho ay madalas na nangangahulugan pagbabayad para sa mga oras na walang ginagawa. Ang malalaking tagapagbigay ng API ay nananalo sa pamamagitan ng napakalaking batching; Ang ShareAI ay nagbibigay sa mas maliliit na app ng katulad na kahusayan sa pamamagitan ng pagsasama-sama ng trapiko ng maraming mamimili sa mga pinagsamang node.
Intuwisyon sa break-even (pansariling halimbawa)
Magaan na pagkarga: Karaniwan kang makakatipid gamit ang pay-per-token kumpara sa pagrenta ng buong GPU 24/7.
Katamtamang load: Paghaluin at itugma—mag-pin ng maliit na baseline, i-burst ang natitira.
Mabigat na load: Ang dedikadong kapasidad ay maaaring may kabuluhan; maraming mga team ang patuloy na gumagamit ng ShareAI para sa labis or rehiyonal saklaw.
Mga sensitibong bagay na mahalaga
Mga tier ng VRAM: Mas malaking VRAM ang nagbubukas ng mas malalaking modelo (mas mataas na token-throughput na mga trabaho).
Bandwidth at locality: Malapit sa demand = mas mababang latency, mas maraming volume para sa iyong node.
Pagpili ng modelo: Mas maliliit, mas episyenteng mga modelo (na-quantize/na-optimize) ay madalas nagbibigay ng mas maraming token bawat watt—mabuti para sa parehong panig.
Tiwala, Kalidad, at Kontrol
Paghiwalay: Ang mga trabaho ay ipinapadala sa pamamagitan ng ShareAI runtime; ang mga timbang ng modelo at paghawak ng data ay sumusunod sa mga kontrol ng paghiwalay ng network.
Failover ayon sa disenyo: Kung ang isang provider ay huminto sa gitna, ibang node ang tumatapos ng trabaho—hindi hinahabol ng mga founder ang mga insidente, hindi pinaparusahan ang mga provider para sa normal na mga pangyayari sa buhay.
Transparent na pag-uulat: Nakikita ng mga provider ang mga sesyon, token, kita; nakikita ng mga founder ang mga kahilingan, token, gastos.
Mga Update: Ang mga bagong/na-optimize na variant ng modelo ay lumalabas sa marketplace nang hindi mo kailangang muling buuin ang iyong fleet.
Maaari ba akong maglaro at magbigay nang sabay? Maaari mo, ngunit inirerekomenda naming i-toggle ang iyong node offline sa panahon ng masinsinang lokal na paggamit upang maiwasan ang pag-aagawan at throttling.
Paano kung ang aking makina ay mag-offline sa gitna ng trabaho? Ang network nagfa-failover sa ibang node; titigil ka lang sa pag-earn para sa sesyon na iyon.
Kailangan ko ba ng enterprise-grade networking? Hindi. Gumagana ang isang matatag na consumer connection. Ang mas mababang jitter at mas mataas na uplink ay nakakatulong sa latency-sensitive mga pila.
Aling mga modelo ang kasya sa 8/12/16/24 GB VRAM? Bilang panuntunan: 7B text models sa 8–12 GB, 13B madalas na mas gusto ≥16 GB, at ang mas malalaki/mga vision model ay nakikinabang mula sa 24 GB+.
Paano at kailan naka-schedule ang mga payout? Ang mga payout ay nakabatay sa tokens na naiserbisyo. I-set up ang iyong mga detalye ng payout sa Console; tingnan ang Provider Guide para sa mga detalye ng cadence.
Konklusyon: People-Powered AI Infra — Itigil ang Pag-aaksaya ng Oras, Simulan ang Pagkita
Pag-monetize ng GPU 7. ay naging dati ay mahirap—kailangan mong umupa ng buong rig o magtayo ng mini-cloud. IbahagiAI ginagawa itong napakadaling pindutin ang button: patakbuhin ang agent kapag libre ka, kumita sa aktwal na paggamit, at hayaan ang pandaigdigang demand na hanapin ka. Para sa mga founder, pareho lang ang kwento sa kabaligtaran: magbayad lamang kapag ang mga user ay bumubuo ng mga token, hindi para sa mga tahimik na GPU na naghihintay lang.
Mga Provider: Gawing kita ang mga idle na oras — magsimula sa Gabay sa Provider.
Mga Tagapagtatag: Ipadala ang elastic inference nang mabilis — magsimula sa Palaruan, pagkatapos ikonekta ang API.
Magrenta ng GPU para sa AI Training & Inference: Mga Uso sa Merkado ng 2025 at ang Desentralisadong Rebolusyon
Na-update Setyembre 2026
Noong 2025 ang merkado para sa pagrenta ng GPU para sa AI ay nagbago mula sa kakulangan patungo sa labis. Bumaba ang mga presyo, sumabog ang kapasidad, at nagsimulang magtipon ang mga desentralisadong network ng mga idle na GPU mula sa libu-libong may-ari. Ang case study na ito ay naglalahad ng mga pagbabago, kung bakit ito mahalaga sa mga startup at provider, at kung paano ginagawang kita ng ShareAI ang “patay na oras” sa GPUs at servers—habang nagbibigay sa mga AI team ng mas murang, elastic na compute para sa parehong training at inference.
Bakit nirentahan ng mga team ang GPU para sa AI noong 2025
Ang inference sa malawakang saklaw ay ang bagong normal. Ang mga GenAI app ay ngayon nagseserbisyo ng milyon-milyong kahilingan; ang mga oras ng GPU ay lumilipat mula sa training bursts patungo sa palaging naka-on na inference.
Ang kapasidad ay sagana ngunit pira-piraso. Ang mga hyperscaler, espesyalistang ulap, community marketplaces, at desentralisadong network ay lahat nagkakumpitensya—maganda para sa mga mamimili, ngunit mahirap i-navigate.
Ang gastos at paggamit ang nangingibabaw sa mga resulta. Kapag ang mga modelo ay mahalaga sa produkto, ang pagbabawas ng 50–80% sa gastos ng GPU o ang pagtaas ng paggamit ng 20–40 puntos ay nagbabago ng matematika ng negosyo sa magdamag.
Pangunahing takeaway: Ang mga nanalo noong 2025 ay hindi lamang ang mga nagrenta ng mas maraming GPUs; sila ang mga gamitin mas mahusay na gumagamit ng GPUs—pinipiga ang idle time, inilalagay ang mga workload malapit sa mga user, at iniiwasan ang lock-in premiums. Tuklasin ang model landscape ng ShareAI upang planuhin ang iyong kombinasyon: Mag-browse ng Mga Modelo o subukan ang isang mabilis na pagsubok sa Palaruan.
Ang agwat ng paggamit na nakatago sa loob ng bawat GPU cluster
Kahit sa mga kapaligirang may sapat na pondo, madalas na nakatengga ang mga GPU nakatigil naghihintay sa paghahanda ng data, storage I/O, orkestrasyon, o pag-iiskedyul ng trabaho. Karaniwang sintomas ay ang mga data loader na nagugutom ang mga GPU, mga biglaang training cycle na nag-iiwan ng mga makina na tahimik nang ilang oras o araw, at inference na hindi palaging nangangailangan ng mga top-tier na training GPU—na nag-iiwan sa mga mamahaling card na hindi nagagamit nang husto.
Kung ikaw pagrenta ng GPU para sa AI Sa lumang paraan (mga static cluster, iisang vendor, nakapirming rehiyon), binabayaran mo ang idle time na ito—gamitin mo man ito o hindi.
Ano ang nagbago: pagbaba ng presyo + mas malawak na supply graph
Pagbaba ng presyo: Ang on-demand na mga rate para sa flagship GPUs ay bumaba sa mababang single digits (USD/oras) sa maraming platform; madalas na mas mababa ang singil ng mga espesyalista at community pools kaysa sa malalaking cloud.
Pagpipilian: 100+ na maaasahang provider kasama ang mga decentralized network na pinagsasama-sama ang mga indibidwal na operator, research lab, at edge site.
Elastisidad: Ang kapasidad ay maaari nang pagsama-samahin sa maikling abiso—kung ang iyong scheduler at network ay kayang hanapin ito.
Netong epekto: nagkakaroon ng leverage ang mga mamimili—ngunit kung kaya lamang nilang i-route ang mga workload sa pinaka-angkop na kapasidad sa real time. Para sa mas malalim na teknikal na primer, tingnan ang aming Dokumentasyon at Mga Paglabas.
Ipasok ang ShareAI: gawing halaga ang patay na oras (para sa parehong panig)
Para sa mga may-ari at provider ng GPU
I-monetize ang mga idle na bintana. Kung ang iyong H100/A100/consumer GPUs ay hindi 100% na naka-book, pinapayagan ka ng ShareAI na ibenta ang mga puwang—mga minuto hanggang buwan—nang hindi kinakailangang mag-commit ng buong makina nang full-time.
Panatilihin ang buong kontrol. Ikaw ang pumipili ng mga presyo, mga oras ng availability, at kung aling mga workload ang tatakbo.
Kumita mula sa kung ano ang mayroon ka na. Nag-invest ka ng kapital sa kagamitan; ginagawang ShareAI ang “dead time” sa predictable na kita sa halip na depreciation.
Mga katotohanan ng provider: mga installer para sa Windows/Ubuntu/macOS/Docker; iskedyul na friendly sa idle-time; transparent na gantimpala para sa uptime, pagiging maaasahan, at throughput; mas mataas na exposure habang tumataas ang pagiging maaasahan.
Handa nang mag-set up? Magsimula sa Gabay sa Provider. Maaari mo ring i-fine-tune Mag-sign in o Mag-sign up upang ma-access ang mga setting ng provider tulad ng Rewards, Exchange, at mga patakaran sa rehiyon.
Para sa mga AI na koponan (mga startup, MLEs, mananaliksik)
Mas mababang epektibong $/token at $/hakbang. Ang dynamic na paglalagay ay nagtutulak ng mga hindi agarang o maaaring maantala na trabaho sa mas murang mga node; ang latency-sensitive na inference ay nagruruta nang mas malapit sa mga end user.
Hybrid bilang default. Panatilihin ang “must-have” na kapasidad kung saan mo ito gusto; ang overflow at mga eksperimento ay dumadaloy sa decentralized pool ng ShareAI.
Mas kaunting vendor lock-in. Paghaluin at itugma ang mga provider nang hindi muling isinusulat ang iyong stack.
Mas mahusay na paggamit sa totoong mundo. Ang aming orkestrasyon ay nagta-target ng mataas na occupancy ng GPU (mas kaunting pagkaantala mula sa I/O o pag-iiskedyul), kaya't ang mga oras na binibili mo ay gumagawa ng mas maraming trabaho.
Paano kinukuha ng ShareAI ang idle na oras ng GPU (sa ilalim ng hood)
Pag-onboard ng supply: Ang mga provider ay kumokonekta ng mga node sa pamamagitan ng magaan na mga ahente (Kubernetes- at Docker-friendly). Ang mga node ay nag-aanunsyo ng mga kakayahan, patakaran, at lokasyon para sa latency-aware na pag-ruruta.
Paghubog ng demand: Ang mga workload ay dumating na may SLAs (latency, price ceiling, reliability). Ang matcher ay nag-aayos ng tamang micro-pool bawat trabaho.
Mga signal ng ekonomiya: Ang reverse-auction + reliability weighting ay nangangahulugang mas mura, mas maaasahang nodes ang pinipili muna; nakikita ng mga provider ang agarang feedback sa fill rate at kita.
Pag-maximize ng paggamit: Pagpuno ng maliliit na puwang; data-aware placement upang maiwasan ang GPU starvation; preemption lanes para sa mga interruptible na gawain.
Mga patunay at telemetry: Ang mga attestations at tuloy-tuloy na telemetry ay nagbe-verify ng pagkumpleto ng trabaho, uptime, at integridad ng hardware—nagbuo ng tiwala nang walang central gatekeepers.
Resulta: Kumita ang mga may-ari ng GPU sa mga hindi produktibong oras; ang mga renter ay nakakakuha ng mas murang compute nang hindi isinasakripisyo ang kalidad ng resulta.
Kailan magrenta ng GPU para sa AI gamit ang ShareAI (checklist ng desisyon)
Kailangan mo ng mas murang inference nang walang kompromiso sa SLA.
Nakakaranas ka ng out-of-stock sa iyong pangunahing provider.
Ang iyong mga trabaho ay bursty o interruptible (fine-tuned LLMs, batch inference, evaluation, hyper-param sweeps).
Mayroon kang mga target na latency sa rehiyon (AR/VR, realtime UX).
Ang iyong data ay naka-shard na o cacheable malapit sa edge sites.
Manatili sa iyong pangunahing cloud para sa mahigpit na compliance boundaries na nangangailangan ng partikular na mga rehiyon/sertipikasyon, o malalim na stateful, ultra-sensitive na data na hindi maaaring umalis sa makitid na enclave. Karamihan sa mga koponan ay nagpapatakbo ng hybrid: core sa pangunahing → elastic/interruptible sa ShareAI. Tingnan ang aming Dokumentasyon para sa mga patakaran sa routing at pinakamahusay na mga kasanayan.
Ekonomiya ng provider: bakit nagbabayad ang “patay na oras”
Pinupunan ang mga micro-gap sa pagitan ng mga booking gamit ang maiikling trabaho.
Dinamikong pagpepresyo nagpapataas ng mga rate sa mga peak window at pinapanatili ang kita ng kagamitan sa off-peak.
Reputasyon → kita: Mas mataas na mga marka ng pagiging maaasahan ang nagpapakita ng iyong mga node nang mas maaga sa mga tugma.
Walang monolitikong mga pangako: Mag-alok lamang ng mga window na gusto mo; panatilihin ang iyong pangunahing mga customer at kumita pa rin mula sa iba.
Para sa maraming operator, binabago nito ang ROI mula sa “mahabang paghihintay para mabawi” patungo sa matatag na buwanang ani—nang hindi nagdaragdag ng sales headcount o mga kontrata. Suriin ang Gabay sa Provider at ayusin Auth mga setting para sa Rewards/Exchange upang magsimulang kumita sa idle time.
Praktikal na setup (parehong panig)
Para sa mga renter (startups & MLEs)
Tukuyin ang mga tier ng SLO: “ginto” (nakareserba, mababang-latency), “pilak” (on-demand), “tanso” (interruptible/spot).
Ideklara ang mga limitasyon: max na presyo/oras, katanggap-tanggap na preemption, min VRAM, rehiyonal na affinity.
Dalhin ang iyong mga container: Gumamit ng standard na Docker/K8s images; sinusuportahan ng ShareAI ang mga sikat na framework at driver.
Estratehiya sa data: I-pre-stage ang mga dataset o paganahin ang cache warming upang mapanatiling aktibo ang GPUs.
Obserbahan at ulitin: Panoorin ang paggamit, p95 latency, $/token; higpitan ang mga patakaran habang tumataas ang kumpiyansa.
Para sa mga provider (mga may-ari ng GPU)
I-install ang agent sa mga host o K8s nodes; i-publish ang iyong kalendaryo at mga patakaran.
Itakda ang mga limitasyon at alerto: Minimum na presyo, pinapayagang mga workload, mga limitasyon sa thermal/power.
Palakasin ang edge: Ihiwalay ang mga trabaho gamit ang mga container/VMs; paganahin ang mga naka-encrypt na volume; i-rotate ang mga kredensyal.
Habulin ang badge: Pagbutihin ang uptime at throughput → i-unlock ang mas mataas na halaga ng mga queue.
Palaguin ang ani: I-roll ang kita sa mas maraming nodes o mga upgrade.
Seguridad at tiwala (mga mabilisang tala)
Paghiwalay sa runtime sa pamamagitan ng mga container/VMs at per-job sandboxes.
Mga kontrol sa data: Naka-encrypt na storage, memory scrubbing, mga patakaran sa walang-pagpupursige.
Mga patotoo: Mga fingerprint ng hardware/driver kasama ang telemetry-based na patunay ng pagpapatupad; opsyonal na cryptographic proofs para sa sensitibong mga daloy.
Pamamahala: Transparent na mga patakaran para sa mga upgrade at slashing sa kaso ng pandaraya o paglabag sa patakaran.
ROI lens: kung ano ang hitsura ng “mabuti”
Pagsasanay: Mas kaunting idle stalls at mas mahusay na tokens/sec o images/sec sa parehong gastos—o parehong throughput para sa mas mababa.
Pagpapalagay: Mas mababang p95 latency gamit ang mga regional pool, at 30–70% na pagtitipid kapag ang bronze/silver tiers ay sumisipsip ng hindi agarang trapiko.
Mga Provider: Makabuluhang ani sa idle windows, na may peak windows na naka-presyo sa merkado at off-peak windows na kumikita pa rin.
Ang daan pasulong
Ang 2025–2030 arc ay pabor sa hybrid + desentralisado: centralized clouds para sa baseline at pagsunod; ShareAI para sa elastiko, episyente sa presyo, may kamalayan sa gilid compute. Habang mas maraming may-ari ang nag-o-onboard ng GPUs at mas maraming AI teams ang nag-aampon ng utilization-first practices, ang merkado ay lumilipat mula sa “sino ang may GPUs” patungo sa “sino ang pinakamahusay na gumagamit ng GPUs.” Doon nakatira ang ShareAI. Bantayan ang aming Mga Paglabas para sa mga update at pagpapabuti habang pinalalawak namin ang kapasidad at mga tampok.
Madalas itanong, sagot nang maikli
Para lang ba ito sa H100/A100? Hindi. Tumutugma kami batay sa workload. Maraming inference jobs ang mahusay na tumatakbo sa mas mababang-tier na GPUs; ang mga training bursts ay maaaring humiling ng premium silicon.
Paano kung ang isang trabaho ay ma-preempt? Maaari mong ipagbawal ang preemption o markahan ang mga trabaho bilang interruptible; ang pagpepresyo ay ina-adjust nang naaayon.
Maaari ko bang panatilihin ang data sa rehiyon (hal., EU)? Oo—itakda ang mga kinakailangan sa rehiyon at residency sa iyong mga patakaran; ang ShareAI ay magre-route lamang sa mga node na sumusunod.
Ako ay isang provider na may maliliit na oras (hal., gabi/weekends). Sulit ba ito? Oo. Ang mga patay na oras ay pangunahing mga slot para sa batch inference at eval; pinupunan ito ng ShareAI at binabayaran ka. Simulan sa Gabay sa Provider at Mag-sign in o Mag-sign up.
Tema ng kulay: {theme}MaliwanagMadilimSistemaMga tumutugmang artikulo: {count}Nakopya {identifier}Alisin ang {label} filterWalang serverI-accessMga TagapagbigayMga TagalikhaPagsasanayRetensyonPunong tanggapanGPU Cluster / DatacenterMga patakaranAccess · InirerekomendaMga KreditoGamitin ang ShareAI credits upang suportahan ang mga may-ari ng GPU kapalit ng computing power na hindi nila ginagamit.Ang iyong mga credits ay nagbibigay gantimpala sa mga tao at kumpanya na nagbabahagi ng idle compute. Inirerekomenda namin ang opsyong ito upang suportahan ang mas sustainable na paggamit ng umiiral na hardware.Pinagsasama ng ShareAI ang mga teknikal na proteksyon at mga kasunduan sa provider upang makatulong na protektahan ang iyong data.Palitan ng TokenAng mga ShareAI provider ay maaaring magsagawa ng inference para sa iba at kumita ng input at output tokens para sa kontribusyon nilang trabaho. Maaari nilang gamitin ang mga token na ito para sa kanilang sariling inference kapag kailangan nila.Tulad ng mga energy prosumer na parehong gumagawa at gumagamit ng kuryente, maaari kang maging isang AI prosumer: mag-ambag ng compute kapag ito ay idle at gamitin ang network kapag kailangan mo ito.Nakakatuwang kaalamanNoong Marso 2025, ang ShareAI ang naging unang platform sa mundo para sa mga AI prosumer. I-offset ang iyong sariling paggamit ng AI sa pamamagitan ng token exchange, o kumita ng bayad sa katapusan ng buwan sa pamamagitan ng mga bayad na kontribusyon.KomunidadAng mga Community provider ay mga indibidwal na nagbabahagi ng kanilang computing power kapalit ng credits o tokens sa pamamagitan ng token exchange.Ginagamit nila ang compute na hindi nagagamit para sa iba sa buong ShareAI network.Gumagawa ang ShareAI ng mga hakbang upang protektahan ang iyong data, at bawat provider, Community o Company, ay pumipirma ng kasunduan. Para sa mga sensitibong workload, inirerekomenda namin ang mga Company provider.KumpanyaAng bawat Company provider ay pumipirma ng mahigpit na kasunduan. Ang mga safeguard ng ShareAI ay umaabot lampas sa code patungo sa pananagutan at reputasyon ng kumpanya.Sinusuri namin kung saan nakabase ang kumpanya, sino ang bumuo nito, at ang istruktura ng pagmamay-ari nito upang maunawaan ang mga tunay na may-ari sa likod nito.Rehiyon at ang iyong personal na datosAng mga patakaran sa personal na data ay nagkakaiba-iba sa pagitan ng mga bansa at rehiyon. Ang isang provider ay maaaring manatiling saklaw ng mga batas ng bansa kung saan ito itinatag, kahit na ang mga datacenter nito ay nasa ibang lugar.Ang pagho-host ng data sa ibang rehiyon ay hindi awtomatikong nag-aalis ng mga obligasyong iyon. Ang mga patakaran kung saan pinoproseso ang data, at ang mga proteksyon na naaangkop sa iyo, ay maaari ring mahalaga.Suriin ang legal na entidad ng provider, mga lokasyon ng pagpoproseso, at patakaran sa privacy bago magbahagi ng personal na data.Isara ang impormasyon ng rehiyonIsara ang paliwanagNaghahanap…I-explore ang dokumentasyonWalang nahanap na mga artikulo. Subukan ang ibang paghahanap o knowledge base.Hindi magagamit ang paghahanap. Pakisubukang muli.Nakopya!Nakopya ang pahina.Nabigo ang pagkopyaNabigo ang pagkopya. Piliin ang teksto ng pahina upang kopyahin ito nang manu-mano.Kopyahin ang pahinaNakopya ang link ng pahina.Hindi makopya ang link. Kopyahin ito mula sa address bar.Inihahanda ang Markdown…Hindi makopya. Subukang muli o buksan ang Tingnan bilang Markdown.Kopyahin ang identifierNakopyaKopyahin ang identifier ng modeloKopyahin mula sa providerKopyahin ang prefixNabigo ang pagkopya. Piliin ang prefix upang kopyahin ito nang manu-mano.Nakopya ang identifier ng modeloNakopya ang {prefix}. Idagdag ang identifier ng modelo pagkatapos ng slash.Hindi makopya. Piliin ang identifier na ito: {identifier}Hindi ma-load ang beripikasyon. Pakisubukang muli o magbukas ng ticket mula sa iyong ShareAI account.Hindi ma-load ang beripikasyon. Pakisubukang muli.Pakitapos ang beripikasyon bago ipadala ang iyong mensahe.Naipadala na ang iyong mensahe. Salamat — sasagot ang ShareAI team sa pamamagitan ng email.Hindi namin makumpirma ang pag-deliver. Pakisuri ang iyong koneksyon bago subukang muli.Nagpapadala…Hindi namin maipadala ang iyong mensahe. Pakisubukang muli.Pakisend ang form na ito mula sa ShareAI.Napakahaba ng iyong mensahe. Pakilimitahan ito sa ilalim ng 10,000 karakter.Pakilagay ng wastong email address.Maglagay ng wastong email address.Pakilagay ng mensahe na hanggang 10,000 karakter.Pakipaikli ang iyong pangalan o paksa.Pakitapos ang beripikasyon.Tapusin ang beripikasyon.Pakisuri ang field na ito.Nabigo ang beripikasyon. Pakisubukang muli.Pakisuri ang iyong mga detalye at subukang muli.Hindi namin makumpirma ang pag-deliver. Pakisubukang muli mamaya o magbukas ng support ticket.{date}: {uptime}. Online {online}, offline {offline}, hindi naobserbahan {unknown}.Walang obserbasyonNaobserbahang uptime ng {percent}Uptime ng {percent}Naobserbahang daily uptime at recording coverage para sa {days} araw. Ang mga nawawalang obserbasyon ay gaps, hindi zero uptime. Gamitin ang arrow keys o daily details controls upang mag-explore.Saklaw ng pagre-recordOnlineOfflineHindi naobserbahanNaobserbahang uptime{percent} ng panahong ito ang na-coverSa na-record na orasNaghihintay ng obserbasyonNa-disconnect habang nagsasagawa ng checksWalang available na history paHuling {days} arawBumubuo ang historyWalang obserbasyon sa panahong itoAng {date} ang unang na-record na araw sa view na ito.Lalabas dito ang na-record na checks habang dumarating ang mga ito.Ipinapakita ang huling {days} araw. {details}Naobserbahang onlineNaobserbahang offlineIsara ang navigationBuksan ang navigationGamitin ang form upang ipadala ang iyong mensahe.Hindi natagpuan ang form.Hindi suportadong datos ng form.Di-wastong datos ng form.Hindi namin maipasa ang iyong aplikasyon. Nandito pa rin ang iyong mga sagot—subukang muli.Ipinapasa ang iyong aplikasyon…Natanggap ang aplikasyon.Salamat sa pagbabahagi ng iyong proyekto. Susuriin namin ito at kokontakin ka tungkol sa angkop na proseso at mga susunod na hakbang.Mag-apply para sa €250 pilotOpen Source Pilot · €250 creditsKopyahin ang routing JSONNakopya ang routing JSONHindi makopya. Piliin ang routing JSON upang kopyahin ito nang manu-mano.Nakopya ang cURL na kahilinganNakopya ang katawan ng kahilinganHindi makopya. Piliin ang endpoint, mga header, at katawan upang kopyahin ang mga ito nang manu-mano.Hindi makopya. Piliin ang katawan ng kahilingan upang kopyahin ito nang manu-mano.