Jika Anda sedang mengevaluasi Alternatif BytePlus API Gateway, panduan ini membandingkan ruang seperti cara pembangun melakukannya: dengan tata kelola, routing & ketahanan, observabilitas, transparansi harga, dan pengalaman pengembang. Kami pertama-tama menempatkan BytePlus dalam tumpukan, lalu memberi peringkat pada 10 alternatif teratas—dengan ShareAI pertama untuk tim yang menginginkan satu API di banyak penyedia, pasar yang transparan (harga/latensi/waktu aktif/ketersediaan sebelum routing), failover instan, dan ekonomi yang didukung oleh orang-orang (70% pengeluaran pergi ke penyedia yang menjaga model tetap online).
Apa itu BytePlus API Gateway (dan apa yang bukan)
Gerbang API BytePlus adalah lapisan manajemen/kontrol API. Anda membawa layanan dan kebijakan Anda; itu menyediakan fitur gateway seperti kredensial terpusat, pembatasan tingkat, otentikasi, routing, dan kontrol siklus hidup API. Itu adalah infrastruktur yang berorientasi pada tata kelola—berguna ketika Anda membutuhkan kebijakan perimeter dan kontrol tingkat organisasi.
Itu adalah tidak transparan pasar model multi-penyedia yang transparan. Itu tidak berfokus pada routing AI multi-penyedia dengan visibilitas pra-rute ke dalam harga, latensi, uptime, ketersediaan, dan jenis penyedia, dan itu tidak ada untuk meningkatkan pasokan komunitas. Jika kebutuhan utama Anda adalah transparansi pra-rute dan failover instan di banyak penyedia AI, Anda sering akan memasangkan gateway dengan agregator seperti ShareAI.
Aggregator vs Gateway vs platform Agen/Orkestrasi
Aggregator LLM (misalnya, ShareAI, OpenRouter, Eden AI): Satu API di banyak model/penyedia dengan transparansi pra-rute (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover.
Gateway AI/API (misalnya, BytePlus API Gateway, Kong, Portkey, Apache APISIX): Kebijakan/pemerintahan di tepi (kredensial, kuota, pembatasan) ditambah observabilitas. Anda membawa penyedia di belakangnya.
Platform Agen/Orkestrasi (misalnya, Orq, Unify): UX yang dikemas, alat, memori, alur, dan evaluasi. Bagus untuk asisten atau pemilihan model terbaik; bukan pasar.
Bagaimana kami mengevaluasi alternatif terbaik BytePlus API Gateway
Luas & netralitas model: proprietary + open; mudah beralih; penulisan ulang minimal
Komunitas & ekonomi: apakah pengeluaran Anda meningkatkan pasokan (insentif untuk pemilik/penyedia GPU)
10 alternatif API Gateway BytePlus teratas
#1 — ShareAI (API AI yang Didukung oleh Komunitas)
Apa itu. A API multi-penyedia dengan pasar yang transparan dan pengaturan cerdas. Dengan satu integrasi, jelajahi katalog besar model dan penyedia, bandingkan harga, latensi, waktu aktif, ketersediaan, dan jenis penyedia, lalu route dengan failover instan. Ekonomi didukung oleh komunitas: 70% setiap dolar mengalir ke penyedia (komunitas atau perusahaan) yang menjaga model tetap online.
Mengapa ini #1. Jika Anda menginginkan agregasi yang tidak bergantung pada penyedia dengan transparansi pra-rute dan ketahanan, ShareAI adalah yang paling cocok langsung. Pertahankan gateway jika Anda memerlukan kebijakan tingkat organisasi; tambahkan ShareAI untuk pengaturan rute yang dipandu oleh marketplace.
Satu API → 150+ model di berbagai penyedia; tanpa penulisan ulang, tanpa penguncian
Pasar yang transparan: pilih berdasarkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia
Ketahanan secara default: kebijakan routing + failover instan
Ekonomi yang adil: 70% dari pengeluaran pergi ke penyedia (komunitas atau perusahaan)
Untuk penyedia: dapatkan penghasilan dengan menjaga model tetap online. Siapa pun dapat menjadi penyedia ShareAI—Komunitas atau Perusahaan. Bergabung melalui Windows, Ubuntu, macOS, atau Docker. Berkontribusi dengan ledakan waktu idle atau jalankan selalu aktif. Pilih insentif Anda: Hadiah (uang), Pertukaran (token/AI Prosumer), atau Misi (sumbangkan % ke LSM). Saat Anda berkembang, tetapkan inferensi Anda sendiri harga dan mendapatkan eksposur preferensial.
Apa itu. Gerbang perusahaan: tata kelola/kebijakan/plugin, analitik, dan pengamatan untuk lalu lintas AI/API. Sebuah pengendali daripada pasar.
Kapan memilihnya. Jika Anda membutuhkan kebijakan tepi di banyak layanan dan sudah distandarisasi pada Kong, maka dipasangkan dengan ShareAI untuk mendapatkan pilihan penyedia berbasis pasar dan failover.
#3 — Portkey
Apa itu. Gerbang AI yang menekankan observabilitas, pengaman, dan tata kelola—populer dalam beban kerja yang diatur.
Kapan memilihnya. Kuat jika prioritas Anda adalah 10. keamanan + jejak mendalam; tambahkan ShareAI untuk transparansi pra-rute dan ketahanan multi-penyedia.
#4 — OpenRouter
Apa itu. API terpadu untuk banyak model; bagus untuk eksperimen cepat di seluruh katalog yang luas.
Kapan memilihnya. Untuk akses multi-model cepat; jika Anda juga ingin failover instan dan statistik marketplace (harga/latensi/waktu aktif/ketersediaan/jenis penyedia), lapisan ShareAI.
#5 — Eden AI
Apa itu. Menggabungkan LLM dan AI yang lebih luas (visi, terjemahan, TTS), dengan fallback dan caching.
Kapan memilihnya. Jika Anda membutuhkan banyak modalitas AI melalui satu API; gabungkan dengan ShareAI untuk visibilitas marketplace langsung dan routing yang tangguh.
#6 — LiteLLM
Apa itu. SDK Python ringan + proxy yang dapat di-host sendiri berbicara antarmuka kompatibel OpenAI ke banyak penyedia.
Kapan memilihnya. Jika Anda lebih suka DIY kontrol dengan dependensi minimal. Gunakan ShareAI untuk manfaat routing yang dikelola dan untuk menghindari pengoperasian proxy pada jalur produksi.
#7 — Unify
Apa itu. Routing yang berorientasi pada kualitas dan pemilihan model berbasis evaluasi per permintaan.
Kapan memilihnya. Jika “model terbaik per prompt” adalah tujuannya; lengkapi dengan katalog + failover instan dari ShareAI.
#8 — Orq AI
Apa itu.Orkestrasi/kolaborasi platform untuk membantu tim berpindah dari eksperimen ke produksi dengan alur kode rendah.
Kapan memilihnya. Jika Anda ingin alur dan orkestrasi tim; arahkan panggilan model melalui ShareAI untuk pilihan penyedia dan failover.
#9 — Apigee (dengan LLM di belakangnya)
Apa itu. Dewasa Manajemen/pintu gerbang API yang dapat Anda tempatkan di depan penyedia LLM untuk kebijakan/kunci/kuota.
Kapan memilihnya. Jika organisasi Anda menstandarkan pada Apigee; tambahkan ShareAI untuk perutean multi-penyedia dan transparansi pasar.
#10 — Apache APISIX
Apa itu.Gateway API open-source dengan plugin, kebijakan lalu lintas, dan ekstensibilitas.
Kapan memilihnya. Jika Anda ingin OSS + DIY kontrol pintu gerbang; gabungkan dengan ShareAI untuk routing yang tidak bergantung pada penyedia dan failover instan tanpa harus membangunnya sendiri.
BytePlus API Gateway vs ShareAI
Jika persyaratan utama Anda adalah satu API di banyak penyedia dengan harga/transparansi/latensi/waktu aktif/ketersediaan dan failover instan, pilih ShareAI. Jika kebutuhan utama Anda adalah tata kelola egress—kredensial terpusat, penegakan kebijakan, dan observabilitas—BytePlus API Gateway cocok untuk jalur itu. Banyak tim memasangkan mereka: gerbang untuk kebijakan organisasi + ShareAI untuk routing yang dipandu pasar.
Perbandingan cepat
Platform
Siapa yang dilayani
Luasnya model
Tata kelola & keamanan
Observabilitas
Routing / failover
Transparansi pasar
Program penyedia
ShareAI
Tim produk/platform yang membutuhkan satu API + ekonomi yang adil
150+ model, banyak penyedia
Kunci API & kontrol per rute
Penggunaan konsol + statistik marketplace
Routing cerdas + failover instan
Ya (harga, latensi, uptime, ketersediaan, jenis penyedia)
Ya — sumber terbuka; 70% ke penyedia
Gerbang API BytePlus
Tim yang membutuhkan pengelolaan egress
Penyedia BYO
Kredensial/kebijakan terpusat
Analitik pintu gerbang
Pengaturan bersyarat melalui kebijakan
Tidak (alat infrastruktur, bukan pasar)
t/a
Kong AI Gateway
Perusahaan yang membutuhkan kebijakan tingkat gateway
Bawa Sendiri
Kebijakan/plugin edge yang kuat
Analitik
Proxy/plugin, pengulangan
Tidak
t/a
Portkey
Tim yang diatur/enterprise
Luas
Kedalaman pembatas & tata kelola
Jejak mendalam
Routing bersyarat
Parsial
t/a
OpenRouter
Pengembang yang menginginkan satu kunci
Katalog luas
Kontrol API dasar
Sisi aplikasi
Cadangan
Parsial
t/a
Eden AI
Tim yang membutuhkan LLM + AI lainnya
Luas
Kontrol standar
Bervariasi
Cadangan/caching
Parsial
t/a
LiteLLM
Proxy DIY/self-host
Banyak
Batas konfigurasi/kunci
Infrastruktur Anda
Pengulangan/cadangan
t/a
t/a
Satukan
Tim yang berorientasi pada kualitas
Multi-model
Keamanan API standar
Analitik platform
Pemilihan model terbaik
t/a
t/a
Orq
Tim yang mengutamakan orkestrasi
Dukungan luas
Kontrol platform
Analitik platform
Alur orkestrasi
t/a
t/a
Apigee
Perusahaan/manajemen API
Bawa Sendiri
Kebijakan yang matang
Add-ons
Kustom
t/a
t/a
Apache APISIX
Gerbang DIY/OSS
Bawa Sendiri
Plugin/kebijakan
Alat komunitas
Kustom
t/a
t/a
Harga & TCO: bandingkan biaya nyata (bukan hanya harga unit)
Mentah $/1K token menyembunyikan gambaran sebenarnya. TCO bergeser dengan pengulangan/cadangan, latensi (yang memengaruhi perilaku pengguna dan biaya), variasi penyedia, penyimpanan observabilitas, dan evaluasi berjalan. Sebuah pasar yang transparan membantu Anda memilih rute yang menyeimbangkan biaya dan UX.
Prototipe (~10k token/hari): Optimalkan untuk waktu-ke-token-pertama (Playground, quickstarts).
Skala menengah (~2M token/hari): Routing/failover yang dipandu oleh marketplace dapat memangkas 10–20% sambil meningkatkan UX.
Beban kerja yang tidak merata: Harapkan biaya token efektif yang lebih tinggi dari pengulangan selama failover; anggarkan untuk itu.
Panduan migrasi: pindah ke ShareAI
Dari BytePlus API Gateway
Pertahankan kebijakan tingkat gateway di tempat mereka unggul; tambahkan ShareAI 3. untuk routing marketplace + failover instan. Pola: autentikasi/kebijakan gateway → ShareAI rute per model → ukur statistik marketplace → perketat kebijakan.
Dari OpenRouter
Petakan nama model, verifikasi kesesuaian prompt, lalu bayangan 10% lalu lintas dan peningkatan 25% → 50% → 100% selama anggaran latensi/kesalahan tetap. Data marketplace membuat pergantian penyedia menjadi sederhana.
Dari LiteLLM
Ganti proxy yang di-host sendiri pada rute yang tidak ingin Anda operasikan; pertahankan LiteLLM untuk pengembangan jika diinginkan. Bandingkan overhead operasi vs. perutean yang dikelola keuntungan.
Dari Unify / Portkey / Orq / Kong / APISIX
Tentukan ekspektasi kesetaraan fitur (analitik, pengaman, orkestrasi, plugin). Banyak tim menjalankan hybrid: pertahankan fitur khusus di tempat mereka paling kuat; gunakan ShareAI 3. untuk pilihan penyedia yang transparan dan failover.
Panduan cepat pengembang (copy-paste)
Berikut menggunakan Kompatibel dengan OpenAI permukaan. Ganti YOUR_KEY dengan kunci ShareAI Anda—buat satu di Buat API Key. Lihat Referensi API untuk detailnya.
// JavaScript (fetch) — Node 18+/Edge runtimes
// Prereqs:
//   process.env.SHAREAI_API_KEY = "YOUR_KEY"

async function main() {
  const res = await fetch("https://api.shareai.now/v1/chat/completions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.SHAREAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "llama-3.1-70b",
      messages: [
        { role: "user", content: "Give me a short haiku about reliable routing." }
      ],
      temperature: 0.4,
      max_tokens: 128
    })
  });

  if (!res.ok) {
    console.error("Request failed:", res.status, await res.text());
    return;
  }

  const data = await res.json();
  console.log(JSON.stringify(data, null, 2));
}

main().catch(console.error);
Daftar periksa keamanan, privasi & kepatuhan (vendor-agnostik)
Penanganan kunci: frekuensi rotasi; cakupan minimal; pemisahan lingkungan
Retensi data: di mana prompt/respons disimpan, untuk berapa lama; default redaksi
PII & konten sensitif: masking; kontrol akses; perutean regional untuk lokalitas data
Observabilitas: pencatatan prompt/respons; kemampuan untuk memfilter atau pseudonim; menyebarkan ID jejak secara konsisten
Respons insiden: jalur eskalasi dan SLA penyedia
FAQ — BytePlus API Gateway vs pesaing lainnya
BytePlus API Gateway vs ShareAI — mana yang cocok untuk perutean multi-penyedia?
BagikanAI. Ini dibuat untuk transparansi pasar (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover di banyak penyedia. BytePlus API Gateway adalah tata kelola egress alat (kredensial/kebijakan terpusat; observabilitas gateway). Banyak tim menggunakan keduanya—kebijakan di tepi + ShareAI untuk perutean.
BytePlus API Gateway vs OpenRouter — kontrol gateway atau akses multi-model cepat?
OpenRouter membuat akses multi-model cepat; BytePlus memusatkan kebijakan dan observabilitas. Jika Anda juga ingin transparansi pra-rute dan failover instan, ShareAI menggabungkan akses multi-penyedia dengan sebuah tampilan marketplace dan routing yang tangguh.
BytePlus API Gateway vs Kong — dua gateway
Keduanya adalah gateway (kebijakan, plugin, analitik), bukan marketplace. Banyak tim memasangkan gateway dengan ShareAI 3. untuk routing multi-penyedia yang transparan dan failover.
BytePlus API Gateway vs Portkey — siapa yang lebih kuat dalam guardrails?
Keduanya menekankan tata kelola dan observabilitas; kedalaman dan ergonomi berbeda. Jika kebutuhan utama Anda adalah pilihan penyedia yang transparan dan failover, tambahkan ShareAI.
BytePlus API Gateway vs LiteLLM — gateway terkelola vs proxy self-host
LiteLLM adalah proxy DIY yang Anda operasikan; BytePlus adalah tata kelola/pengamatan yang dikelola. Jika Anda lebih memilih untuk tidak menjalankan proxy dan ingin routing berbasis marketplace, pilih ShareAI.
BytePlus API Gateway vs Unify — penegakan kebijakan vs pemilihan model terbaik
Satukan berfokus pada pemilihan berbasis evaluasi; BytePlus pada kebijakan/pengamatan. Untuk satu API di banyak penyedia dengan statistik marketplace langsung, gunakan ShareAI.
BytePlus API Gateway vs Orq — orkestrasi vs egress
Orq membantu mengorkestrasi alur kerja; BytePlus mengatur lalu lintas egress. ShareAI melengkapi keduanya dengan pengaturan rute marketplace.
BytePlus API Gateway vs Apigee — manajemen API luas vs egress spesifik AI
Apigee adalah manajemen API yang lebih luas; BytePlus adalah tata kelola egress yang condong ke AI (ketika digunakan dengan cara itu). Jika Anda membutuhkan akses yang tidak bergantung pada penyedia dengan transparansi pasar, gunakan ShareAI.
BytePlus API Gateway vs Apache APISIX — turnkey vs OSS DIY
APISIX menawarkan plugin/kebijakan OSS; BytePlus menawarkan lapisan terkelola dengan integrasi gateway. Untuk menghindari membangun routing khusus namun tetap mendapatkan pemilihan penyedia yang transparan, tambahkan ShareAI.
Jika Anda sedang mencari alternatif TensorBlock Forge, panduan ini membandingkan 10 opsi terbaik seperti cara seorang pembangun akan melakukannya. Pertama, kami menjelaskan apa itu TensorBlock Forge—kemudian kami memetakan pengganti yang kredibel di antara agregator, gateway, alat orkestrasi, dan proxy SDK. Kami menempatkan ShareAI pertama untuk tim yang menginginkan satu API di banyak penyedia, data pasar transparan (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) sebelum pengalihan, failover instan, dan ekonomi yang didukung oleh manusia (70% dari aliran pengeluaran ke penyedia).
TensorBlock Forge memperkenalkan dirinya sebagai API AI terpadu yang membantu pengembang mengakses dan mengorkestrasi model di berbagai penyedia dengan dengan satu kunci aman, menekankan pengalihan cerdas, enkripsi tingkat perusahaan, failover otomatis, dan kontrol biaya secara real-time. Itu adalah lapisan kontrol-dan-pengaturan untuk penggunaan LLM multi-penyedia—bukan pasar model transparan yang dapat Anda telusuri sebelum Anda mengarahkan.
Aggregator vs Gateway vs Orchestrator vs SDK proxy
Agregator LLM (misalnya, ShareAI, OpenRouter, Eden AI): satu API di banyak model/penyedia dengan transparansi pra-rute (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover.
Gateway AI (misalnya, Traefik AI Gateway, Kong, Apache APISIX, Apigee): kebijakan/pemerintahan di tepi (kredensial, batasan tingkat, pengaman), ditambah pengamatan. Anda membawa penyedia; mereka menegakkan dan mengamati.
Platform agen/orchestrasi (misalnya, Orq, Unify): pembangun alur, evaluasi kualitas, dan kolaborasi untuk beralih dari eksperimen ke produksi.
SDK proxy (misalnya, LiteLLM): proxy ringan/permukaan kompatibel OpenAI yang memetakan ke banyak penyedia; bagus untuk DIYer dan self-hosting.
Di mana Forge cocok: “API Terpadu dengan pengaturan & kontrol” tumpang tindih dengan bagian dari kategori aggregator dan gateway, tetapi itu tidak pasar transparan dan netral yang mengekspos secara langsung harga/latensi/waktu aktif/ketersediaan sebelum Anda mengarahkan lalu lintas.
Bagaimana kami mengevaluasi alternatif terbaik untuk TensorBlock Forge
Luas & netralitas model — model proprietary + terbuka; mudah beralih tanpa penulisan ulang.
Komunitas & ekonomi — apakah pengeluaran Anda meningkatkan pasokan (insentif untuk pemilik GPU dan perusahaan).
10 alternatif terbaik TensorBlock Forge
#1 — ShareAI (API AI yang Didukung oleh Komunitas)
Apa itu. A API multi-penyedia dengan pasar yang transparan dan pengaturan cerdas. Dengan satu integrasi, Anda dapat menjelajahi katalog luas model dan penyedia, membandingkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia, dan lakukan routing dengan failover instan. Ekonomi didukung oleh orang-orang: 70% dari setiap dolar mengalir ke penyedia (komunitas atau perusahaan) yang menjaga model tetap online.
Mengapa ini #1 di sini. Jika Anda menginginkan agregasi yang tidak bergantung pada penyedia dengan transparansi pra-rute dan ketahanan, ShareAI adalah yang paling cocok secara langsung. Simpan gateway jika Anda memerlukan kebijakan tingkat organisasi; tambahkan ShareAI untuk routing yang dipandu pasar.
Satu API → katalog besar dari banyak penyedia; tanpa penulisan ulang, tanpa terkunci.
Pasar transparan: pilih berdasarkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia.
Ketahanan secara default: kebijakan routing + failover instan.
Ekonomi yang adil: 70% dari pengeluaran pergi ke penyedia (komunitas atau perusahaan).
Untuk penyedia: dapatkan penghasilan dengan menjaga model tetap online. Bergabung melalui Windows, Ubuntu, macOS, atau Docker. Berkontribusi dengan ledakan waktu idle atau jalankan selalu aktif. Pilih insentif Anda: Hadiah (uang), Pertukaran (token/AI Prosumer), atau Misi (sumbangkan 1% ke LSM). Saat Anda berkembang, Anda dapat menetapkan harga inferensi Anda sendiri dan mendapatkan eksposur preferensial.
Apa itu. API terpadu di atas banyak model; sangat baik untuk eksperimen cepat di katalog yang luas.
Terbaik untuk. Pengembang yang ingin mencoba banyak model dengan cepat menggunakan satu kunci.
Mengapa mempertimbangkan vs Forge. Variasi model yang lebih luas langsung tersedia; dipasangkan dengan ShareAI untuk statistik marketplace dan failover.
#3 — Portkey
Apa itu. Gateway AI yang menekankan observabilitas, pengaman, dan tata kelola perusahaan.
Terbaik untuk. Industri yang diatur membutuhkan kontrol kebijakan yang mendalam.
Mengapa mempertimbangkan vs Forge. Jika tata kelola dan keterlihatan adalah prioritas utama Anda, Portkey bersinar; tambahkan ShareAI untuk pengaturan rute yang transparan.
#4 — Kong AI Gateway
Apa itu. Gerbang API perusahaan dengan fitur lalu lintas AI/LLM—kebijakan, plugin, analitik di tepi.
Terbaik untuk. Tim platform yang menstandarisasi kontrol egress.
Mengapa mempertimbangkan vs Forge. Tata kelola tepi yang kuat; pasangkan dengan ShareAI untuk pemilihan multi-penyedia yang dipandu oleh marketplace.
#5 — Eden AI
Apa itu. Sebuah agregator yang mencakup LLM serta AI yang lebih luas (gambar, terjemahan, TTS), dengan fallback dan caching.
Terbaik untuk. Tim yang membutuhkan multi-modalitas dalam satu API.
Mengapa mempertimbangkan vs Forge. Area permukaan AI yang lebih luas; ShareAI tetap lebih kuat dalam transparansi sebelum pengaturan rute.
#6 — LiteLLM
Apa itu. SDK Python ringan dan proxy self-hosted opsional yang mengekspos antarmuka kompatibel OpenAI di seluruh penyedia.
Terbaik untuk. Pembuat DIY yang menginginkan proxy dalam tumpukan mereka.
Mengapa mempertimbangkan vs Forge. Antarmuka OpenAI yang familiar dan konfigurasi yang berpusat pada pengembang; pasangkan dengan ShareAI untuk mengalihkan pengaturan rute dan failover yang dikelola.
#7 — Unify
Apa itu.Pengaturan rute & evaluasi yang berorientasi pada kualitas untuk memilih model yang lebih baik per prompt.
Terbaik untuk. Tim yang mengejar peningkatan kualitas yang terukur (tingkat kemenangan) di seluruh prompt.
Mengapa mempertimbangkan vs Forge. Jika “pilih model terbaik” adalah tujuannya, alat evaluasi Unify menjadi fokus; tambahkan ShareAI ketika Anda juga menginginkan statistik pasar langsung dan keandalan multi-penyedia.
#8 — Orq
Apa itu.Orkestrasi & kolaborasi platform untuk beralih dari eksperimen ke produksi dengan alur kode rendah.
Terbaik untuk. Tim membangun alur kerja/agen yang mencakup beberapa alat dan langkah.
Mengapa mempertimbangkan vs Forge. Melampaui lapisan API ke alur yang terorkestrasi; pasangkan dengan ShareAI untuk akses netral dan failover.
#9 — Gerbang AI Traefik
Apa itu. A berorientasi pada tata kelola gateway—kredensial terpusat dan kebijakan dengan observabilitas ramah OpenTelemetry dan middleware AI khusus (misalnya, kontrol konten, caching).
Terbaik untuk. Organisasi yang menstandarkan tata kelola egress di atas Traefik.
Mengapa mempertimbangkan vs Forge. Lapisan AI tipis di atas gateway yang terbukti; tambahkan ShareAI untuk memilih penyedia berdasarkan harga/latensi/waktu aktif/ketersediaan dan mengarahkan dengan tangguh.
#10 — Apache APISIX
Apa itu. Gateway API open-source berkinerja tinggi dengan plugin yang dapat diperluas dan kebijakan lalu lintas.
Terbaik untuk. Tim yang lebih memilih kontrol gateway DIY open-source.
Mengapa mempertimbangkan vs Forge. Model kebijakan dan plugin yang terperinci; tambahkan ShareAI untuk mendapatkan transparansi pasar dan failover multi-penyedia.
TensorBlock Forge vs ShareAI
Jika Anda membutuhkan satu API di atas banyak penyedia dengan harga/transparansi/latensi/waktu aktif/ketersediaan dan failover instan, pilih ShareAI. Jika kebutuhan utama Anda adalah tata kelola egress—kredensial terpusat, penegakan kebijakan, dan observabilitas mendalam—Forge memposisikan dirinya lebih dekat dengan alat lapisan kontrol. Banyak tim menggabungkan mereka: gateway/kontrol untuk kebijakan organisasi + ShareAI untuk routing yang dipandu oleh marketplace.
Perbandingan cepat
Platform
Siapa yang dilayani
Luasnya model
Tata kelola & keamanan
Observabilitas
Routing / failover
Transparansi pasar
Program penyedia
ShareAI
Tim produk/platform mencari satu API + ekonomi yang adil
Katalog luas di berbagai penyedia
Kunci API & kontrol per rute
Penggunaan konsol + statistik marketplace
Routing cerdas + failover instan
Ya (harga, latensi, waktu aktif, ketersediaan, jenis penyedia)
Ya — pasokan terbuka; 70% ke penyedia
TensorBlock Forge
Tim yang menginginkan API terpadu + kontrol
Penyedia BYO
Penanganan kunci terpusat
Analitik runtime (bervariasi berdasarkan pengaturan)
Routing bersyarat, failover
Tidak (lapisan alat, bukan marketplace)
t/a
OpenRouter
Pengembang menginginkan satu kunci untuk banyak model
Katalog luas
Kontrol API dasar
Sisi aplikasi
Cadangan
Parsial
t/a
Portkey
Tim yang diatur/enterprise
Luas
Guardrails & tata kelola
Jejak mendalam
Routing bersyarat
Parsial
t/a
Kong AI Gateway
Perusahaan yang membutuhkan kebijakan gateway
Bawa Sendiri
Kebijakan/plugin edge yang kuat
Analitik
Proxy/plugin, pengulangan
Tidak (infra)
t/a
Eden AI
AI multi-layanan (LLM + vision/TTS)
Luas
Kontrol standar
Bervariasi
Cadangan/caching
Parsial
t/a
LiteLLM
Proxy DIY/self-host
Banyak penyedia
Batas konfigurasi/kunci
Infrastruktur Anda
Pengulangan/cadangan
t/a
t/a
Satukan
Tim yang berorientasi pada kualitas
Multi-model
Keamanan API standar
Analitik platform
Pemilihan model terbaik
t/a
t/a
Orq
Tim yang mengutamakan orkestrasi
Dukungan luas
Kontrol platform
Analitik platform
Alur orkestrasi
t/a
t/a
Traefik / APISIX
Perusahaan / DIY
Bawa Sendiri
Kebijakan
Add-ons/kustom
Kustom
t/a
t/a
Ingin membandingkan harga dan latensi langsung sebelum routing? Mulailah dengan Marketplace Model dan kirim permintaan pertama Anda dari Taman bermain.
Harga & TCO: bandingkan nyata biaya (bukan hanya harga satuan)
Dolar mentah per 1K token jarang menceritakan keseluruhan cerita. TCO efektif bergeser dengan pengulangan/cadangan, latensi (mempengaruhi perilaku pengguna), variasi penyedia, penyimpanan observabilitas, dan evaluasi berjalan. Marketplace transparan membantu Anda memilih rute yang menyeimbangkan biaya dan UX.
Prototipe (~10k token/hari): Optimalkan untuk waktu-ke-token-pertama. Gunakan Playground dan quickstarts.
Skala menengah (~2M token/hari): Routing/failover yang dipandu Marketplace dapat memangkas 10–20% sambil meningkatkan UX.
Beban kerja yang tidak stabil: Harapkan biaya token efektif yang lebih tinggi dari pengulangan selama failover; anggarkan untuk itu.
Panduan migrasi: pindah ke ShareAI
Dari TensorBlock Forge
Pertahankan kebijakan lapisan kontrol di tempat mereka unggul; tambahkan ShareAI untuk pengaturan pasar dan failover instan. Pola: otentikasi/kebijakan lapisan kontrol → rute ShareAI per model → ukur statistik pasar → perketat kebijakan.
Dari OpenRouter
Petakan nama model, verifikasi kesesuaian prompt, lalu bayangan 10% dari lalu lintas dan tingkatkan 25% → 50% → 100% selama anggaran latensi/kesalahan tetap. Data marketplace membuat pergantian penyedia menjadi sederhana.
Dari LiteLLM
Ganti proxy yang di-host sendiri pada rute produksi yang tidak ingin Anda operasikan; pertahankan LiteLLM untuk pengembangan jika diinginkan. Bandingkan overhead operasi vs. manfaat routing yang dikelola.
Dari Unify / Portkey / Orq / Kong / Traefik / APISIX
Tentukan ekspektasi kesetaraan fitur (analitik, guardrails, orkestrasi, plugin). Banyak tim menjalankan hybrid: pertahankan fitur khusus di tempat mereka paling kuat; gunakan ShareAI untuk pilihan penyedia yang transparan dan failover yang tangguh.
Panduan cepat pengembang (copy-paste)
Berikut menggunakan Kompatibel dengan OpenAI permukaan. Ganti YOUR_KEY dengan kunci ShareAI Anda—dapatkan satu di Buat API Key.
Retensi data — tempat penyimpanan prompt/respons, untuk berapa lama; default redaksi.
PII & konten sensitif — masking; kontrol akses; pengaturan regional untuk lokalitas data.
Observabilitas — pencatatan prompt/respons; kemampuan untuk memfilter atau menyamarkan; propagasi ID jejak secara konsisten.
Respons insiden — jalur eskalasi dan SLA penyedia.
FAQ — TensorBlock Forge vs pesaing lainnya
TensorBlock Forge vs ShareAI — mana yang lebih baik untuk multi-provider routing? Pilih ShareAI. Dibangun untuk transparansi marketplace (harga, latensi, uptime, ketersediaan, jenis penyedia) dan routing/failover yang tangguh di banyak penyedia. Gunakan gateway/lapisan kontrol ketika kebijakan/observabilitas di tingkat organisasi adalah kebutuhan utama Anda, dan pasangkan dengan ShareAI untuk pilihan penyedia yang transparan.
TensorBlock Forge vs OpenRouter — akses multi-model cepat atau transparansi marketplace? OpenRouter membuat akses multi-model menjadi cepat; ShareAI menambahkan transparansi pra-rute dan failover instan. Jika Anda ingin memilih rute berdasarkan data keras (harga/latensi/uptime/ketersediaan), ShareAI unggul.
TensorBlock Forge vs Eden AI — banyak layanan AI atau routing LLM yang terfokus? Eden AI mencakup LLM serta vision/translation/TTS. Jika Anda terutama membutuhkan pilihan penyedia yang transparan dan failover yang tangguh untuk LLM, ShareAI lebih cocok.
TensorBlock Forge vs LiteLLM — proxy self-host atau routing yang dikelola? LiteLLM adalah proxy DIY yang Anda operasikan sendiri. ShareAI menyediakan agregasi yang dikelola dengan statistik marketplace dan failover instan—tanpa perlu menjalankan proxy.
TensorBlock Forge vs Portkey — siapa yang lebih kuat dalam guardrails/observabilitas? Portkey menekankan tata kelola dan pelacakan mendalam. Jika Anda juga menginginkan transparansi harga/latensi dan routing multi-provider yang tangguh, tambahkan ShareAI.
TensorBlock Forge vs Kong AI Gateway — kontrol gateway atau marketplace? Kong adalah gateway kebijakan/analitik yang kuat. ShareAI adalah lapisan marketplace/agregasi yang memilih penyedia berdasarkan data langsung dan gagal secara instan.
TensorBlock Forge vs Traefik AI Gateway — tata kelola egress atau kecerdasan routing? Traefik berfokus pada kredensial terpusat dan observabilitas. ShareAI unggul dalam routing yang tidak bergantung pada penyedia dengan transparansi marketplace—banyak tim menggunakan keduanya.
TensorBlock Forge vs Unify — pemilihan berbasis kualitas atau routing marketplace? Unify berfokus pada pemilihan model terbaik berbasis evaluasi. ShareAI menambahkan statistik marketplace dan keandalan multi-penyedia; mereka saling melengkapi.
TensorBlock Forge vs Orq — orkestrasi vs routing? Orq mengorkestrasi alur dan agen; ShareAI memberi Anda lapisan penyedia netral dengan statistik transparan dan failover.
TensorBlock Forge vs Apache APISIX — gateway open-source vs marketplace transparan? APISIX memberikan kebijakan/plugin DIY. ShareAI menyediakan transparansi pra-rute dan failover yang terkelola; gabungkan keduanya jika Anda menginginkan kontrol gateway yang terperinci dengan routing yang dipandu marketplace.
TensorBlock Forge vs Apigee — manajemen API vs routing khusus AI? Apigee adalah manajemen API yang luas. Untuk penggunaan AI, ShareAI menambahkan pandangan marketplace dan ketahanan multi-penyedia yang tidak disediakan oleh Apigee sendiri.
Jika Anda sedang mengevaluasi Alternatif Google Apigee, panduan ini memetakan lanskap seperti seorang pembangun. Pertama, kami menjelaskan apa itu Apigee adalah—platform manajemen API perusahaan Google Cloud dengan proxy API, katalog kebijakan mendalam (auth, kuota, transformasi), analitik, dan hibrida penerapan—kemudian kami membandingkan 10 opsi terbaik untuk lalu lintas AI/LLM dan program API modern. Kami menempatkan ShareAI pertama untuk tim yang menginginkan satu API di banyak penyedia, pasar transparan (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) sebelum routing, failover instan, dan ekonomi yang didukung oleh orang-orang di mana 70% dari pengeluaran mengalir ke penyedia. Apigee tetap menarik untuk manajemen dan tata kelola API spektrum penuh; ini bukan model pasar yang agnostik penyedia maupun router multi-penyedia.
Apa itu Google Apigee (dan apa yang bukan)
Apigee adalah produk manajemen API yang sepenuhnya dikelola dari Google Cloud. Anda dapat menghubungkan backend dengan proxy API, menerapkan lusinan kebijakan bawaan (keamanan, pembatasan tingkat, transformasi), mempublikasikan portal pengembang, menganalisis lalu lintas, dan (opsional) menjalankan dalam hibrida mode dengan pesawat manajemen yang di-host oleh Apigee ditambah runtime yang Anda operasikan di Kubernetes. Dalam gerbang AI konteks, tim biasanya menempatkan penyedia LLM di belakang Apigee untuk kunci terpusat, kuota, dan observabilitas. Tetapi Apigee bukanlah netral pasar model multi-penyedia yang transparan atau router multi-penyedia yang cerdas—Anda membawa penyedia; Apigee menyediakan tata kelola dan analitik.
Jika Anda ingin panduan resmi nanti, mulai dengan halaman produk Apigee dan ikhtisar “Apa itu Apigee?”.
Aggregator vs Gateway vs platform Agen/Orkestrasi
Aggregator LLM (misalnya, ShareAI, OpenRouter, Eden AI) – Satu API di banyak model/penyedia dengan transparansi pra-rute (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan tahan routing/failover yang sudah terintegrasi. ShareAI juga menekankan ekonomi yang digerakkan oleh orang (70% untuk penyedia) dan luasnya katalog (150+ model).
Gerbang AI/API (misalnya, Apigee, Kong, Traefik AI Gateway, Apache APISIX, NGINX, Portkey) – Memusatkan kredensial, kebijakan, kuota, dan observabilitas di tepi; Anda membawa penyedia. Apigee berada di sini; ini berpusat pada program API, bukan pasar model.
Platform agen/orchestrasi (misalnya, Orq, Unify) – Alur yang dikemas, alat, evaluasi, dan kolaborasi—bagus untuk eksperimen dan orkestrasi produksi, bukan untuk routing yang tidak bergantung pada penyedia.
TL;DR: Jika Anda membutuhkan pilihan model yang dipandu oleh pasar dan failover instan, pilih agregator. Jika Anda membutuhkan kebijakan perusahaan, tata kelola, analitik, dan portal, pilih gerbang. Banyak tim produksi menggabungkan keduanya.
Bagaimana kami mengevaluasi alternatif terbaik Google Apigee
Luas & netralitas model: proprietary + open; pertukaran cepat; tanpa penulisan ulang.
Komunitas & ekonomi: apakah pengeluaran Anda meningkatkan pasokan (insentif untuk pemilik GPU).
10 Alternatif Terbaik Google Apigee
#1 — ShareAI (API AI yang Didukung oleh Komunitas)
Apa itu. A API multi-penyedia dengan pasar yang transparan dan pengaturan cerdas. Dengan satu integrasi, jelajahi katalog besar model dan penyedia, bandingkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia, dan lakukan routing dengan failover instan. Ekonomi adalah berbasis orang: 70% setiap dolar mengalir ke penyedia (komunitas atau perusahaan) yang menjaga model tetap online.
Mengapa ini #1 di sini. Jika Anda ingin agregasi yang tidak bergantung pada penyedia dengan transparansi pra-rute dan ketahanan, ShareAI adalah yang paling cocok langsung. Pertahankan Apigee jika Anda membutuhkan tingkat organisasi program API fitur (katalog kebijakan, analitik, portal); tambahkan ShareAI untuk pengaturan yang dipandu oleh pasar.
Satu API → 150+ model di banyak penyedia; tanpa penulisan ulang, tanpa terkunci.
Pasar transparan: pilih berdasarkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia.
Ketahanan secara default: kebijakan routing + failover instan.
Ekonomi yang adil: 70% dari pengeluaran pergi ke penyedia (komunitas atau perusahaan).
Untuk penyedia: dapatkan dengan menjaga model tetap online Siapa pun dapat menjadi penyedia ShareAI—Komunitas atau Perusahaan. Bergabung melalui Windows, Ubuntu, macOS, atau Docker. Berkontribusi waktu-idle ledakan atau jalankan selalu aktif. Pilih insentif Anda: Hadiah (uang), Pertukaran (token/AI Prosumer), atau Misi (sumbangkan % ke LSM). Saat Anda berkembang, Anda dapat menetapkan harga inferensi Anda sendiri dan mendapatkan eksposur preferensial. Mulai di Panduan Penyedia atau mengelola perangkat melalui Dasbor Penyedia.
#2 — Kong AI Gateway
Apa itu. Gateway Enterprise untuk tata kelola, kebijakan/plugin, analitik, dan observabilitas di tepi. Ini adalah control plane daripada marketplace.
#3 — Portkey
Apa itu. Gerbang AI yang menekankan observabilitas, pengaman, dan tata kelola—sering dipilih untuk beban kerja yang diatur.
#4 — OpenRouter
Apa itu. Aggregator dengan katalog model yang luas dan API terpadu; bagus untuk eksperimen cepat di berbagai penyedia.
#5 — Eden AI
Apa itu. Menggabungkan LLMs ditambah kemampuan AI yang lebih luas (visi, terjemahan, TTS) dengan cadangan/caching dan pengelompokan.
#6 — LiteLLM
Apa itu. SDK Python ringan + proxy yang dapat di-host sendiri yang menggunakan antarmuka kompatibel OpenAI ke banyak penyedia.
#7 — Unify
Apa itu.Berorientasi pada kualitas routing dan evaluasi untuk memilih model yang lebih baik per prompt.
#8 — Orq
Apa itu.Orkestrasi/kolaborasi platform yang membantu tim beralih dari eksperimen ke produksi dengan alur low-code.
#9 — Apache APISIX
Apa itu.Gateway API open-source (plugin, kontrol lalu lintas, kebijakan). Anda membawa penyedia; APISIX menegakkan perilaku gateway.
#10 — NGINX
Apa itu. Pendekatan DIY: membangun routing, penegakan token, dan caching untuk backend LLM dengan primitif berkinerja tinggi.
Apigee vs ShareAI
Jika Anda membutuhkan satu API di atas banyak penyedia dengan harga/transparansi/latensi/waktu aktif dan failover instan, pilih ShareAI. Jika kebutuhan utama Anda adalah manajemen API perusahaan—kredensial terpusat, penegakan kebijakan, analitik, hybrid/multicloud—Apigee cocok dengan jalur itu. Banyak tim memasangkan mereka: Apigee untuk kebijakan organisasi & portal pengembang, ShareAI untuk routing dan ketahanan yang dipandu oleh marketplace.
Perbandingan cepat (sekilas)
Platform
Siapa yang dilayani
Luasnya model
Tata kelola & keamanan
Observabilitas
Routing / failover
Transparansi pasar
Program penyedia
ShareAI
Tim produk/platform yang membutuhkan satu API + ekonomi yang adil
150+ model, banyak penyedia
Kunci API & kontrol per rute
Penggunaan konsol + statistik marketplace
Routing cerdas + failover instan
Ya (harga, latensi, uptime, ketersediaan, jenis penyedia)
Ya — sumber terbuka; 70% ke penyedia
Apigee
Perusahaan yang membutuhkan manajemen API yang luas
BYO penyedia/model
Perpustakaan kebijakan yang kuat (auth, kuota, transformasi)
Analitik & pemantauan bawaan
Alur proxy bersyarat, pengulangan
Tidak (tata kelola platform, bukan marketplace)
t/a
Kekuatan Apigee dalam pustaka kebijakan, analitik, portal, dan hibrida runtime sudah dikenal luas; transparansi pasar multi-penyedia dan perutean langsung dengan agregator seperti ShareAI.
Harga & TCO: bandingkan nyata biaya (bukan hanya harga satuan)
Mentah $/1K token menyembunyikan gambar yang sebenarnya. TCO bergeser dengan pengulangan/cadangan, latensi (yang mengubah penggunaan), variasi penyedia, penyimpanan observabilitas, dan evaluasi berjalan. Sebuah pasar yang transparan membantu Anda memilih rute yang seimbang biaya dan UX.
Prototipe (~10k token/hari): Optimalkan untuk waktu-ke-token-pertama (gunakan Buka Playground dan quickstarts).
Skala menengah (~2M token/hari):Pengarahan + failover yang dipandu Marketplace dapat memangkas 10–20% sambil meningkatkan UX.
Beban kerja yang tidak stabil: Harapkan biaya token efektif yang lebih tinggi dari pengulangan selama failover; anggaran untuk itu.
Panduan migrasi: pindah ke ShareAI
Dari Apigee Pertahankan Apigee di tempat yang unggul (kebijakan, tata kelola, portal, analitik); tambahkan ShareAI untuk perutean pasar + failover instan. Pola: otentikasi/kebijakan Apigee → rute ShareAI per model → pantau statistik pasar → perketat kebijakan.
Dari OpenRouter Peta nama model, verifikasi kesetaraan prompt; bayangan 10% dari lalu lintas dan ramp 25% → 50% → 100% selama anggaran latensi/kesalahan tetap. Data marketplace membuat pergantian penyedia menjadi sederhana.
Dari LiteLLM Ganti proxy yang di-host sendiri pada rute produksi yang tidak ingin Anda operasikan; pertahankan LiteLLM untuk pengembangan jika diinginkan. Bandingkan overhead operasi vs. manfaat routing yang dikelola.
Dari Unify / Portkey / Orq / Kong / APISIX / NGINX Tentukan ekspektasi kesetaraan fitur (analitik, pengaman, orkestrasi, plugin). Banyak tim menjalankan hybrid: pertahankan fitur khusus di tempat mereka paling kuat; gunakan ShareAI untuk pilihan penyedia transparan dan failover.
Panduan cepat pengembang (copy-paste)
Berikut menggunakan Kompatibel dengan OpenAI permukaan. Ganti YOUR_KEY dengan kunci ShareAI Anda—buat satu di Buat API Key. Lihat Referensi API untuk detailnya.
Retensi data: tempat prompt/respons disimpan; jangka waktu retensi; pengaturan default redaksi.
PII & konten sensitif: masking; kontrol akses; perutean regional untuk lokasi data.
Observabilitas: pencatatan prompt/respons; kemampuan untuk memfilter atau menyamarkan; menyebarkan ID jejak secara konsisten.
Respons insiden: jalur eskalasi dan SLA penyedia.
FAQ — Apigee vs pesaing lainnya (ditambah varian pesaing-vs-pesaing)
Apigee vs ShareAI — mana yang lebih baik untuk routing multi-penyedia?
BagikanAI. Ini dibangun untuk transparansi marketplace (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover di antara banyak penyedia. Apigee adalah platform manajemen API (kebijakan, analitik, hybrid, portal). Banyak tim menggunakan keduanya.
Apigee vs OpenRouter — akses multi-model cepat atau kontrol gateway?
OpenRouter membuat akses multi-model cepat; Apigee memusatkan kebijakan dan observabilitas. Jika Anda juga ingin transparansi pra-rute dan failover instan, ShareAI menggabungkan akses multi-penyedia dengan tampilan marketplace dan routing yang tangguh.
Apigee vs LiteLLM — proxy self-host atau tata kelola terkelola?
LiteLLM adalah proxy DIY yang Anda operasikan; Apigee menawarkan tata kelola/observabilitas terkelola untuk lalu lintas API apa pun. Jika Anda lebih memilih untuk tidak menjalankan proxy dan Anda ingin routing berbasis marketplace, pilih ShareAI.
Apigee vs Portkey — siapa yang lebih kuat dalam guardrails?
Keduanya menekankan tata kelola/observabilitas; kedalaman dan ergonomi berbeda. Jika kebutuhan utama Anda adalah pilihan penyedia yang transparan dan failover, tambahkan ShareAI.
Apigee vs Unify — pemilihan model terbaik vs penegakan kebijakan?
Satukan berfokus pada pemilihan model berbasis evaluasi; Apigee pada kebijakan dan analitik. Untuk satu API melalui banyak penyedia dengan statistik pasar langsung, gunakan ShareAI.
Apigee vs Eden AI — banyak layanan AI atau kontrol egress?
Eden AI menggabungkan banyak layanan AI (LLM, gambar, TTS). Apigee memusatkan kebijakan/credential dan analitik. Untuk transparansi harga/latensi di banyak penyedia dan failover instan, pilih ShareAI.
Apigee vs Orq — orkestrasi vs egress?
Orq membantu mengorkestrasi alur kerja; Apigee mengatur lalu lintas egress dan portal pengembang. ShareAI melengkapi keduanya dengan routing marketplace.
Apigee vs Kong AI Gateway — dua gateway
Keduanya adalah gateway (kebijakan, plugin, analitik), bukan marketplace. Banyak tim memasangkan gateway dengan ShareAI 3. untuk routing multi-penyedia yang transparan dan failover.
Apigee vs Apache APISIX — gateway open-source atau platform terkelola?
APISIX adalah open-source dan berbasis plugin; Apigee sepenuhnya terkelola dengan fitur enterprise mendalam (kebijakan, analitik, hybrid). Jika Anda juga membutuhkan akses model netral penyedia dan routing pintar, tambahkan ShareAI.
Apigee vs NGINX — DIY vs turnkey
NGINX menawarkan filter/kebijakan DIY; Apigee menawarkan lapisan platform yang dikemas dengan analitik dan portal. Untuk menghindari scripting kustom dan tetap mendapatkan pemilihan penyedia yang transparan, lapisan di ShareAI.
OpenRouter vs Apache APISIX (kompetitor-vs-kompetitor)
Apel dan jeruk: OpenRouter adalah sebuah agregator (satu API di atas banyak model), sementara APISIX adalah gerbang. Untuk transparansi marketplace + routing multi-penyedia, ShareAI mengungguli keduanya dengan memasangkan katalog + routing + failover—dan ini dapat ditempatkan di belakang gateway seperti APISIX ketika Anda menginginkan kebijakan edge plus pemilihan model pintar.
Kong vs Portkey (kompetitor-vs-kompetitor)
Keduanya adalah gateway dengan tata kelola/observabilitas; Kong memiliki ekosistem plugin yang matang, sementara Portkey menekankan pengamanan khusus AI dan jejak mendalam. Bagaimanapun, ShareAI menyediakan transparansi pra-rute dan perutean yang tangguh di luar cakupan gateway.
Traefik AI Gateway vs Apigee (kompetitor-vs-kompetitor)
Keduanya adalah gateway; Gateway AI Traefik menambahkan lapisan AI tipis dan middleware khusus, sementara Apigee adalah suite manajemen API yang komprehensif dengan hybrid, portal, dan analitik. Banyak tim menggunakan ShareAI untuk marketplace dan failover instan potongan.
LiteLLM vs NGINX (kompetitor-vs-kompetitor)
LiteLLM = proxy self-host; NGINX = primitif gateway DIY. Jika Anda tidak ingin mengoperasikan infra dan tetap membutuhkan tidak bergantung pada penyedia akses dengan pengaturan cerdas, ShareAI lebih sederhana.
Unify vs Eden AI (kompetitor-vs-kompetitor)
Satukan berfokus pada evaluasi-berbasis pemilihan model terbaik; Eden AI mencakup banyak jenis layanan AI. ShareAI melengkapi keduanya dengan sebuah pasar yang transparan dan failover instan di berbagai penyedia.
Di mana ShareAI cocok berikutnya
Jelajahi model: Bandingkan harga, latensi, waktu aktif, ketersediaan, dan jenis penyedia di Jelajahi Model.
Coba sekarang: Kirim prompt pertama Anda di Buka Playground (tidak memerlukan SDK).
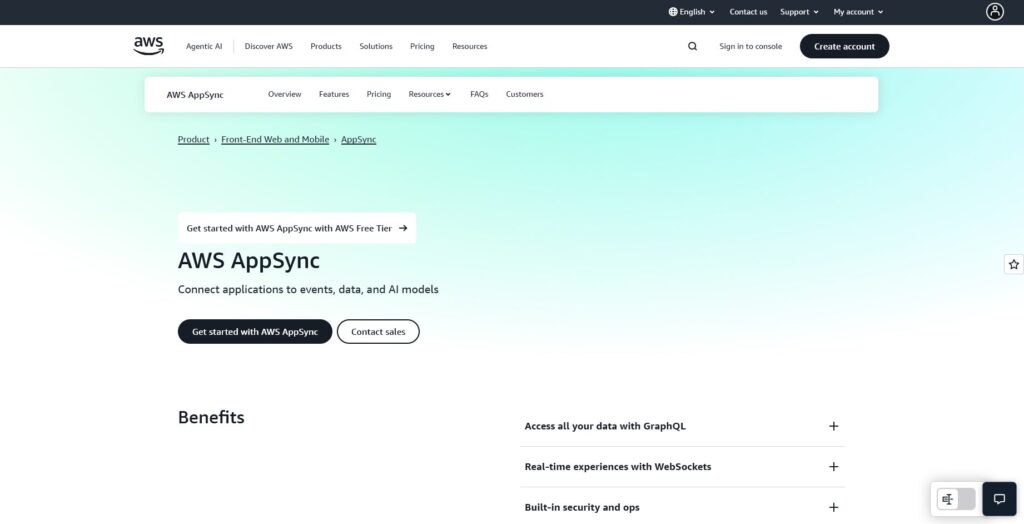
Jika Anda sedang mengevaluasi Alternatif AWS AppSync, panduan ini memetakan lanskap seperti cara seorang pembangun. Pertama, kami menjelaskan apa itu AppSync—layanan GraphQL yang sepenuhnya dikelola yang terhubung ke sumber data AWS (DynamoDB, Lambda, Aurora, OpenSearch, HTTP), mendukung langganan real-time melalui WebSockets, dan sering digunakan sebagai pola “AI gateway” di depan Amazon Bedrock—kemudian kami membandingkan 10 alternatif terbaik. Kami menempatkan ShareAI pertama untuk tim yang menginginkan satu API di banyak penyedia, sebuah pasar yang transparan dengan harga/latensi/waktu aktif/ketersediaan sebelum routing, failover instan, dan ekonomi yang digerakkan oleh manusia (70% pengeluaran pergi ke penyedia).
Apa itu AWS AppSync (dan apa yang bukan)
Apa itu AppSync. AppSync adalah lapisan GraphQL yang dikelola AWS: ia memproses query dan mutasi, menyelesaikan field terhadap sumber data yang dikonfigurasi (DynamoDB, Lambda, Aurora, OpenSearch, HTTP), dan dapat mendorong pembaruan secara real-time menggunakan GraphQL langganan melalui WebSockets yang aman. Ini juga menawarkan resolver JavaScript sehingga Anda dapat menulis logika resolver dalam JS yang sudah dikenal. Dalam aplikasi AI, banyak tim menggunakan Amazon Bedrock dengan AppSync—menangani autentikasi dan pembatasan di GraphQL sambil mengalirkan token ke klien melalui langganan.
Apa yang bukan AppSync. Itu adalah tidak pasar model dan itu tidak menyatukan akses ke banyak penyedia AI pihak ketiga di bawah satu API. Anda membawa layanan AWS (dan Bedrock). Untuk routing multi-penyedia (transparansi pra-rute; failover antar penyedia), pasangkan atau gantikan dengan agregator seperti ShareAI.
Mengapa Anda mendengar “gerbang AI untuk Bedrock.” GraphQL + WebSockets + resolver AppSync menjadikannya lapisan egress/pemerintahan alami di depan Bedrock untuk beban kerja sinkron dan streaming. Anda tetap menggunakan GraphQL sebagai kontrak klien Anda sambil memanggil Bedrock di resolver atau fungsi Anda.
Agregator vs Gateway vs platform Agen
agregator LLM (ShareAI, OpenRouter, Eden AI, LiteLLM): satu API di berbagai model/penyedia dengan transparansi pra-rute (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover.
gerbang AI (Kong AI Gateway, Portkey, AppSync-as-gateway, Apigee/NGINX/APISIX/Tyk/Azure APIM/Gravitee): pemerintahan di tepi (kunci, kuota, pembatas), observabilitas, dan kebijakan — Anda membawa penyedia.
platform agen/chatbot (Unify, Orq): evaluasi yang dikemas, alat, memori, saluran—ditujukan untuk logika aplikasi daripada agregasi yang tidak bergantung pada penyedia.
Dalam praktiknya, banyak tim menjalankan keduanya: gerbang untuk kebijakan organisasi + ShareAI untuk routing dan ketahanan yang dipandu oleh marketplace.
Bagaimana kami mengevaluasi alternatif AppSync terbaik
Luas & netralitas model: proprietary + open; mudah beralih; tanpa penulisan ulang.
Komunitas & ekonomi: apakah pengeluaran Anda meningkatkan pasokan (insentif untuk pemilik/penyedia GPU).
10 alternatif AWS AppSync terbaik
#1 — ShareAI (API AI yang Didukung oleh Komunitas)
Apa itu. A API multi-penyedia dengan pasar yang transparan dan pengaturan cerdas. Dengan satu integrasi, telusuri katalog besar model dan penyedia; bandingkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia; dan arahkan dengan failover instan. Ekonomi didukung oleh komunitas: 70% dari setiap dolar mengalir ke penyedia (komunitas atau perusahaan) yang menjaga model tetap online.
Mengapa ini #1 di sini. Jika Anda ingin agregasi yang tidak bergantung pada penyedia dengan transparansi pra-rute dan ketahanan, ShareAI adalah pilihan yang paling langsung. Pertahankan gateway jika Anda membutuhkan kebijakan tingkat organisasi; tambahkan ShareAI untuk pengaturan yang dipandu oleh pasar.
Satu API → 150+ model di banyak penyedia; tanpa penulisan ulang, tanpa terkunci.
Pasar yang transparan: pilih berdasarkan harga, latensi, waktu aktif, ketersediaan, jenis penyedia.
Ketahanan secara default: kebijakan routing + failover instan.
Ekonomi yang adil: 70% dari pengeluaran masuk ke penyedia (komunitas atau perusahaan).
Untuk penyedia: dapatkan penghasilan dengan menjaga model tetap online. Bergabung melalui Windows, Ubuntu, macOS, Docker; berkontribusi waktu-idle ledakan atau jalankan selalu aktif. Pilih insentif Anda: Hadiah (uang), Pertukaran (token/AI Prosumer), atau Misi (donasikan % ke LSM). Saat Anda berkembang, Anda dapat menetapkan harga inferensi dan mendapatkan eksposur preferensial. Panduan Penyedia · Dasbor Penyedia
#2 — Kong AI Gateway
Apa itu. Gerbang AI/LLM perusahaan—tata kelola, plugin/kebijakan, analitik, dan pengamatan untuk lalu lintas AI di tepi. Ini adalah control plane daripada marketplace.
#3 — Portkey
Apa itu. Gerbang AI yang menekankan pada pembatasan, tata kelola, dan pengamatan mendalam—populer di lingkungan yang diatur.
#4 — OpenRouter
Apa itu. API terpadu di atas banyak model; sangat baik untuk eksperimen cepat di katalog yang luas.
#5 — Eden AI
Apa itu. Menggabungkan LLM ditambah AI yang lebih luas (gambar, terjemahan, TTS), dengan fallback/caching dan batching.
#6 — LiteLLM
Apa itu. SDK Python ringan + proxy yang dapat di-host sendiri yang menggunakan antarmuka kompatibel OpenAI untuk banyak penyedia.
#7 — Unify
Apa itu. Routing berbasis evaluasi dan perbandingan model untuk memilih model yang lebih baik per prompt.
#8 — Orq AI
Apa itu. Platform orkestrasi/kolaborasi yang membantu tim beralih dari eksperimen ke produksi dengan alur kode rendah.
#9 — Apigee (dengan LLM di belakangnya)
Apa itu. Platform manajemen API yang matang yang dapat Anda tempatkan di depan penyedia LLM untuk menerapkan kebijakan, kunci, dan kuota.
#10 — NGINX
Apa itu. Gunakan NGINX untuk membangun routing khusus, penegakan token, dan caching untuk backend LLM jika Anda lebih suka kontrol DIY.
Ini adalah ringkasan arah untuk membantu Anda membuat daftar pendek. Untuk katalog model, harga langsung, atau karakteristik penyedia, telusuri marketplace ShareAI dan arahkan berdasarkan waktu nyata harga/latensi/waktu aktif/ketersediaan.
AWS AppSync vs ShareAI
Jika Anda membutuhkan satu API di atas banyak penyedia dengan harga/transparansi/latensi/waktu aktif dan failover instan, pilih ShareAI. Jika kebutuhan utama Anda adalah tata kelola egress dan AWS-native GraphQL dengan langganan real-time, AppSync cocok untuk itu—terutama saat menghadapi Amazon Bedrock beban kerja. Banyak tim memasangkan mereka: gateway untuk kebijakan organisasi + ShareAI untuk routing marketplace.
Perbandingan cepat
Platform
Siapa yang dilayani
Luasnya model
Tata kelola & keamanan
Observabilitas
Routing / failover
Transparansi pasar
Program penyedia
ShareAI
Tim produk/platform yang membutuhkan satu API + ekonomi yang adil
150+ model, banyak penyedia
Kunci API & kontrol per rute
Penggunaan konsol + statistik marketplace
Routing cerdas + failover instan
Ya (harga, latensi, uptime, ketersediaan, jenis penyedia)
Ya — pasokan terbuka; 70% ke penyedia
AWS AppSync
Tim yang menginginkan AWS-native GraphQL + real-time + integrasi Bedrock
Bawa Sendiri (Bedrock, layanan data AWS)
Otorisasi/kunci terpusat di AWS
Pola yang ramah CloudWatch/OTel
Fan-out bersyarat melalui resolver/langganan
Tidak (alat infrastruktur, bukan marketplace)
t/a
Kong AI Gateway
Perusahaan yang membutuhkan kebijakan tingkat gateway
Bawa Sendiri
Kebijakan/plugin edge yang kuat
Analitik
Proxy/plugin, pengulangan
Tidak (infra)
t/a
OpenRouter
Pengembang yang menginginkan satu kunci untuk banyak model
Katalog luas
Kontrol API dasar
Sisi aplikasi
Cadangan
Parsial
t/a
(Tabel yang diringkas. Gunakan marketplace ShareAI untuk membandingkan secara langsung harga/latensi/ketersediaan di berbagai penyedia.)
Harga & TCO: bandingkan nyata biaya (bukan hanya harga satuan)
Token mentah $/1K menyembunyikan realitas. TCO bergeser dengan pengulangan/cadangan, latensi (mempengaruhi penggunaan), variasi penyedia, penyimpanan observabilitas, dan evaluasi berjalan. A pasar yang transparan membantu Anda memilih rute yang menyeimbangkan biaya dan UX.
Prototipe (~10k token/hari): optimalkan untuk waktu-ke-token-pertama (Playground, quickstarts).
Skala menengah (~2M token/hari): pengalihan/cadangan yang dipandu pasar dapat memangkas 10–20% sambil meningkatkan UX.
Beban kerja yang tidak stabil: harapkan biaya token efektif yang lebih tinggi dari pengulangan selama failover; anggarkan untuk itu.
Catatan migrasi: memindahkan ke ShareAI
Dari AWS AppSync (sebagai gateway untuk Bedrock): Pertahankan kebijakan tingkat gateway di tempat mereka unggul; tambahkan ShareAI 3. untuk routing marketplace + failover instan di berbagai penyedia. Pola: Autentikasi/kebijakan AppSync → Rute per-model ShareAI → ukur statistik marketplace → perketat kebijakan.
Dari OpenRouter: Peta nama model, verifikasi kesesuaian prompt; bayangan 10% lalu lintas dan peningkatan 25% → 50% → 100% selama anggaran latensi/kesalahan bertahan.
Dari LiteLLM: Ganti proxy yang di-host sendiri pada rute produksi yang tidak ingin Anda operasikan; tetap gunakan LiteLLM untuk pengembangan jika diinginkan. Bandingkan overhead operasi vs. manfaat routing terkelola.
Dari Unify / Portkey / Orq / Kong: Tentukan ekspektasi kesetaraan fitur (analitik, pengaman, orkestrasi, plugin). Banyak tim menjalankan hibrida: pertahankan fitur khusus di tempat mereka paling kuat; gunakan ShareAI untuk pilihan penyedia yang transparan dan cadangan.
Panduan cepat pengembang (copy-paste)
Berikut menggunakan Kompatibel dengan OpenAI permukaan. Ganti YOUR_KEY dengan kunci ShareAI Anda—dapatkan satu di Buat API Key. Lihat Referensi API untuk detailnya.
Retensi data: tempat prompt/respons disimpan, berapa lama; default redaksi.
PII & konten sensitif: masking; kontrol akses; perutean regional untuk lokasi data.
Observabilitas: pencatatan prompt/respons; kemampuan untuk memfilter atau menyamarkan; menyebarkan ID jejak secara konsisten.
Respons insiden: jalur eskalasi dan SLA penyedia.
FAQ — AWS AppSync vs pesaing lainnya
AWS AppSync vs ShareAI — mana yang cocok untuk routing multi-penyedia? BagikanAI. Ini dibuat untuk transparansi pasar (harga, latensi, waktu aktif, ketersediaan, jenis penyedia) dan perutean pintar/failover di seluruh banyak penyedia. AppSync adalah AWS-native GraphQL dengan Bedrock integrasi dan langganan. Banyak tim menggunakan keduanya: AppSync untuk GraphQL/kebijakan; ShareAI untuk akses agnostik penyedia dan ketahanan.
AWS AppSync vs OpenRouter — akses multi-model cepat atau kontrol GraphQL? OpenRouter membuat akses multi-model cepat; AppSync memusatkan kebijakan dan langganan GraphQL real-time di AWS. Jika Anda juga ingin transparansi pra-rute dan failover instan lintas penyedia, tambahkan ShareAI di belakang API Anda.
AWS AppSync vs LiteLLM — proxy self-host atau GraphQL yang dikelola? LiteLLM adalah proxy/SDK DIY; AppSync dikelola GraphQL dengan langganan WebSocket dan integrasi sumber data AWS. Untuk yang didorong oleh marketplace pilihan penyedia dan failover, rute melalui ShareAI.
AWS AppSync vs Portkey — siapa yang lebih kuat dalam guardrails? Keduanya menekankan tata kelola; ergonomi berbeda. Jika kebutuhan utama Anda adalah pilihan penyedia yang transparan dan failover di berbagai vendor, tambahkan ShareAI.
AWS AppSync vs Unify — pemilihan berbasis evaluasi vs GraphQL egress? Satukan berfokus pada pemilihan model berbasis evaluasi; AppSync berfokus pada GraphQL egress + integrasi AWS. Untuk satu API di banyak penyedia dengan statistik pasar langsung, pilih ShareAI.
AWS AppSync vs Orq — orkestrasi vs GraphQL? Orq mengorkestrasi alur; AppSync adalah lapisan akses data GraphQL dengan real-time + keterkaitan Bedrock. Gunakan ShareAI untuk pemilihan penyedia yang transparan dan failover.
AWS AppSync vs Apigee — manajemen API vs GraphQL khusus AI? Apigee adalah manajemen API yang luas; AppSync adalah layanan GraphQL AWS dengan langganan dan integrasi layanan AWS. Jika Anda menginginkan akses yang tidak bergantung pada penyedia dengan transparansi pasar, sambungkan ShareAI.
AWS AppSync vs NGINX — DIY vs turnkey? NGINX menawarkan filter dan kebijakan DIY; AppSync menawarkan lapisan GraphQL yang dikelola dengan WebSockets/subscriptions. Untuk menghindari pengaturan tingkat rendah dan tetap mendapatkan pemilihan penyedia yang transparan, rute melalui ShareAI.
AWS AppSync vs Kong AI Gateway — dua gateway Keduanya adalah gateway (kebijakan, plugin, analitik), bukan marketplace. Banyak tim menggabungkan gateway dengan ShareAI 3. untuk routing multi-penyedia yang transparan dan failover.
AWS AppSync vs Apache APISIX — GraphQL vs API gateway APISIX adalah gateway API yang kuat untuk kebijakan dan perutean; AppSync adalah GraphQL yang dikelola untuk data AWS + Bedrock. Untuk netralitas model dan perbandingan harga/latensi/waktu aktif secara langsung, tambahkan ShareAI.
AWS AppSync vs Tyk — mesin kebijakan vs lapisan resolver GraphQL Tyk memusatkan kebijakan/kuota/kunci; AppSync memusatkan GraphQL dan pengiriman waktu nyata. Untuk perutean AI yang tidak bergantung pada penyedia dan failover instan, pilih ShareAI.
AWS AppSync vs Azure API Management — pilihan cloud Azure APIM adalah gateway perusahaan Microsoft; AppSync adalah layanan GraphQL AWS. Jika Anda juga menginginkan AI multi-penyedia dengan transparansi marketplace, gunakan ShareAI.
AWS AppSync vs Gravitee — gateway open-source vs GraphQL yang dikelola Gravitee adalah gateway API dengan kebijakan, analitik, dan acara; AppSync dirancang khusus untuk GraphQL + waktu nyata. Untuk visibilitas harga/latensi/waktu aktif sebelum rute dan failover, tambahkan ShareAI.
Ketika AppSync bersinar (dan ketika tidak)
Bersinar untuk: Tumpukan berbasis AWS yang menginginkan GraphQL, waktu nyata melalui langganan, dan keterkaitan erat Bedrock — semua dalam alur autentikasi/IAM AWS dan CloudWatch/OTel.
Kurang ideal untuk:kasus penggunaan multi-penyedia Routing AI lintas cloud/vendor, perbandingan pra-routing transparan (harga/latensi/waktu aktif), atau otomatis failover di banyak penyedia. Itu adalah ShareAI’jalurnya.
Bagaimana pola AppSync memetakan ke Bedrock (untuk konteks)
Pemanggilan singkat dan sinkron ke model Bedrock langsung dari resolver — bagus untuk respons cepat.
Jangka panjang/streaming: gunakan langganan/WebSocket untuk mengalirkan token secara progresif ke klien; gabungkan dengan backend berbasis peristiwa saat diperlukan.
Coba ShareAI berikutnya
Buka Playground — jalankan permintaan langsung dalam hitungan menit.
Jelajahi Model — bandingkan harga, latensi, ketersediaan.
Masuk / Daftar — Konsol mendeteksi otomatis login atau registrasi.
Cara Memonetisasi Waktu Idle GPU dengan ShareAI
Jika Anda telah membeli GPU yang kuat untuk gaming, AI, atau mining, Anda mungkin pernah bertanya-tanya bagaimana memonetisasi GPU saat Anda tidak menggunakannya. Sebagian besar waktu, perangkat keras Anda hanya menghabiskan listrik dan mengalami depresiasi. ShareAI memungkinkan Anda memonetisasi waktu idle GPU dengan menyewakannya untuk beban kerja inferensi AI, sehingga Anda dibayar untuk “waktu mati” yang biasanya terbuang oleh GPU dan server Anda.
TL;DR: Mengapa Memonetisasi Waktu Mati GPU dengan ShareAI Berhasil
Waktu mati ⇒ uang hilang. GPU konsumen dan pusat data sering kali tidak dimanfaatkan sepenuhnya, terutama di luar jam sibuk.
ShareAI mengumpulkan permintaan dari startup yang membutuhkan inferensi sesuai permintaan dan mengarahkannya ke perangkat keras Anda.
Anda dibayar per token yang disajikan, tanpa harus berurusan dengan DevOps atau menyewakan seluruh mesin kepada orang asing.
Bagaimana ShareAI Mengubah GPU Idle Menjadi Penghasilan (Tanpa Manajemen Server)
ShareAI mengoperasikan jaringan GPU terdesentralisasi yang mencocokkan pekerjaan inferensi waktu nyata ke perangkat yang tersedia. Anda menjalankan agen penyedia ringan; jaringan menangani pengiriman model, perutean, dan failover. Alih-alih mengejar pekerjaan, Anda cukup online saat Anda mau dan mendapatkan penghasilan kapan pun GPU Anda melayani token.
Bayar per token, bukan “sewa perangkat saya”
Penyewaan tradisional mengunci perangkat Anda selama berjam-jam atau berhari-hari—bagus saat sibuk, buruk saat menganggur. ShareAI membalik ini: Anda mendapatkan penghasilan berdasarkan penggunaan, jadi saat permintaan berhenti, eksposur biaya Anda adalah nol. Itu berarti “waktu mati” akhirnya menghasilkan.
Untuk pendiri: Anda membayar per token yang dikonsumsi (tidak ada pengangguran 24/7 pada instance mahal).
Untuk penyedia: Anda menangkap lonjakan permintaan dari banyak pembeli yang tidak akan pernah Anda jangkau sendirian.
Seorang pengembang memanggil ShareAI untuk model (misalnya, model teks keluarga Llama).
Jaringan mengarahkan permintaan ke node yang kompatibel (GPU Anda).
Token mengalir kembali; pembayaran terakumulasi kepada Anda berdasarkan token yang dilayani.
Jika node Anda offline di tengah pekerjaan, failover otomatis menjaga pengguna tetap puas sementara sesi Anda hanya berakhir—tanpa pengawasan manual.
Karena ShareAI mengumpulkan permintaan, GPU Anda dapat tetap sibuk hanya ketika itu masuk akal—tepat saat pembeli membutuhkan throughput dan Anda tersedia.
Langkah-demi-Langkah: Monetisasi GPU dalam Menit (Jalur Penyedia)
Periksa perangkat keras & VRAM 8–24 GB VRAM bekerja untuk banyak model teks; lebih banyak VRAM membuka model/tugas visi yang lebih besar. Termal yang stabil dan uplink yang andal membantu.
Instal agen penyedia Ikuti Panduan Penyedia untuk menginstal, mendaftarkan perangkat Anda, dan melewati pemeriksaan dasar. Dokumen: Panduan Penyedia
Pilih apa yang Anda layani Pilih antrean yang sesuai dengan VRAM Anda (misalnya, model teks 7B/13B, visi ringan). Lebih banyak jendela ketersediaan = lebih banyak penghasilan.
Online dan dapatkan penghasilan Saat Anda tidak bermain game atau melatih secara lokal, aktifkan node Anda secara online dan biarkan ShareAI mengarahkan pekerjaan secara otomatis.
Lacak penghasilan dan waktu aktif Gunakan Dashboard Penyedia (melalui Konsol) untuk memantau sesi, token, dan pembayaran. Konsol (kunci, penggunaan): Buat API Key • Panduan Pengguna: Ikhtisar Konsol
Buku Panduan Optimasi untuk Penyedia
Sesuaikan VRAM dengan antrean: Prioritaskan model yang sesuai dengan nyaman; hindari OOM kasus tepi yang mempersingkat sesi.
Rencanakan jendela ketersediaan: Jika Anda bermain game setiap malam, atur node Anda online selama jam kerja atau semalaman—saat permintaan meningkat.
Stabilitas jaringan penting: Kabel atau Wi-Fi yang solid menjaga throughput tetap stabil dan mengurangi failover.
Termal & daya: Jaga suhu tetap terkendali; clock yang konsisten = penghasilan yang konsisten.
Skalakan: Jika Anda memiliki beberapa GPU atau server kecil, tambahkan secara bertahap untuk menguji termal, kebisingan, dan margin bersih.
Langkah-demi-Langkah: Pendiri Menggunakan ShareAI untuk Inferensi Elastis dan Biaya Rendah (Jalur Pembeli)
Bonus: Jika Anda sudah menjalankan pelatihan di tempat lain, biarkan di sana. Gunakan ShareAI hanya untuk inferensi, mengubah biaya tetap menjadi variabel murni satu.
Pola Arsitektur yang Kami Rekomendasikan
Pelatihan/inferensi hibrida: Tetap lakukan pelatihan di cloud/on-prem pilihan Anda; alihkan inferensi ke ShareAI untuk menyerap lalu lintas pengguna yang tidak stabil.
Mode burst: Jaga agar layanan inti Anda tetap minimal; alihkan kelebihan beban ke ShareAI selama peluncuran dan lonjakan pemasaran.
A/B atau “model roulette”: Arahkan sebagian lalu lintas ke beberapa model terbuka untuk mengoptimalkan biaya/kualitas tanpa menambah armada baru.
Studi Kasus (Penyedia): Dari Gamer Malam → “Waktu Mati” Berbayar”
Profil: • 1× RTX 3080 (10 GB VRAM) di PC rumah. • Pemilik bermain game pukul 19:00–22:00 dan offline beberapa akhir pekan.
Pengaturan: • Agen penyedia terinstal; node diatur online pukul 08:00–18:00 dan 22:30–01:00 (jam kerja hari kerja). • Berlangganan ke antrean teks 7B/13B ; pekerjaan visi sesekali yang sesuai.
Hasil (ilustratif): • Node melayani permintaan siang hari kerja yang stabil ditambah lonjakan larut malam. • Pendapatan mengikuti token yang dilayani, bukan jam kerja, jadi periode pendek dan intens. 1. hitung lebih dari periode idle yang lama. 2. • Setelah bulan ke-1, penyedia menyesuaikan jendela untuk tumpang tindih dengan 3. permintaan puncak jaringan 4. dan meningkatkan pendapatan per jam efektif mereka.
5. Apa yang berubah: 6. • Waktu mati GPU 7. menjadi 8. waktu dibayar 9. • Penggunaan listrik meningkat secara moderat selama jendela aktif, tetapi bersihnya positif karena. 10. komputasi yang digunakan membayar 11. sementara idle tidak. 12. Studi Kasus (Pendiri): Tagihan Inferensi Dipotong dengan Menyesuaikan Biaya dengan Penggunaan.
13. Sebelum:
14. • 2× instance A100 diparkir 24/7 untuk menghindari cold start untuk fitur generatif. • 2× instance A100 diparkir 24/7 untuk menghindari cold start untuk fitur generatif. • Rata-rata pemanfaatan <40%; tagihan tidak peduli—instance tetap berjalan.
Setelah (ShareAI): • Beralih ke bayar-per-token inferensi melalui ShareAI. • Menjaga endpoint internal kecil untuk pekerjaan batch; permintaan interaktif, yang bersifat lonjakan diarahkan ke grid. • Routing failover dan multi-node bawaan mempertahankan SLA.
Hasil: • Biaya inferensi bulanan mengikuti penggunaan, bukan waktu, meningkatkan margin kotor dan membebaskan tim dari perencanaan kapasitas GPU yang konstan.
Pendalaman Ekonomi: Ketika Monetisasi Mengalahkan Hosting DIY
Mengapa aplikasi kecil hancur karena kurang dimanfaatkan
Menjalankan GPU sendiri untuk beban kerja ringan sering berarti membayar untuk jam menganggur. Penyedia API besar menang melalui pengelompokan besar-besaran; ShareAI memberikan efisiensi serupa untuk aplikasi kecil dengan menggabungkan lalu lintas banyak pembeli pada node bersama.
Intuisi titik impas (ilustratif)
Beban ringan: Anda biasanya menghemat dengan bayar per token dibandingkan menyewa GPU penuh 24/7.
Beban sedang: Campur dan sesuaikan—tetapkan baseline kecil, ledakkan sisanya.
Beban berat: Kapasitas khusus bisa masuk akal; banyak tim masih menggunakan ShareAI untuk kelebihan beban atau cakupan regional.
Sensitivitas yang penting
Tingkatan VRAM: VRAM yang lebih besar membuka model yang lebih besar (pekerjaan throughput token lebih tinggi).
Bandwidth & lokalitas: Dekat dengan permintaan = latensi lebih rendah, volume lebih besar untuk node Anda.
Pilihan model: Model yang lebih kecil dan efisien (terkuantisasi/dioptimalkan) sering menghasilkan lebih banyak token per watt—baik untuk kedua belah pihak.
Kepercayaan, Kualitas, dan Kontrol
Isolasi: Pekerjaan didistribusikan melalui runtime ShareAI; bobot model dan penanganan data mengikuti kontrol isolasi jaringan.
Failover secara desain: Jika penyedia terputus di tengah aliran, node lain menyelesaikan pekerjaan—pendiri tidak mengejar insiden, penyedia tidak dihukum karena kejadian normal dalam hidup.
Pelaporan transparan: Penyedia melihat sesi, token, pendapatan; pendiri melihat permintaan, token, pengeluaran.
Pembaruan: Varian model baru/dioptimalkan muncul di marketplace tanpa Anda harus membangun ulang armada Anda.
Bisakah saya bermain game dan menyediakan pada saat yang sama? Anda bisa, tetapi kami merekomendasikan untuk mengubah node Anda offline selama penggunaan lokal intensif untuk menghindari persaingan dan pembatasan.
Bagaimana jika mesin saya offline di tengah pekerjaan? Jaringan beralih ke node lain; Anda hanya berhenti mendapatkan penghasilan untuk sesi itu.
Apakah saya memerlukan jaringan kelas enterprise? Tidak. Koneksi konsumen yang stabil sudah cukup. Jitter yang lebih rendah dan uplink yang lebih tinggi membantu sensitif terhadap latensi antrian.
Model mana yang cocok dengan VRAM 8/12/16/24 GB? Sebagai aturan umum: model teks 7B dalam 8–12 GB, 13B sering lebih suka ≥16 GB, dan model yang lebih besar/vision mendapat manfaat dari 24 GB+.
Bagaimana dan kapan pembayaran dijadwalkan? Pembayaran didasarkan pada token yang dilayani. Atur detail pembayaran Anda di Console; lihat Panduan Penyedia untuk spesifikasi ritme.
Kesimpulan: Infrastruktur AI Berbasis Manusia — Berhenti Membuang Waktu Sia-sia, Mulai Menghasilkan
Memonetisasi GPU 7. menjadi dulunya sulit—baik Anda menyewa seluruh rig atau membangun mini-cloud. ShareAI membuatnya sesederhana menekan tombol: jalankan agen saat Anda bebas, hasilkan dari penggunaan aktual, dan biarkan permintaan global menemukan Anda. Bagi pendiri, ceritanya sama tetapi terbalik: hanya membayar saat pengguna menghasilkan token, bukan untuk GPU diam yang menunggu.
Penyedia: Ubah jam menganggur menjadi penghasilan — mulai dengan Panduan Penyedia.
Pendiri: Kirim inferensi elastis dengan cepat — mulai di Taman bermain, lalu hubungkan API.
Sewa GPU untuk Pelatihan & Inferensi AI: Tren Pasar 2025 dan Revolusi Terdesentralisasi
Diperbarui September 2026
Pada tahun 2025 pasar untuk menyewa GPU untuk AI beralih dari kelangkaan menjadi surplus. Harga menurun, kapasitas meledak, dan jaringan terdesentralisasi mulai mengumpulkan GPU yang tidak digunakan dari ribuan pemilik. Studi kasus ini merangkum apa yang berubah, mengapa hal ini penting bagi startup dan penyedia, serta bagaimana ShareAI mengubah “waktu mati” pada GPU dan server menjadi pendapatan—sambil memberikan tim AI komputasi yang lebih murah dan elastis untuk pelatihan dan inferensi.
Mengapa tim menyewa GPU untuk AI pada tahun 2025
Inferensi dalam skala besar adalah hal yang biasa. Aplikasi GenAI kini melayani jutaan permintaan; jam GPU bergeser dari ledakan pelatihan ke inferensi yang selalu aktif.
Kapasitas melimpah tetapi terfragmentasi. Hyperscalers, cloud spesialis, pasar komunitas, dan jaringan terdesentralisasi semuanya bersaing—baik untuk pembeli, kompleks untuk dinavigasi.
Biaya dan pemanfaatan mendominasi hasil. Ketika model menjadi produk yang kritis, mengurangi biaya GPU sebesar 50–80% atau meningkatkan pemanfaatan sebesar 20–40 poin mengubah perhitungan bisnis secara drastis.
Poin utama: Pemenang pada tahun 2025 bukanlah mereka yang hanya menyewa lebih banyak GPU; mereka adalah yang gunakan menggunakan GPU lebih baik—mengurangi waktu idle, menempatkan beban kerja dekat dengan pengguna, dan menghindari biaya premium lock-in. Jelajahi lanskap model ShareAI untuk merencanakan kombinasi Anda: Jelajahi Model atau coba tes cepat di Taman bermain.
Kesenjangan pemanfaatan yang tersembunyi di dalam setiap kluster GPU
Bahkan di lingkungan dengan pendanaan yang baik, GPU sering kali menganggur diam menunggu persiapan data, I/O penyimpanan, orkestrasi, atau penjadwalan pekerjaan. Gejala umum termasuk pemuat data yang membuat GPU kelaparan, siklus pelatihan yang meledak-ledak yang membuat mesin diam selama berjam-jam atau berhari-hari, dan inferensi yang tidak selalu membutuhkan GPU pelatihan kelas atas—menyebabkan kartu mahal tidak dimanfaatkan sepenuhnya.
Jika Anda menyewa GPU untuk AI cara lama (kluster statis, vendor tunggal, wilayah tetap), Anda membayar untuk waktu menganggur ini—apakah Anda menggunakannya atau tidak.
Apa yang berubah: deflasi harga + grafik pasokan yang lebih luas
Deflasi: Tarif on-demand untuk GPU unggulan turun ke angka satu digit rendah (USD/jam) di banyak platform; spesialis dan kumpulan komunitas sering kali menawarkan harga lebih rendah dari cloud besar.
Pilihan: 100+ penyedia yang layak ditambah jaringan terdesentralisasi menggabungkan operator individu, laboratorium penelitian, dan situs edge.
Elastisitas: Kapasitas kini dapat dikumpulkan dalam waktu singkat—jika penjadwal dan jaringan Anda dapat menemukannya.
Efek bersih: pembeli mendapatkan pengaruh—tetapi hanya jika mereka dapat mengarahkan beban kerja ke kapasitas yang paling sesuai secara real-time. Untuk panduan teknis yang lebih mendalam, lihat Dokumentasi dan Rilis.
Masuk ShareAI: ubah waktu mati menjadi nilai (untuk kedua belah pihak)
Untuk pemilik & penyedia GPU
Monetisasi jendela yang tidak digunakan. Jika GPU H100/A100/konsumen Anda tidak 100% dipesan, ShareAI memungkinkan Anda menjual celah waktu—dari menit hingga bulan—tanpa harus mengikat seluruh mesin secara penuh waktu.
Tetap memiliki kendali penuh. Anda memilih batas harga, jendela ketersediaan, dan beban kerja yang dijalankan.
Dapatkan bayaran untuk apa yang sudah Anda miliki. Anda telah menginvestasikan modal pada perangkat; ShareAI mengubah “waktu mati” menjadi pendapatan yang dapat diprediksi alih-alih depresiasi.
Fakta penyedia: penginstal untuk Windows/Ubuntu/macOS/Docker; penjadwalan ramah waktu idle; penghargaan transparan untuk uptime, keandalan, dan throughput; eksposur preferensial seiring meningkatnya keandalan.
Siap untuk mengatur? Mulailah dengan Panduan Penyedia. Anda juga dapat menyempurnakan Masuk atau Daftar untuk mengakses pengaturan penyedia seperti Rewards, Exchange, dan kebijakan wilayah.
Untuk tim AI (startup, MLE, peneliti)
Efektif lebih rendah $/token dan $/langkah. Penempatan dinamis mendorong pekerjaan yang tidak mendesak atau dapat terganggu ke node dengan biaya lebih rendah; inferensi yang sensitif terhadap latensi diarahkan lebih dekat ke pengguna akhir.
Hibrid secara default. Simpan kapasitas “harus-ada” di tempat yang Anda inginkan; kelebihan dan eksperimen tumpah ke pool terdesentralisasi ShareAI.
Kurang terkunci oleh vendor. Campur dan cocokkan penyedia tanpa menulis ulang stack Anda.
Pemanfaatan dunia nyata yang lebih baik. Orkestrasi kami menargetkan okupansi GPU tinggi (lebih sedikit jeda dari I/O atau penjadwalan), sehingga jam yang Anda beli melakukan lebih banyak pekerjaan.
Bagaimana ShareAI menangkap waktu GPU yang tidak digunakan (di balik layar)
Onboarding pasokan: Penyedia menghubungkan node melalui agen ringan (ramah Kubernetes dan Docker). Node mengiklankan kemampuan, kebijakan, dan lokasi untuk pengaturan rute yang sadar latensi.
Pembentukan permintaan: Beban kerja tiba dengan SLA (latensi, batas harga, keandalan). Pencocok menyusun mikro-pool yang tepat untuk setiap pekerjaan.
Sinyal ekonomi: Lelang terbalik + pembobotan keandalan berarti node yang lebih murah dan lebih andal dipilih terlebih dahulu; penyedia melihat umpan balik langsung dalam tingkat pengisian dan pendapatan.
Maksimalisasi pemanfaatan: Mengisi celah kecil; penempatan yang sadar data untuk menghindari kelaparan GPU; jalur preemption untuk tugas yang dapat terganggu.
Bukti & telemetri: Pernyataan dan telemetri berkelanjutan memverifikasi penyelesaian pekerjaan, waktu aktif, dan integritas perangkat keras—membangun kepercayaan tanpa penjaga gerbang pusat.
Hasil: Pemilik GPU mendapatkan penghasilan selama interval yang seharusnya tidak produktif; penyewa mendapatkan komputasi yang jauh lebih murah tanpa mengorbankan kualitas hasil.
Kapan menyewa GPU untuk AI melalui ShareAI (daftar periksa keputusan)
Anda membutuhkan inferensi yang lebih murah tanpa kompromi SLA.
Anda mengalami kehabisan stok pada penyedia utama Anda.
Pekerjaan Anda bersifat sporadis atau dapat terganggu (LLM yang disesuaikan, inferensi batch, evaluasi, penyapuan hyper-param).
Anda memiliki target latensi regional (AR/VR, UX waktu nyata).
Data Anda sudah terpecah atau dapat di-cache di dekat situs edge.
Tetaplah dengan cloud utama Anda untuk batas kepatuhan yang ketat yang membutuhkan wilayah/spesifikasi tertentu, atau data yang sangat sensitif dan berstatus mendalam yang tidak dapat meninggalkan enclave sempit. Sebagian besar tim menjalankan sebuah hibrida: inti pada utama → elastis/dapat terganggu pada ShareAI. Lihat kami Dokumentasi untuk kebijakan routing dan praktik terbaik.
Ekonomi penyedia: mengapa “waktu mati” menghasilkan
Mengisi celah mikro antara pemesanan dengan pekerjaan pendek.
Penetapan harga dinamis meningkatkan tarif di jendela puncak dan menjaga peralatan tetap menghasilkan di luar puncak.
Reputasi → pendapatan: Skor keandalan yang lebih tinggi membuat node Anda muncul lebih awal dalam pencocokan.
Tidak ada komitmen monolitik: Tawarkan hanya jendela yang Anda inginkan; tetap pertahankan pelanggan utama Anda dan tetap menghasilkan dari sisanya.
Bagi banyak operator, ini mengubah ROI dari “perjuangan panjang menuju titik impas” menjadi hasil bulanan yang stabil—tanpa menambah jumlah tenaga penjualan atau kontrak. Tinjau Panduan Penyedia dan sesuaikan Otorisasi pengaturan untuk Rewards/Exchange untuk mulai menghasilkan di waktu idle.
Kejar lencana: Tingkatkan uptime dan throughput → buka antrean bernilai lebih tinggi.
Gandakan hasil: Gunakan pendapatan untuk lebih banyak node atau peningkatan.
Keamanan & kepercayaan (catatan cepat)
Isolasi runtime melalui container/VM dan sandbox per pekerjaan.
Kontrol data: Penyimpanan terenkripsi, pembersihan memori, kebijakan tanpa-persistensi.
Pernyataan: Sidik jari perangkat keras/driver ditambah bukti eksekusi berbasis telemetri; bukti kriptografi opsional untuk alur sensitif.
Tata Kelola: Aturan transparan untuk peningkatan dan pemotongan dalam kasus penipuan atau pelanggaran kebijakan.
Lensa ROI: seperti apa “baik” itu
Pelatihan: Lebih sedikit jeda idle dan token/detik atau gambar/detik yang lebih baik dengan pengeluaran yang sama—atau throughput yang sama dengan biaya lebih rendah.
Inferensi: Latensi p95 lebih rendah dengan pool regional, dan penghematan 30–70% ketika tier perunggu/perak menyerap lalu lintas yang tidak mendesak.
Penyedia: Hasil yang berarti pada jendela idle, dengan jendela puncak dihargai sesuai pasar dan jendela di luar puncak tetap menghasilkan.
Jalan ke depan
Lengkungan 2025–2030 mendukung hibrida + terdesentralisasi: cloud terpusat untuk baseline dan kepatuhan; ShareAI untuk komputasi elastis, hemat biaya, sadar tepi . Saat lebih banyak pemilik mengadopsi GPU dan lebih banyak tim AI mengadopsi praktik berbasis pemanfaatan, pasar bergerak dari “siapa yang memiliki GPU” ke “siapa yang menggunakan GPU dengan terbaik.” Di situlah ShareAI berada. Pantau terus Rilis untuk pembaruan dan peningkatan saat kami memperluas kapasitas dan fitur.
Pertanyaan yang sering diajukan, dijawab secara singkat
Apakah ini hanya untuk H100/A100? Tidak. Kami mencocokkan berdasarkan beban kerja. Banyak pekerjaan inferensi berjalan dengan baik pada GPU tingkat rendah; lonjakan pelatihan dapat meminta silikon premium.
Bagaimana jika sebuah pekerjaan dihentikan sementara? Anda dapat melarang penghentian sementara atau menandai pekerjaan sebagai dapat dihentikan; harga akan menyesuaikan.
Bisakah saya menyimpan data di wilayah tertentu (misalnya, UE)? Ya—tetapkan persyaratan wilayah dan residensi dalam kebijakan Anda; ShareAI hanya akan mengarahkan ke node yang sesuai.
Saya adalah penyedia dengan jendela kecil (misalnya, malam/akhir pekan). Apakah ini layak? Ya. Waktu mati tersebut adalah slot utama untuk inferensi batch dan evaluasi; ShareAI mengisinya dan membayar Anda. Mulailah dengan Panduan Penyedia dan Masuk atau Daftar.
Tema warna: {theme}TerangGelapSistemArtikel yang cocok: {count}Disalin {identifier}Hapus filter {label}Tanpa serverAksesPenyediaKreatorPelatihanRetensiKantor pusatKluster GPU / Pusat DataKebijakanAkses · DirekomendasikanKreditGunakan kredit ShareAI untuk mendukung pemilik GPU sebagai imbalan atas daya komputasi yang tidak mereka gunakan.Kredit Anda memberikan penghargaan kepada orang dan perusahaan yang berbagi daya komputasi yang tidak terpakai. Kami merekomendasikan opsi ini untuk mendukung penggunaan perangkat keras yang lebih berkelanjutan.ShareAI menggabungkan perlindungan teknis dengan perjanjian penyedia untuk membantu melindungi data Anda.Pertukaran tokenPenyedia ShareAI dapat melayani inferensi untuk orang lain dan mendapatkan token input dan output atas kontribusi mereka. Mereka kemudian dapat menggunakan token tersebut untuk inferensi mereka sendiri saat dibutuhkan.Seperti prosumer energi yang menghasilkan dan mengonsumsi listrik, Anda dapat menjadi AI prosumer: berkontribusi daya komputasi saat tidak digunakan dan menggunakan jaringan saat Anda membutuhkannya.Fakta menarikPada Maret 2025, ShareAI menjadi platform pertama di dunia untuk AI prosumer. Imbangi penggunaan AI Anda sendiri melalui pertukaran token, atau dapatkan pembayaran di akhir bulan melalui kontribusi berbayar.KomunitasPenyedia komunitas adalah individu yang berbagi daya komputasi mereka sebagai imbalan kredit atau token melalui pertukaran token.Mereka memanfaatkan daya komputasi yang tidak terpakai untuk membantu orang lain di seluruh jaringan ShareAI.ShareAI mengambil langkah-langkah untuk melindungi data Anda, dan setiap penyedia, baik Komunitas maupun Perusahaan, menandatangani perjanjian. Untuk beban kerja sensitif, kami merekomendasikan penyedia Perusahaan.PerusahaanSetiap penyedia Perusahaan menandatangani perjanjian yang ketat. Perlindungan ShareAI melampaui kode hingga akuntabilitas dan reputasi perusahaan.Kami meninjau lokasi kantor pusat perusahaan, siapa pendirinya, dan struktur kepemilikannya untuk memahami pemilik manfaat utama di baliknya.Wilayah & data pribadi AndaAturan data pribadi berbeda di setiap negara dan wilayah. Penyedia dapat tetap tunduk pada hukum negara tempat mereka didirikan, bahkan ketika pusat datanya berada di tempat lain.Menyimpan data di wilayah lain tidak secara otomatis menghapus kewajiban tersebut. Aturan di mana data diproses, dan perlindungan yang berlaku untuk Anda, juga dapat berpengaruh.Periksa entitas hukum penyedia, lokasi pemrosesan, dan kebijakan privasi sebelum berbagi data pribadi.Tutup informasi wilayahTutup penjelasanMencari…Jelajahi dokumentasiTidak ada artikel ditemukan. Coba pencarian lain atau basis pengetahuan.Pencarian tidak tersedia. Silakan coba lagi.Tersalin!Halaman tersalin.Gagal menyalinGagal menyalin. Pilih teks halaman untuk menyalinnya secara manual.Salin halamanTautan halaman tersalin.Tidak dapat menyalin tautan. Salin dari bilah alamat.Menyiapkan Markdown…Tidak dapat menyalin. Coba lagi atau buka Lihat sebagai Markdown.Salin pengenalTersalinSalin pengenal modelSalin dari providerSalin awalanSalinan gagal. Pilih prefix untuk menyalinnya secara manual.Identifier model telah disalinDisalin {prefix}. Tambahkan identifier model setelah garis miring.Tidak dapat menyalin. Pilih identifier ini: {identifier}Verifikasi tidak dapat dimuat. Silakan coba lagi atau buka tiket dari akun ShareAI Anda.Verifikasi tidak dapat dimuat. Silakan coba lagi.Silakan selesaikan verifikasi sebelum mengirim pesan Anda.Pesan Anda telah dikirim. Terima kasih — tim ShareAI akan membalas melalui email.Kami tidak dapat mengonfirmasi pengiriman. Silakan periksa koneksi Anda sebelum mencoba lagi.Mengirim…Kami tidak dapat mengirim pesan Anda. Silakan coba lagi.Silakan kirim formulir ini dari ShareAI.Pesan Anda terlalu panjang. Harap batasi hingga 10.000 karakter.Silakan masukkan alamat email yang valid.Masukkan alamat email yang valid.Silakan masukkan pesan hingga 10.000 karakter.Silakan perpendek nama atau subjek Anda.Silakan selesaikan verifikasi.Selesaikan verifikasi.Silakan periksa kolom ini.Verifikasi gagal. Silakan coba lagi.Silakan periksa detail Anda dan coba lagi.Kami tidak dapat mengonfirmasi pengiriman. Silakan coba lagi nanti atau buka tiket dukungan.{date}: {uptime}. Online {online}, offline {offline}, tidak teramati {unknown}.Tidak ada pengamatanWaktu aktif {percent} yang teramatiWaktu aktif {percent}Waktu aktif harian yang teramati dan cakupan rekaman selama {days} hari. Pengamatan yang hilang adalah celah, bukan waktu aktif nol. Gunakan tombol panah atau kontrol detail harian untuk menjelajahi.Cakupan rekamanOnlineOfflineTidak teramatiWaktu aktif yang teramati{percent} dari periode ini tercakupDari waktu yang direkamMenunggu pengamatanTerputus selama pemeriksaanRiwayat belum tersedia{days} hari terakhirRiwayat sedang dibangunTidak ada pengamatan dalam periode ini{date} adalah hari pertama yang direkam dalam tampilan ini.Pemeriksaan yang direkam akan muncul di sini saat tiba.Menampilkan {days} hari terakhir. {details}Online teramatiOffline teramatiTutup navigasiBuka navigasiGunakan formulir untuk mengirim pesan Anda.Formulir tidak ditemukan.Data formulir tidak didukung.Data formulir tidak valid.Kami tidak dapat mengirimkan aplikasi Anda. Jawaban Anda masih ada di sini—silakan coba lagi.Mengirimkan aplikasi Anda…Aplikasi diterima.Terima kasih telah membagikan proyek Anda. Kami akan meninjaunya dan menghubungi Anda mengenai kecocokan dan langkah selanjutnya.Ajukan untuk pilot €250Pilot Open Source · kredit €250Salin JSON routingJSON routing berhasil disalinTidak dapat menyalin. Pilih JSON routing untuk menyalinnya secara manual.Permintaan cURL disalinIsi permintaan disalinTidak dapat menyalin. Pilih endpoint, header, dan isi untuk menyalinnya secara manual.Tidak dapat menyalin. Pilih isi permintaan untuk menyalinnya secara manual.